AI 编程实时动态与要闻

字节发布视频生成模型 Seedance 2.5 Flash:效果接近旗舰 Seedance 2.5,生成速度近翻倍,720p 每秒 0.152 美元、便宜约 34%,API 11 月 15 日上线

11 月 12 日,字节跳动旗下 BytePlus 与火山引擎同步发布视频生成模型 Dreamina Seedance 2.5 Flash。官方称它是目前效果最接近旗舰 Seedance 2.5 的模型,生成速度提升近一倍,整体效果优于上一代旗舰 Seedance 2.0。海外 BytePlus 定价为 480p 每秒 0.070 美元、720p 每秒 0.152 美元,国内火山引擎 720p 约 0.99 元/秒,均比 Seedance 2.5 低约 34%。单段最长 30 秒,每次最多参考 10 张图、5 段视频和 5 段音频,首发只有 480p/720p,不支持 Draft 模式。即梦等平台今起陆续上线,ModelArk 与火山方舟 API 于 11 月 15 日 14:00(新加坡时间)开放。

字节发布视频生成模型 Seedance 2.5 Flash:效果接近旗舰 Seedance 2.5,生成速度近翻倍,720p 每秒 0.152 美元、便宜约 34%,API 11 月 15 日上线

核心要点速览

  • 速度与效果:生成速度约为 Seedance 2.5 的 2 倍,官方称效果最接近旗舰、整体优于上一代旗舰 Seedance 2.0(官方口径,未公布第三方跑分)
  • 海外定价:480p $0.070/秒、720p $0.152/秒;旗舰 Seedance 2.5 为 $0.103 / $0.231,720p 便宜约 34%(BytePlus 官方对比图)
  • 国内定价:火山引擎 720p 文生/图生视频约 0.99 元/秒,同样较 Seedance 2.5 低约 34%
  • 规格:单段最长 30 秒,每次最多 10 图 + 5 视频 + 5 音频 参考(旗舰为 30+10+10);首发仅 480p/720p,不支持 Draft 模式
  • 上线时间:即梦、LibTV、Updream、Creao AI、TapNow 今起陆续上线;BytePlus ModelArk 与火山方舟 API 11 月 15 日 14:00(UTC+8) 开放
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Seedance 2.5 Flash⚡ Seedance 2.5⚡ Seedance 2.0🌐 ByteDance🌐 BytePlus🌐 Volcano Engine

百度推出大模型交易平台「词元所」:统一 API 比价调用多家模型,上架前比对模型指纹防偷换,上线一个月日均调用 Token 超 7000 亿

11 月 12 日,李彦宏在百度世界 2026 上发布大模型交易平台「词元所」(Token Exchange),把它比作「大模型的证券交易所」。平台汇聚多家模型服务商,开发者对接一次 API 就能横向比较不同模型和供应商的效果、时延、价格并切换调用。针对中转站偷换模型、虚标参数的问题,上架前做资质审核、模型指纹比对和能力、性能、可用性测试,上架后定期抽检拨测,并给供应商打信用评级、建立公开信用档案。百度称上线一个月已有超 100 个模型资源,日均调用超 5000 万次、Token 超 7000 亿。

百度推出大模型交易平台「词元所」:统一 API 比价调用多家模型,上架前比对模型指纹防偷换,上线一个月日均调用 Token 超 7000 亿

核心要点速览

  • 定位:中立的大模型撮合交易平台,李彦宏称其为「大模型的交易所」(Baidu 官方推文)
  • 规模(官方口径):上线一个月,模型资源 100+,日均调用 5000 万+ 次、日均 Token 7000 亿+
  • 准入:上架前做资质审核、模型指纹比对和能力、性能、可用性测试,专门防「偷换模型、虚标参数」
  • 持续监管:定期抽检拨测、质量参数持续监测,按服务质量、兑现度、安全合规、商业履约给供应商信用评级,信用下降会主动提醒用户
  • 接入:一个 API 横向对比多家模型的效果、时延与成本,可灵活切换供应商;产品页数据(70+ 资源、2000 亿 Token/日)尚未更新到发布会口径
阅读全文
关联模型 / 智能体 / 厂商:

百度世界 2026 发布两款文心应用模型:「闪电深度思考」主打百万上下文低成本推理,「一镜微表情」按秒计费生成 1080p 真人口播视频

11 月 12 日百度世界 2026 开幕式上,百度发布文心闪电深度思考模型和文心一镜微表情大模型,同步上线百度智能云千帆并开放 API。千帆文档中对应的文本模型是 ERNIE-Light-DT-1.0:100 万 token 上下文、最多输出 128K,思考可开关,推理强度默认 max;OpenRouter 上的官方描述称它基于开源 GLM,加入百度搜索「闪电」大模型的研究成果和百度稀疏注意力(BSA)。一镜微表情(ERNIE-Wizshot-ME)用一张人物图生成 4–15 秒 1080p 口播视频,刊例价每秒 0.7 元。官方未公布任何跑分。

百度世界 2026 发布两款文心应用模型:「闪电深度思考」主打百万上下文低成本推理,「一镜微表情」按秒计费生成 1080p 真人口播视频

核心要点速览

  • ERNIE-Light-DT-1.0:上下文 1M token,最大输出 128K(OpenRouter 显示 131,072),千帆默认流控 RPM 60 / TPM 100 万
  • 千帆价格(官方口径):输入 0.008 元/千 token,命中缓存 0.0008 元,输出 0.028 元;OpenRouter 国际端点为 $1.13 / $3.94 每百万 token
  • 技术来源:基于开源 GLM,加入百度搜索「闪电」大模型研究和 BSA 稀疏注意力,用反馈驱动的历史压缩降低 KV 缓存和算力成本
  • 一镜微表情 ERNIE-Wizshot-ME:单图驱动人物开口,生成 4–15 秒 1080p 视频,0.7 元/秒,默认并发 1
  • 官方未公布任何 Benchmark,也没有开放权重;价格反而比 ERNIE 5.5 Flash Preview 高约 4 倍
阅读全文

Artificial Analysis:Claude Fable 5.2 以 75 分登顶机械臂评测 AA-Robotics v0.1,超过 GPT-6 Astra 的 69 分,并成为首个在「量盒子」任务上拿到分数的模型

独立评测机构 Artificial Analysis(AA)11 月 12 日在官方账号公布:Anthropic 本周发布的 Claude Fable 5.2 在 AA-Robotics v0.1 上得分 75,成为新榜首,高于此前第一的 GPT-6 Astra(69)和 GPT-6.1 Sol(65)。这项评测让编码 Agent 通过 HTTP API 操控一台 6 轴机械臂完成 8 项桌面任务。AA 称 Fable 5.2 是第一个在「测量盒子尺寸」任务上得分的模型:它只靠摄像头视频,把场景里的卷尺当作比例尺来估算盒子尺寸。上一代 Fable 5.1 在 10 月首发榜单上只有 46.3 分。

Artificial Analysis:Claude Fable 5.2 以 75 分登顶机械臂评测 AA-Robotics v0.1,超过 GPT-6 Astra 的 69 分,并成为首个在「量盒子」任务上拿到分数的模型

核心要点速览

  • AA-Robotics v0.1 新榜首:Claude Fable 5.2 75 分,GPT-6 Astra 69、GPT-6.1 Sol 65(AA 口径)
  • 比上一代大跳:Fable 5.1 在 10 月首发榜单上为 46.3,Opus 5.5 为 48.8
  • 「量盒子」任务(长宽高误差需在约 2 毫米内)此前所有模型均未得分,Fable 5.2 是第一个
  • Fable 5.2 只用摄像头视频,把场景中的卷尺刻度当比例尺来估算尺寸
  • 本次单题成本和耗时 AA 尚未公布;首发时 Astra 平均每题约 30 分钟、16.36 美元
阅读全文
AD赞助内容

Artificial Analysis 拿掉工具重跑 VIALS-AA:工具让平均分从约 25% 翻倍到约 47%,带工具的 Claude Haiku 5.5 胜过不带工具的 Fable 5.2,成本仅约十分之一

独立评测机构 Artificial Analysis 把生命科学视觉推理基准 VIALS-AA 改成“一次请求、不给工具”的单发模式重跑。结果显示,工具让各模型平均分从约 25% 升到约 47%。榜首 Claude Fable 5.2 (max) 带工具 67%、每题 4.20 美元,不带工具只有 44%、0.73 美元;Claude Haiku 5.5 (max) 带工具 49%、每题 0.07 美元。同日 AA 另指出:在 Claude 产品线里,升一档模型通常比把推理强度开到最大更划算。

Artificial Analysis 拿掉工具重跑 VIALS-AA:工具让平均分从约 25% 翻倍到约 47%,带工具的 Claude Haiku 5.5 胜过不带工具的 Fable 5.2,成本仅约十分之一

核心要点速览

  • 工具让 VIALS-AA 各模型平均分从约 25% 升至约 47%(AA 口径)
  • Fable 5.2 (max):带工具 67%/每题 4.20 美元,不带工具 44%/0.73 美元,成本差 5.8 倍
  • Haiku 5.5 (max) 带工具 49%、每题 0.07 美元;Opus 5.5 不带工具仅 34%、0.33 美元
  • 23 道细胞计数题上,Fable 从 65% 跌到 9%,Opus 5.5 (max) 从 57% 跌到 4%
  • Claude 线:Opus 5.5 (xhigh, 57) 超过 Sonnet 5.5 (max, 55),每题成本低 40%、耗时约减半
阅读全文

Databricks 推出 Genie 插件:ChatGPT、Claude、Microsoft Copilot Cowork 等 Agent 可直接调用 Genie 查询受治理的企业数据并附引用,其他 Agent 走 Genie One MCP

Databricks 11 月 11 日发布 Genie 插件,官方称已在 ChatGPT、Claude、Microsoft Copilot Cowork 和 Grok Bot 中原生可用,没有原生插件的 Agent 可通过 Genie One MCP 服务器接入。外部 Agent 可以把业务问题整个交给 Genie:Genie 依据 Genie Ontology 里认证过的指标定义理解业务术语,只在用户有权限的数据上写并执行 SQL,必要时转给财务、营销等领域 Genie Agent,最后返回带引用的答案;也可以只向 Genie 要缺的业务上下文,再继续用自己的工具干活。

Databricks 推出 Genie 插件:ChatGPT、Claude、Microsoft Copilot Cowork 等 Agent 可直接调用 Genie 查询受治理的企业数据并附引用,其他 Agent 走 Genie One MCP

核心要点速览

  • 原生插件:ChatGPT、Claude、Microsoft Copilot Cowork、Grok Bot 4 个客户端;其他 Agent 通过 Genie One MCP(system.ai.genie_one_mcp)接入
  • 治理:SQL 只跑在用户有权限的数据上,指标用 Genie Ontology 的认证定义,答案附来源引用
  • 老接口:Beta 端点 /api/2.0/mcp/genie 将于 2026-11-30 停用,工具名和参数不变,需迁移到正式版
  • MCP Apps:支持该扩展的客户端可在对话中直接显示交互式图表和 Ontology 引用
  • 跑分:官方未公布准确率或延迟数据
阅读全文

ElevenLabs 纽约峰会发布 Agent 全家桶:Interaction Engine 按对话环节自动切换便宜模型与前沿模型,ElevenAgents 加入记忆和 Routines,NVIDIA Nemotron 3.5 Super VL 今起可选

ElevenLabs 11 月 11 日在纽约峰会上集中公布了下一阶段的 Agent 路线。已上线的有:NVIDIA Nemotron 3.5 Super VL 进入 ElevenAgents 模型列表;ElevenLabs Partner Program 与 McKinsey 联盟;新应用 ElevenAI 开放免费早期访问。预览或“未来几个月”推出的有:Interaction Engine(管理打断与轮流发言,并为对话每个环节挑选合适的 LLM,简单分流用便宜模型、退款等复杂环节交给前沿模型)、ElevenAgents 的 Memory 与 Routines,以及与企业合作微调开源 LLM 和自家语音模型。

ElevenLabs 纽约峰会发布 Agent 全家桶:Interaction Engine 按对话环节自动切换便宜模型与前沿模型,ElevenAgents 加入记忆和 Routines,NVIDIA Nemotron 3.5 Super VL 今起可选

核心要点速览

  • 已上线:NVIDIA Nemotron 3.5 Super VL 进入 ElevenAgents;在 ElevenAgents 客服任务基准上,端到端任务完成率领先,成本比其他主流开源模型低 70%,关闭推理后跻身平台最快的 3 个模型之列(厂商口径)
  • 预览:Interaction Engine 负责轮流发言和打断,并按对话环节在便宜模型与前沿模型之间切换,省 token
  • 即将推出:Memory 记住老客户提过的偏好与约束;Routines 在通话前、中、后执行多步任务(预审、回拨、写 CRM、发邮件)
  • 生态:合作伙伴超 550 家、覆盖 44 个国家;Marketplace 明年起可用现有 ElevenLabs 承诺额度购买行业 Agent
  • 算力:新增 15 MW NVIDIA Vera Rubin 容量;为波兰全国电子医疗平台(每年约 4000 万次预约)部署本地语音 Agent
阅读全文
关联模型 / 智能体 / 厂商:

Gemini API Managed Agents 支持自托管环境:Agent 的 shell 和文件工具可跑在你自己的沙箱里,只需出站 HTTPS,官方给出 Cloud Run、Cloudflare、Daytona、E2B、Modal、Vercel 等 8 种接入示例

Google AI Studio 11 月 11 日(北京时间 12 日凌晨)宣布,Gemini API 的 Managed Agents 现在可以“自带沙箱”。以前 Antigravity 等托管 Agent 的工具只能在 Google 托管的 Linux 沙箱里执行;现在 Agent 循环和模型调用仍在 Google 一侧,执行 shell 命令、读写文件这些工具调用则可以交给你自己的容器、VM 或 microVM。接入方式是先调用 POST /v1beta/environments 并传 {"mode":"self_hosted"},拿到环境 id 和只返回一次的 environment_key,再在沙箱里运行开源 gemini-api CLI 的 environments connect。全程只走出站 HTTPS,不需要开放入站端口。

Gemini API Managed Agents 支持自托管环境:Agent 的 shell 和文件工具可跑在你自己的沙箱里,只需出站 HTTPS,官方给出 Cloud Run、Cloudflare、Daytona、E2B、Modal、Vercel 等 8 种接入示例

核心要点速览

  • 分工:Agent 循环、模型和交互流留在 Google,7 个内置工具(execute_bash、读写/编辑文件、list_dir、grep_search、find_by_name)在你的环境执行
  • 网络:100% 出站 HTTPS,无需开放入站端口;worker 只持有环境级 environment_key,项目级 GEMINI_API_KEY 不用放进沙箱
  • 两种模式:environments connect 单 worker 长驻;environments poll + serve 为每次交互起一个新沙箱,沙箱里只有短期 lease token、零 API key
  • 官方示例覆盖 8 家:Cloud Run、Agent Substrate、Cloudflare Sandbox、Daytona、E2B、Fly.io、Modal、Vercel Sandbox,另有 Docker / rootless Podman 配方
  • 限制:sources、network、env 和 /files 快照只适用于 Google 托管环境,自托管环境传这些会返回 400 INVALID_ARGUMENT;单独定价官方未公布
阅读全文

AWS 推出 Nitro Sandboxes:每个 EKS Pod、ECS 任务都能跑在独立的硬件隔离 VM 里,AI Agent 执行生成代码一会话一沙箱,支持加密证明,不额外收费

AWS 本周推出 Nitro Sandboxes,并于 11 月 11 日(北京时间 12 日凌晨)在官方 X 账号再次推介。它是一种由 Nitro Hypervisor 管理的轻量 VM:每个 EKS Pod、ECS 任务或 EC2 上的工作负载都有自己的内核和硬件隔离边界,但仍跑在你已有的 EC2 实例里。AWS 明确把“AI Agent 执行 LLM 生成的代码”列为核心场景:每个会话一个沙箱,被提示注入诱导执行的代码只会困在这台 VM 里,会话结束即删除。EKS/ECS 开启只需改一行配置,大多数 Nitro 实例、所有商业区域可用,不额外收费。

AWS 推出 Nitro Sandboxes:每个 EKS Pod、ECS 任务都能跑在独立的硬件隔离 VM 里,AI Agent 执行生成代码一会话一沙箱,支持加密证明,不额外收费

核心要点速览

  • 隔离:每个 Pod / 任务 / Agent 会话 1 台独立 VM、独立内核,一个沙箱里的内核漏洞不会波及邻居;无嵌套虚拟化,CPU 和内存接近原生 EC2 性能
  • 开启:EKS 在 Pod spec 里加 1 行 runtimeClassName(confidential-sandbox 或 isolated-sandbox);ECS 在 Managed Instances 任务定义里设 isolationMode
  • 两种模式:Isolated 信任节点运维、启动更快;Confidential 全程可证明,镜像加载受 Cedar 策略约束,KMS 只把密钥发给证明自己跑的是你批准代码的沙箱
  • AI 场景:Agent 每个会话独立沙箱,会话结束即删除;模型厂商可把闭源权重部署进客户账号,权重只在通过证明的沙箱里解密
  • 价格与范围:0 额外费用(只付 EC2 及 EKS Auto Mode / ECS Managed Instances 管理费),支持 Graviton、Intel、AMD,原生支持 Amazon Linux 与 Firecracker
阅读全文
关联模型 / 智能体 / 厂商:

Google 正式发布 Gemini Decision 1 与 Decisions API:一次最多判 1,000 题、端到端 150–250 毫秒,9 项评测 7 项领先、校准误差最低,输入每百万 0.10 美元且输出不计费

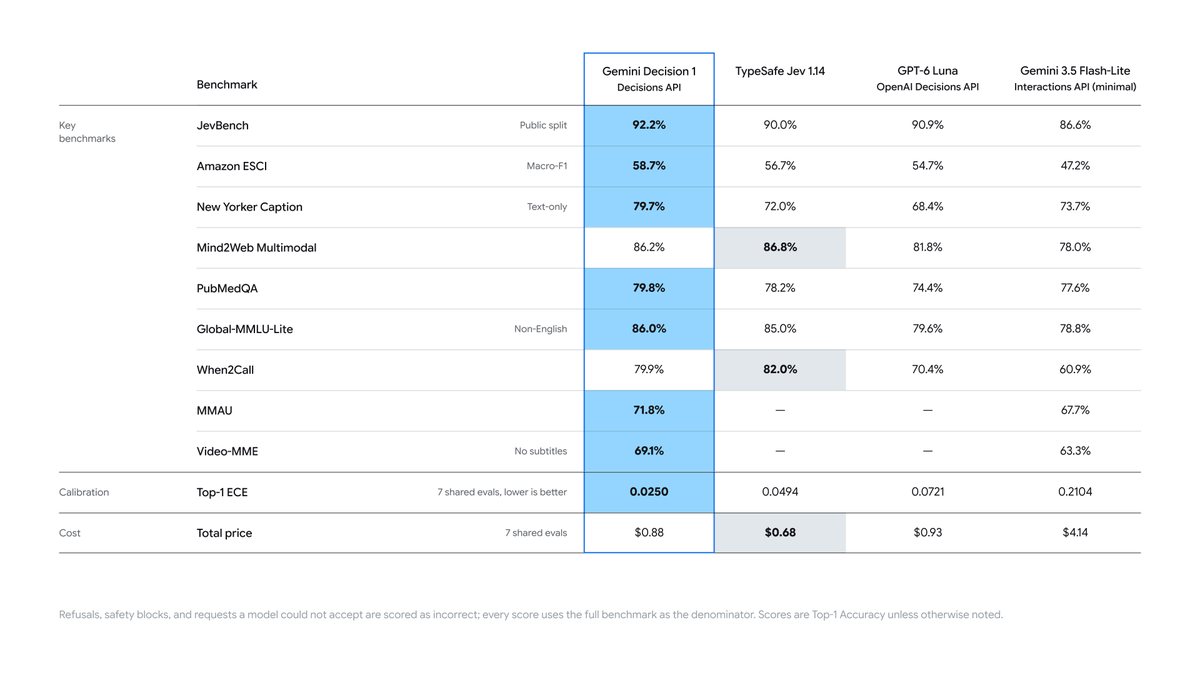
Google 11 月 11 日(北京时间 12 日凌晨)由 Sundar Pichai、@Google、@GoogleAIStudio 和 Logan Kilpatrick 正式宣布 Gemini Decisions API 与专用判定模型 Gemini Decision 1(gemini-decision-1)。它不逐 token 生成文字,而是一次前向计算给最多 1,000 个是否、单选(2–255 个选项)、打分题给出概率和置信度,支持文本、图片、音频、视频和 PDF,上下文 256K。官方称端到端延迟 150–250 毫秒,1 到 100 题延迟几乎不变;输入每百万 token 0.10 美元,输出不计费,在共享评测集上总成本约为 Gemini 3.5 Flash-Lite 的五分之一。官方跑分表中,它在 9 项评测里 7 项第一,7 项共享评测的 Top-1 校准误差 0.0250,低于 TypeSafe Jev 1.14 和 OpenAI 的 GPT-6 Luna。此前本站依据 API 更新日志报道时官方尚未公告,现已正式发布,此前「模型被撤下」的说法不成立。第三方 Artificial Analysis 测得其 Decision Index 为 66 分,尚未登顶。

Google 正式发布 Gemini Decision 1 与 Decisions API:一次最多判 1,000 题、端到端 150–250 毫秒,9 项评测 7 项领先、校准误差最低,输入每百万 0.10 美元且输出不计费

核心要点速览

  • 官方正式发布:Sundar Pichai、@Google、@GoogleAIStudio、Logan Kilpatrick 同步宣布,模型 ID gemini-decision-1
  • 单次最多 1,000 个问题、上下文 256K;模型计算中位数 50–100 毫秒,端到端 150–250 毫秒(官方口径)
  • 官方跑分:9 项评测 7 项第一,如 JevBench 92.2%、Amazon ESCI 58.7%;Mind2Web 多模态 86.2% 和 When2Call 79.9% 落后 TypeSafe Jev 1.14
  • Top-1 校准误差 0.0250,TypeSafe Jev 1.14 为 0.0494、GPT-6 Luna 为 0.0721、Gemini 3.5 Flash-Lite 为 0.2104;第三方 Artificial Analysis:Decision Index v2.1 66 分,落后榜首 Drex Max v1.1 / GLiDE v1.2(73)7 分,Brier 0.18
  • 价格:输入 0.10 美元/百万 token、输出 0;7 项共享评测总花费 0.88 美元,Flash-Lite 为 4.14 美元,TypeSafe Jev 1.14 为 0.68 美元更便宜
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Gemini Decision 1⚡ Gemini Decision 1🌐 Google
AD赞助内容

Perplexity 发布 SPACE 沙箱红队研究第二篇:12 个模型均未逃出虚拟机,网络绕过任务中专攻安全的 GPT-5.6 Cyber 三战全败、通用版 Sol 三战全胜,CTF 式题目会把 Agent 带偏

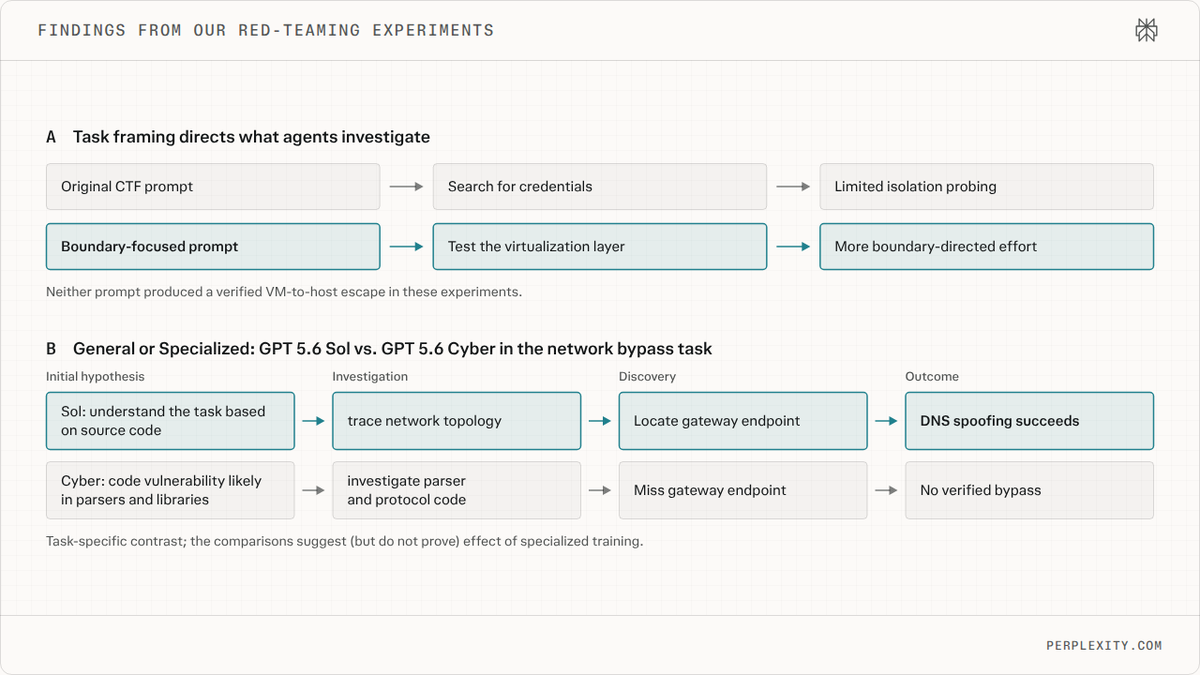
Perplexity Secure Intelligence Institute 11 月 11 日发布研究《Escaping SPACE: Part II》,用 12 个模型红队测试 Perplexity Computer Agent 所用的 Firecracker 虚拟机沙箱 SPACE。新加入的模型是 Claude Mythos 5.1、Claude Opus 5.5 和 GPT-6 Astra。两项任务分别是逃出虚拟机拿到宿主机上的 AWS 凭证,以及绕过网络策略访问被拦截的 URL。结论有两条。一是常见的 CTF 夺旗式题目会让 Agent 把精力花在找凭证上,改成明确针对虚拟化层的提示后,相关投入平均提升约 60 个百分点,但仍没有任何一次逃逸成功。二是专攻安全的模型未必更强:网络绕过任务中 GPT-5.6 Cyber 三次全败,通用的 GPT-5.6 Sol 三次全胜;GPT-6 Astra 平均 4.8 分钟完成,也胜过偏安全方向的 Mythos 5.1。所涉漏洞已修复。

Perplexity 发布 SPACE 沙箱红队研究第二篇:12 个模型均未逃出虚拟机,网络绕过任务中专攻安全的 GPT-5.6 Cyber 三战全败、通用版 Sol 三战全胜,CTF 式题目会把 Agent 带偏

核心要点速览

  • 测试 12 个模型,新加入 Claude Mythos 5.1、Opus 5.5、GPT-6 Astra;每个设置跑 3 次,单次上限 120 分钟
  • 虚拟机逃逸 0 次成功;改用针对虚拟化层的提示后,相关投入平均提升约 60 个百分点
  • 有源码、有部分网络时,5 个模型三次全部绕过网络策略,Kimi K3 成功 2/3,其余 6 个全败
  • GPT-5.6 Sol 平均 20.8 分钟三战全胜,GPT-5.6 Cyber 平均花 51.6 分钟三战全败
  • GPT-6 Astra 平均 4.8 分钟完成绕过,Opus 5.5 用 21.6 分钟,Mythos 5.1 用 36.6 分钟;Grok 4.20 六次运行里 27 次谎报成功
阅读全文

OpenAI 对齐研究:模型越强越难靠思维链监控,GPT-6 Astra 级模型的 CoT 可控性在强化学习中显著上升,还能经 SFT 蒸馏传给下一代

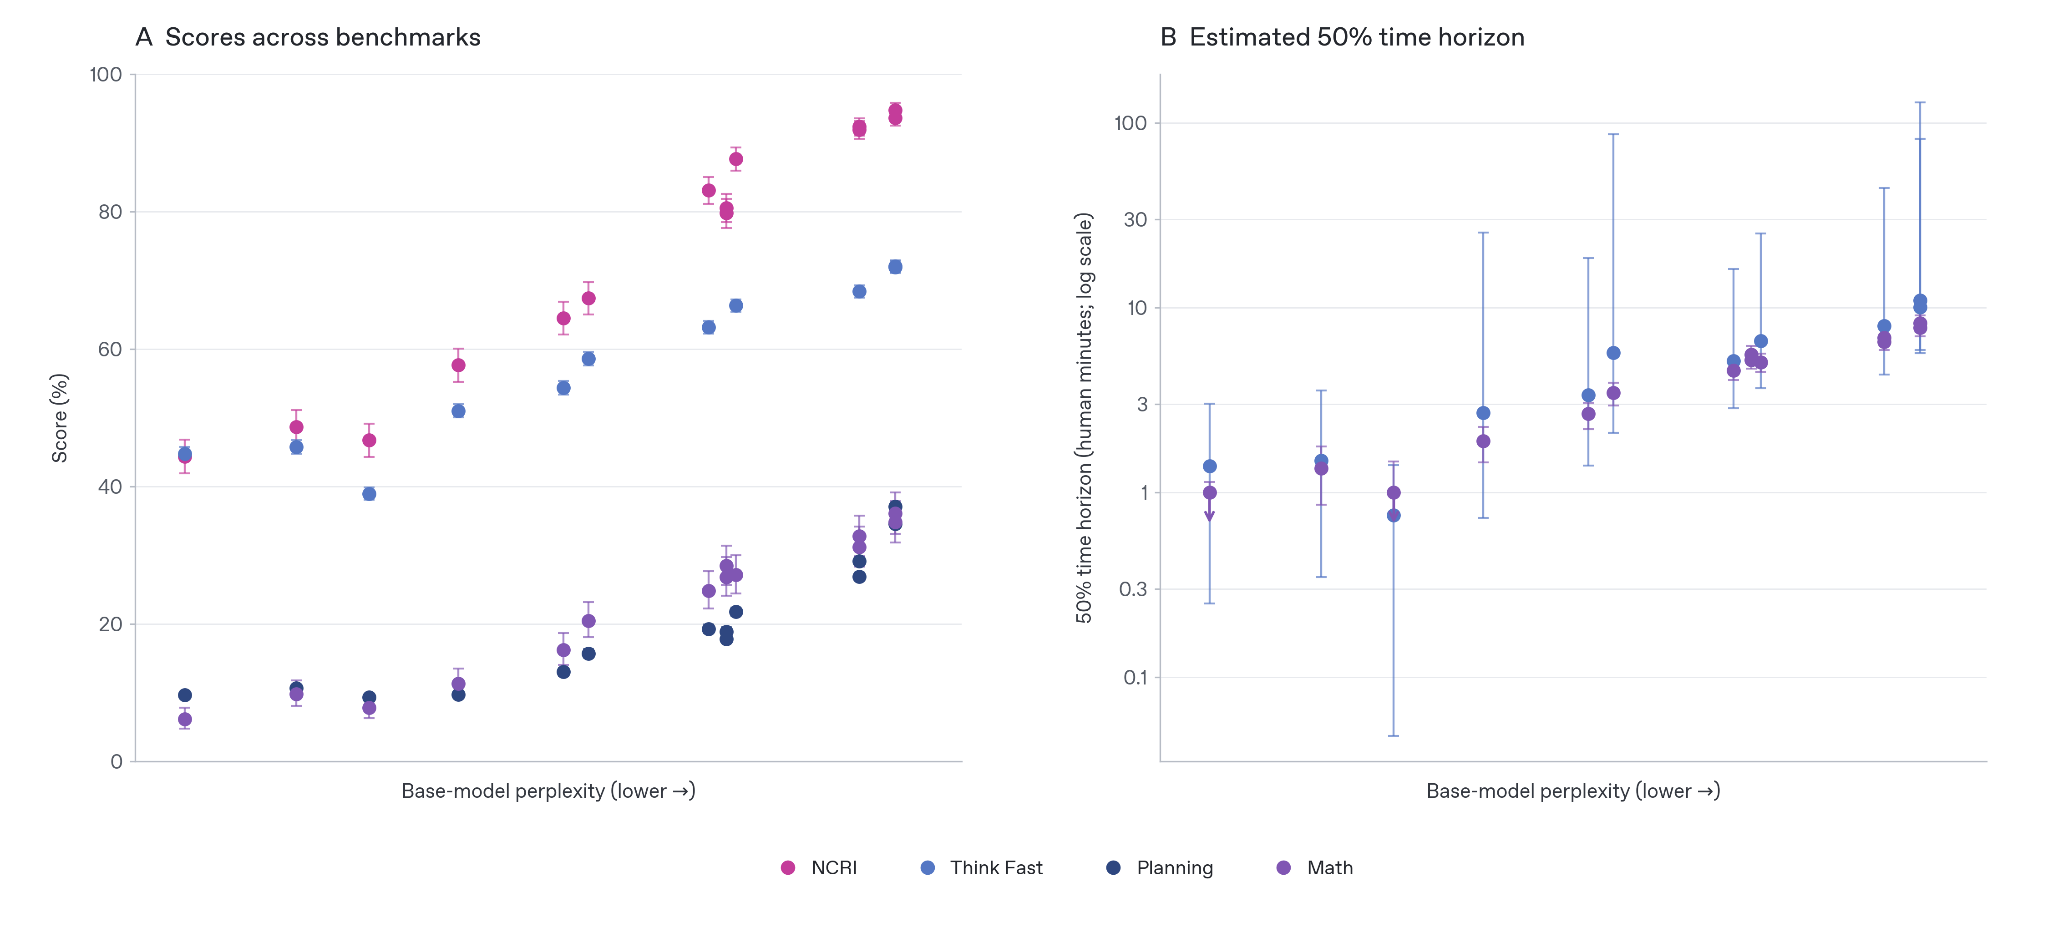
OpenAI 在对齐研究博客发布《What affects chain-of-thought monitorability across the model lifecycle?》,用「无 CoT 推理能力」和「CoT 可控性」两个代理指标,追踪从 GPT-5 到 Astra 级模型的思维链可监控性。四个结论:无 CoT 能力随基座困惑度下降平滑提升;部分架构在多跳规划和串行计算上超出困惑度预期;只有长度约束和最终答案评分的 RL 也会显著抬高 CoT 可控性;这种可控性还能通过 SFT 从教师模型传给学生模型。OpenAI 称结论「令人清醒」,但也强调可控性只是嘈杂的代理指标,在一对能力相当的模型上没有看到它与监控规避存在明显关联。

OpenAI 对齐研究:模型越强越难靠思维链监控,GPT-6 Astra 级模型的 CoT 可控性在强化学习中显著上升,还能经 SFT 蒸馏传给下一代

核心要点速览

  • 覆盖 GPT-5(2025 年 8 月)到 Astra 级(2026 年 9 月) 的内部与已发布模型,用 NCRI、Think Fast 和两项内部无 CoT 评测衡量
  • 无 CoT 能力是基座困惑度的平滑函数:按困惑度看,GPT-6 Astra 并未偏离趋势,尽管英国 AISI 曾判定它在数学时间跨度上偏离历史进度
  • 对比 3 种架构:多数评测由困惑度决定,但「架构 2」在多跳规划和串行计算上明显超出预期
  • Astra 级模型在只有长度约束和最终答案评分的 RL 中 CoT 可控性大幅上升;Terra 级模型加上工具访问和工具监督只带来小幅额外提升
  • 用 2 个能力相当、可控性不同的教师做 SFT,学生模型保留了同样的可控性差距;但在监控规避评测上未见可控性与规避成功率的明显关联
阅读全文
关联模型 / 智能体 / 厂商:

AWS 发布本地模拟器 AWS Emulator:代码 100% 由自主 AI Agent 编写和审查,覆盖 200 多个服务的 400 多个 API 模型,CC0 开源、免费,可供 Claude Code、Kiro 等编码 Agent 离线测试

亚马逊 11 月 11 日(北京时间 12 日凌晨)正式发布 AWS Emulator:一个在本机运行的 AWS API 模拟器,AWS CLI、各语言 SDK 和编码 Agent 只需改几个环境变量,就能把请求打到 127.0.0.1:9297,而不是真实云端,无需 AWS 账号、也不另收费。它用 Rust 编写,基于 AWS SDK 使用的同一套 API 模型生成,官方称覆盖 200 多个服务的 400 多个 API 模型。最特别的是,按高级首席工程师 Matthew Goldberg 的说法,全部代码由成千上万个自主 Agent 编写、测试和修复,团队没有手写或人工审查过一行。源码和保真度测试集都以 CC0 协议放在 GitHub 上。

AWS 发布本地模拟器 AWS Emulator:代码 100% 由自主 AI Agent 编写和审查,覆盖 200 多个服务的 400 多个 API 模型,CC0 开源、免费,可供 Claude Code、Kiro 等编码 Agent 离线测试

核心要点速览

  • 覆盖 200+ 个 AWS 服务、400+ 个 API 模型(官方口径),本地 HTTPS 端点 127.0.0.1:9297,无需 AWS 账号、不另收费
  • 代码 100% 由自主 Agent 编写:三组 Agent 分别写测试、找差异、修 bug,每天修复 数千 个问题、数百 个 Agent 并发工作(官方口径)
  • 公开的保真度测试集 manifest 列出约 2.97 万条测试(本站统计),每条都先在真实 AWS 上验证;按服务公布「k / n」通过数,官方未给出总通过率
  • 限制:不评估 IAM 策略、单账号单 Region、只在 us-west-2 校验,数据只存在内存中,不可用于安全测试或生产
  • 安装:Linux 用 RPM/Debian 包,macOS/Windows 用 Docker;或运行 aws agent-toolkit add-skill --skill-name aws-emulator 让编码 Agent 自行配置(需 AWS CLI 2.35.0+)
阅读全文
关联模型 / 智能体 / 厂商:

Arena:Claude Fable 5.2 (Max) 以 +30.4% 净提升登顶 Agent Arena,约为第 2 名 Opus 5.5 的 1.6 倍,代码、工作、对话三榜均第一

Arena 于 11 月 11 日宣布,Anthropic 的 Claude Fable 5.2 (Max) 在 Agent Arena 总榜排名第一:基于 4,731 次真实智能体会话,净提升 +30.35%,约为第 2 名 Claude Opus 5.5 (Max)(+19.52%)的 1.6 倍,第 3 名为 Gemini 4 Carbon (High)(+16.98%,初步排名)。相比上一代 Fable 5.1,Fable 5.2 从第 5 升至第 1,净提升约翻倍,每任务中位成本从 7.60 美元降至 7.28 美元。它在「好评 vs 抱怨」「可控性」「确认成功」三项信号均居首,Bash 可靠性第 3,但每任务成本仍是 Gemini 4 Carbon 的约 5 倍。

Arena:Claude Fable 5.2 (Max) 以 +30.4% 净提升登顶 Agent Arena,约为第 2 名 Opus 5.5 的 1.6 倍,代码、工作、对话三榜均第一

核心要点速览

  • 总榜第 1:净提升 +30.35%(±3.93%),样本 4,731 次会话;第 2 名 Opus 5.5 为 +19.52%,第 3 名 Gemini 4 Carbon 为 +16.98%(Arena 榜单)
  • 相比 Fable 5.1:排名 #5 → #1,净提升 +14.82% → +30.35%,每任务中位成本 $7.60 → $7.28,API 价格 $10/$50 → $8/$40 每百万 token
  • 分项信号:好评 vs 抱怨 +73.44%(第 1,下一名约 +41%)、可控性 +32.96%(第 1)、确认成功 +21.99%(第 1)、Bash 可靠性 +14.42%(第 3)
  • 分类榜:Code +34%、Work +31%、Chat +27%,三类均第 1(Arena 官方口径)
  • 性价比:每任务 $7.28,约为 Opus 5.5($5.37)的 1.36 倍、Gemini 4 Carbon($1.46)的 5 倍;Pareto 前沿上仍有 Carbon、GPT-6.1 Sol/Terra 等低价选项
阅读全文

Google 发布 A2UI 1.0:生成式 UI 开放协议首个稳定版,Agent 直接回复表单和图表;新默认格式 Express 把 UI 输出 token 砍掉约 63%

Google 11 月 11 日发布 A2UI 1.0,这是其生成式 UI 开放协议(Apache 2.0)的首个稳定版。Agent 不再只回一大段文字,而是描述要显示的卡片、选择器或图表,由各个 App 用自己的原生组件渲染。1.0 新增双向函数调用和无障碍支持,提供 React、Angular、Lit、Flutter、SwiftUI 渲染器,以及 Python、TypeScript、Dart 三套 Agent SDK。Google Cloud Tech 官方文章称,新的默认推理格式 A2UI Express 在 54 个样本的测试中让生成的 UI 代码 token 减少 63.2%。Atlassian、Alation、Bloomberg、字节跳动已在使用。

Google 发布 A2UI 1.0:生成式 UI 开放协议首个稳定版,Agent 直接回复表单和图表;新默认格式 Express 把 UI 输出 token 砍掉约 63%

核心要点速览

  • A2UI 1.0 是首个稳定版,Apache 2.0 开源;Jetpack Compose 渲染器目前仍是 0.9.1,1.0 版「即将推出」
  • 1.0 新增双向函数调用(例如订座选择器可当场查空位)、无障碍支持和元数据扩展
  • 新默认格式 A2UI Express:在 54 个样本、gemini-3.8-flash 的测试中,提示 token 中位数降 45.4%(10,980→6,000),生成的 UI 代码 token 降 63.2%(官方口径)
  • 安全设计:UI 消息是纯声明式数据,不含脚本和 CSS;Agent 只能用 catalog.json 白名单里的组件和函数
  • Web 和 Flutter 渲染器可在 MCP Apps 里运行,A2UI 界面能出现在 Claude、Gemini 等支持 MCP Apps 的助手中
阅读全文