
Google 11 月 11 日(北京时间 12 日凌晨)由 Sundar Pichai、@Google、@GoogleAIStudio 和 Logan Kilpatrick 正式宣布 Gemini Decisions API 与专用判定模型 Gemini Decision 1(gemini-decision-1)。它不逐 token 生成文字,而是一次前向计算给最多 1,000 个是否、单选(2–255 个选项)、打分题给出概率和置信度,支持文本、图片、音频、视频和 PDF,上下文 256K。官方称端到端延迟 150–250 毫秒,1 到 100 题延迟几乎不变;输入每百万 token 0.10 美元,输出不计费,在共享评测集上总成本约为 Gemini 3.5 Flash-Lite 的五分之一。官方跑分表中,它在 9 项评测里 7 项第一,7 项共享评测的 Top-1 校准误差 0.0250,低于 TypeSafe Jev 1.14 和 OpenAI 的 GPT-6 Luna。此前本站依据 API 更新日志报道时官方尚未公告,现已正式发布,此前「模型被撤下」的说法不成立。第三方 Artificial Analysis 测得其 Decision Index 为 66 分,尚未登顶。
核心要点速览
- ✓官方正式发布:Sundar Pichai、@Google、@GoogleAIStudio、Logan Kilpatrick 同步宣布,模型 ID gemini-decision-1
- ✓单次最多 1,000 个问题、上下文 256K;模型计算中位数 50–100 毫秒,端到端 150–250 毫秒(官方口径)
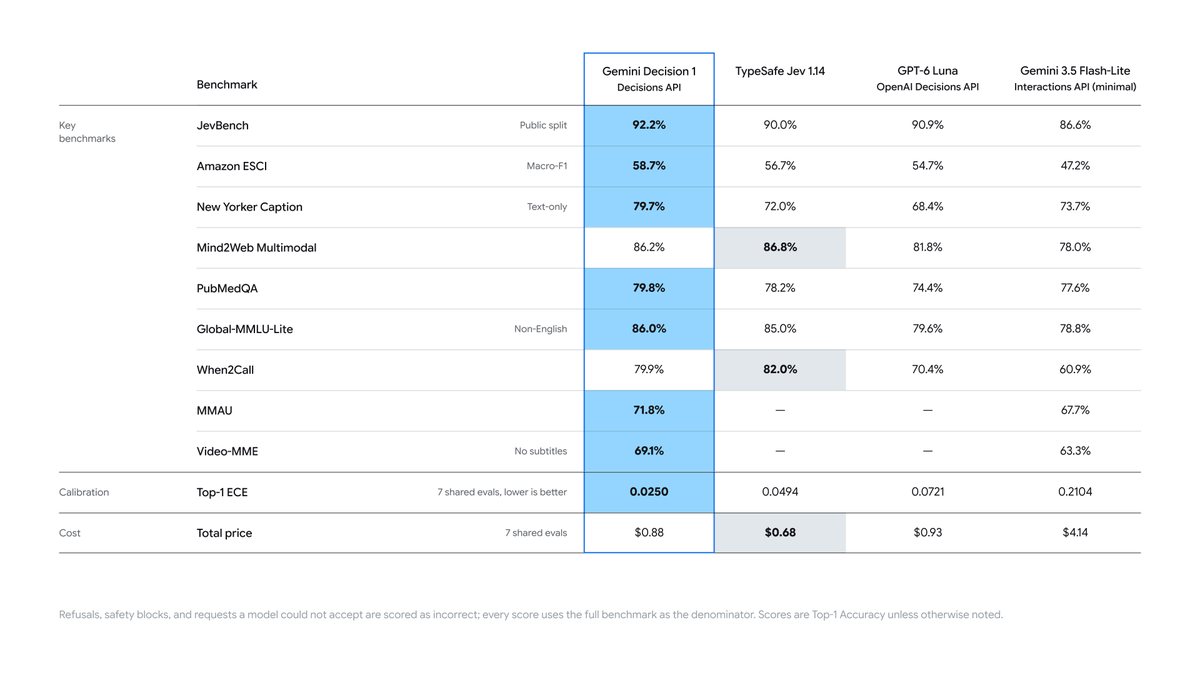
- ✓官方跑分:9 项评测 7 项第一,如 JevBench 92.2%、Amazon ESCI 58.7%;Mind2Web 多模态 86.2% 和 When2Call 79.9% 落后 TypeSafe Jev 1.14
- ✓Top-1 校准误差 0.0250,TypeSafe Jev 1.14 为 0.0494、GPT-6 Luna 为 0.0721、Gemini 3.5 Flash-Lite 为 0.2104;第三方 Artificial Analysis:Decision Index v2.1 66 分,落后榜首 Drex Max v1.1 / GLiDE v1.2(73)7 分,Brier 0.18
- ✓价格:输入 0.10 美元/百万 token、输出 0;7 项共享评测总花费 0.88 美元,Flash-Lite 为 4.14 美元,TypeSafe Jev 1.14 为 0.68 美元更便宜
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
Agent 和自动化流程里充满「判断题」:请求该走哪个模型、工具调用是否安全、图片里的包裹有没有破损。让生成式模型写一段文字再解析,既慢又不稳定,也给不出可信的概率。今年秋天 OpenAI 等已推出专门的判定接口。Google 的模型先在 11 日出现在 Gemini API 更新日志里(本站当时据此报道),几小时后 Sundar Pichai、@Google 和 Logan Kilpatrick 正式宣布,此前「模型被撤下」的说法不成立。
架构亮点与底层机制
官方介绍,Gemini Decision 1 基于 Gemini 原生多模态架构,不做逐 token 解码,一次前向计算给所有候选项打分。三种题型:noul(是否)、choice(2–255 选 1)和 score(有序量表),每个答案都带 0–1 的置信度。题目之间相互独立,共享输入每次请求只计费一次。
权威 Benchmark 与实测跑分对比
以下均为官方口径。9 项评测中 7 项第一:JevBench 92.2%(GPT-6 Luna 90.9%)、Amazon ESCI 58.7%、PubMedQA 79.8%、Global-MMLU-Lite 86.0%、Video-MME 69.1%。Mind2Web 多模态(86.2% 对 86.8%)和 When2Call(79.9% 对 82.0%)不如 TypeSafe Jev 1.14。7 项共享评测的 Top-1 校准误差为 0.0250,为四者最低;总花费 0.88 美元,Flash-Lite 为 4.14 美元,但 TypeSafe 只要 0.68 美元。第三方 Artificial Analysis 随后给出独立结果:Decision Index v2.1 得 66 分,与 Elephant 9B、Jev 1.14 持平,落后榜首 Drex Max v1.1 和 GLiDE v1.2(均为 73)7 分;知识与推理类领先,但在其分类抽取基准 AA-Paperclip 上全对率 33%,Drex Max 为 63%;每百万任务成本 345 美元,约为 Drex Max(103 美元)的 3 倍。
开发者实战落地与开箱指南
在 AI Studio 取 API key,用 google-genai 调用 client.decisions.create(v1beta),model 填 gemini-decision-1。可以先试官方的 Doorstep Parcels、Speed Sketch 等示例应用。官方称 Gemini Notebook 用它做模型路由,日常请求延迟最多降 40%。OpenRouter、LangChain、LiteLLM、Pipecat、LiveKit、OpenCode 正陆续接入。建议按置信度设阈值,把拿不准的请求转给人工处理。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察