

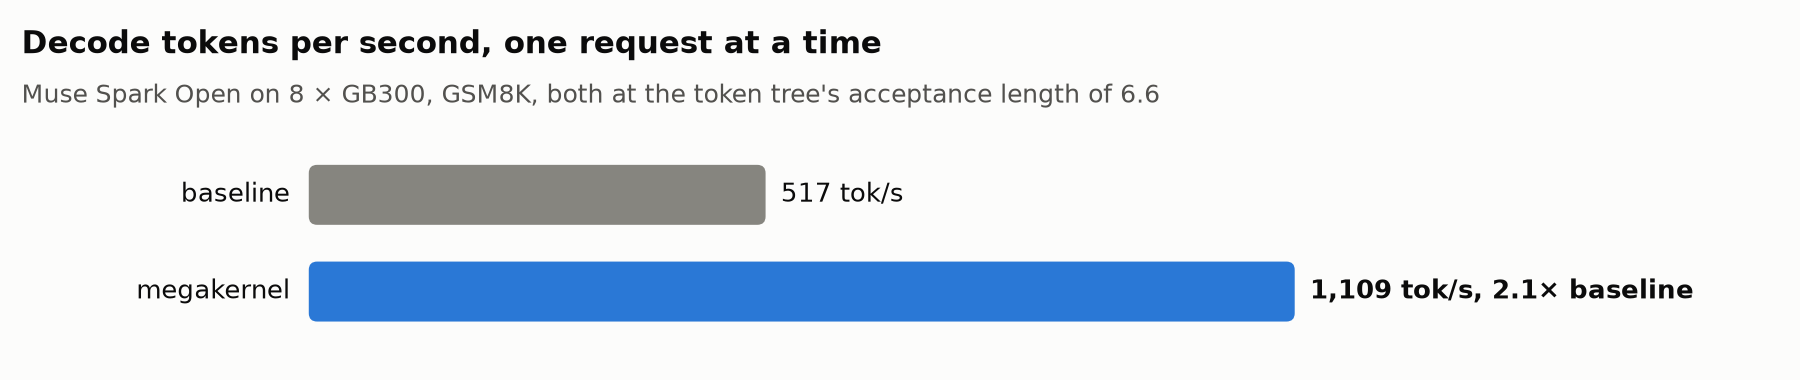
LMSYS 发布技术长文,介绍为 Meta 开源模型 Muse Spark Open 从零手写的 megakernel(CUDA C++ 与 PTX,约 8000 行):每个解码层只启动一次内核,把计算、显存加载和跨卡通信重叠起来。在 8 张 GB300 上,单请求解码速度从 SGLang 基线的 517 tok/s 提到 1,109 tok/s,约 2.1 倍;每个解码步从 12.9 毫秒降到 5.9 毫秒。代码以 SGLang 插件形式开源在 facebookresearch/sgl-muse-mega(MIT)。目前只支持 batch 1,属于实验功能,换来的是低延迟,不是更便宜的 token。
核心要点速览
- ✓速度翻倍:8×GB300、TP8、GSM8K 单请求,解码 517 → 1,109 tok/s,约 2.1 倍(同一草稿模型、同一接受长度)
- ✓内核启动大减:每个解码步从约 1,450 次内核启动降到 97 次,每层只启动一次
- ✓单步耗时:12.9 毫秒 → 5.9 毫秒;其中验证 10.9 → 5.3 毫秒,草稿 1.16 毫秒 → 0.44 毫秒(草稿从 175 次启动降到 8 次)
- ✓投机解码:DFlash V2 草稿每步猜 15 个 token,验证 16 个、平均接受 6.6 个;小米 MiMo-V2.5-Pro 为验证 8 个、接受 6.3 个
- ✓适用范围:仅 batch 1,其他请求回退到普通 SGLang;8 张顶级 GPU 只服务一个用户,卖的是延迟而不是成本
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
普通推理引擎把模型拆成一串小内核依次执行。LMSYS 统计,SGLang 跑 Muse Spark Open 时每个解码步要启动约 1,450 个内核,内核之间 GPU 会排空再填满,很多 SM 和线程在空等。即便开了投机解码,基线单请求也只有 517 tok/s。对实时编码助手、语音这类对延迟敏感的场景,这段空转就是用户感受到的卡顿。
架构亮点与底层机制
作者 Pranjal Shankhdhar 用 CUDA C++ 和 PTX 手写了约 8000 行代码,每次启动覆盖从本层注意力到下一层 qkv 投影和 KV 写入的全部算子。每个 SM 上放一个 12 warp 的线程块,warp 分工加载、跑张量核和做通信;权重提前预取到共享内存或 L2;根据上一步的路由,提前把最常用的 14 个专家拉进 L2。跨卡同步改为直接轮询数据本身,省掉了昂贵的内存屏障。文章还发现内核过大会撑爆约 128KB 的指令缓存,于是每次启动先把自身代码预热进 L2。
权威 Benchmark 与实测跑分对比
以下均为 LMSYS 自测:8 张 GB300、TP8、GSM8K 单请求、20 步中位数。解码 517 → 1,109 tok/s,单步 12.9 → 5.9 毫秒,其中验证 10.9 → 5.3 毫秒、草稿 1.16 → 0.44 毫秒。DFlash V2 每步验证 16 个 token、平均接受 6.6 个。打点计时本身约占单步的 2.8%,可编译时关闭。
开发者实战落地与开箱指南
代码在 GitHub facebookresearch/sgl-muse-mega(MIT),作为 SGLang 插件使用,启动参数为 --enable-nvidia-megakernel,目前只针对 GB300(sm103)。仅覆盖 batch 1 解码,其余请求自动回退普通 SGLang,项目也标注为实验性。团队下一步是支持更大批量,并朝能在运行时调度任务的“GPU 操作系统”方向演进。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察