

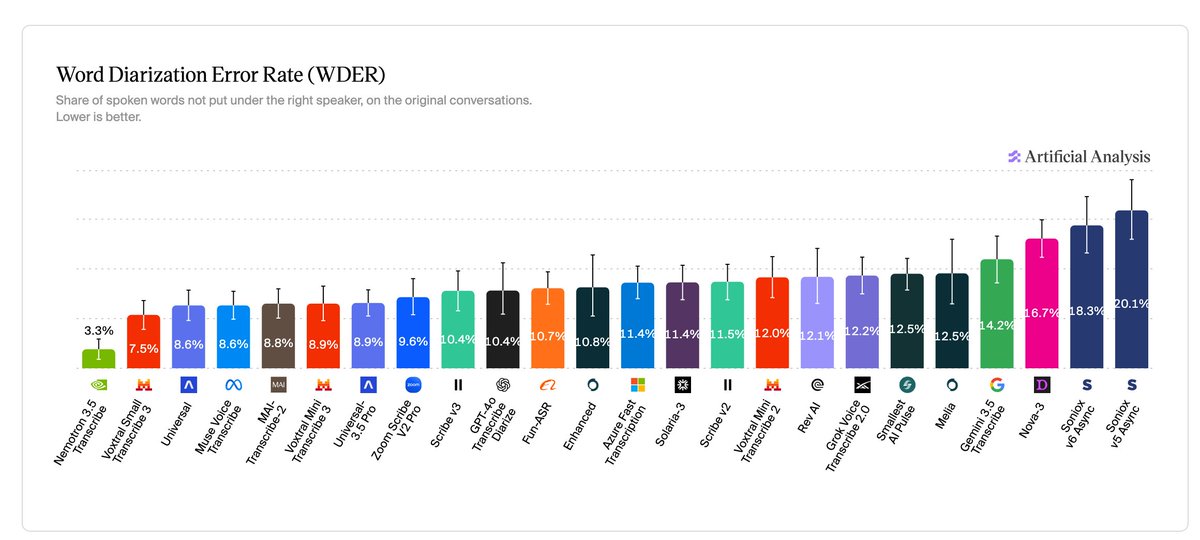
Artificial Analysis 11 月 13 日发布 Diarization Index,专门衡量语音转文字 API 能否把每个词归到真正说话的人:指标是 WDER(被分给错误说话人或无人说话的词占比),测试集为 97 段 2–8 人英文对话,按 2 人、3–4 人、5–8 人三档等权平均。NVIDIA 开源权重的 Nemotron 3.5 Transcribe 以 3.3% 居首,Voxtral Small Transcribe 3 以 7.5% 排第二,也是有标价 API 里最准的;MAI-Transcribe-2 为 8.8%,速度最快之一。
核心要点速览
- ✓新指标 WDER =(分错说话人的词 + 无人说话时段的词)÷ 参与评分的参考词数,越低越好;AA 称不用 DER,因为对 API 而言 DER 主要在考词时间戳而不是谁在说话
- ✓测试集 97 段对话、每段约 2–9 分钟、总时长约 6.8 小时,真实与合成语音混合,大部分音频为私有留出集,另含约 126 分钟公开的 NOTSOFAR-1 会议录音
- ✓评测时直接调用各 API 并开启说话人分离,不告诉模型有几个人在说话,整段音频一次送入;价格包含单独收费的分离功能
- ✓Nemotron 3.5 Transcribe 2 人对话 WDER 1.7%,5–8 人时也只有 5.6%;在人数最多的一档,其他所有 API 的 WDER 都超过 10%
- ✓Voxtral Small Transcribe 3 为 7.5%、每千分钟 4 美元;MAI-Transcribe-2 为 8.8%、每千分钟 1.67 美元,每等 1 秒可转写 93.7 秒音频;Nemotron 3.5 Transcribe 是开源权重模型,AA 未列价格
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
背景与痛点
会议纪要、客服质检、播客字幕、语音智能体都依赖说话人分离:转写再准,如果把话安到错误的人头上,摘要和后续自动化都会出错。过去榜单大多只比 WER(词错率),很少系统比较「谁说了什么」。Artificial Analysis 11 月 13 日把这一项单独做成了 Diarization Index。
架构亮点与底层机制
核心指标 WDER 逐词检查:词归给说话者本人算对,归给别人算「错说话人」,模型在该时刻认为没人说话算「漏掉」。测试集 97 段 2–8 人英文对话、约 6.8 小时,分 2 人、3–4 人、5–8 人三档,各档 WDER 等权平均即为指数,结果带 95% 置信区间。调用时开启分离、不提示人数、整段送入。
权威 Benchmark 与实测跑分对比
据 AA 官方帖:Nemotron 3.5 Transcribe 3.3% 第一(2 人 1.7%,5–8 人 5.6%);Voxtral Small Transcribe 3 7.5% 第二,每千分钟 4 美元;MAI-Transcribe-2 8.8%,每千分钟 1.67 美元,速度系数 93.7。人数最多一档,除 Nemotron 外所有 API 都超过 10%。其余 API 的完整名次见 AA 榜单。
开发者实战落地与开箱指南
多人会议场景应优先看 5–8 人一档,而不是总分;对成本敏感可在 MAI-Transcribe-2 与 Voxtral 之间权衡。AA 说明本版只覆盖托管的语音转文字 API,自托管与第三方托管不在内。选型前建议用自家录音做小样本复测。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察