
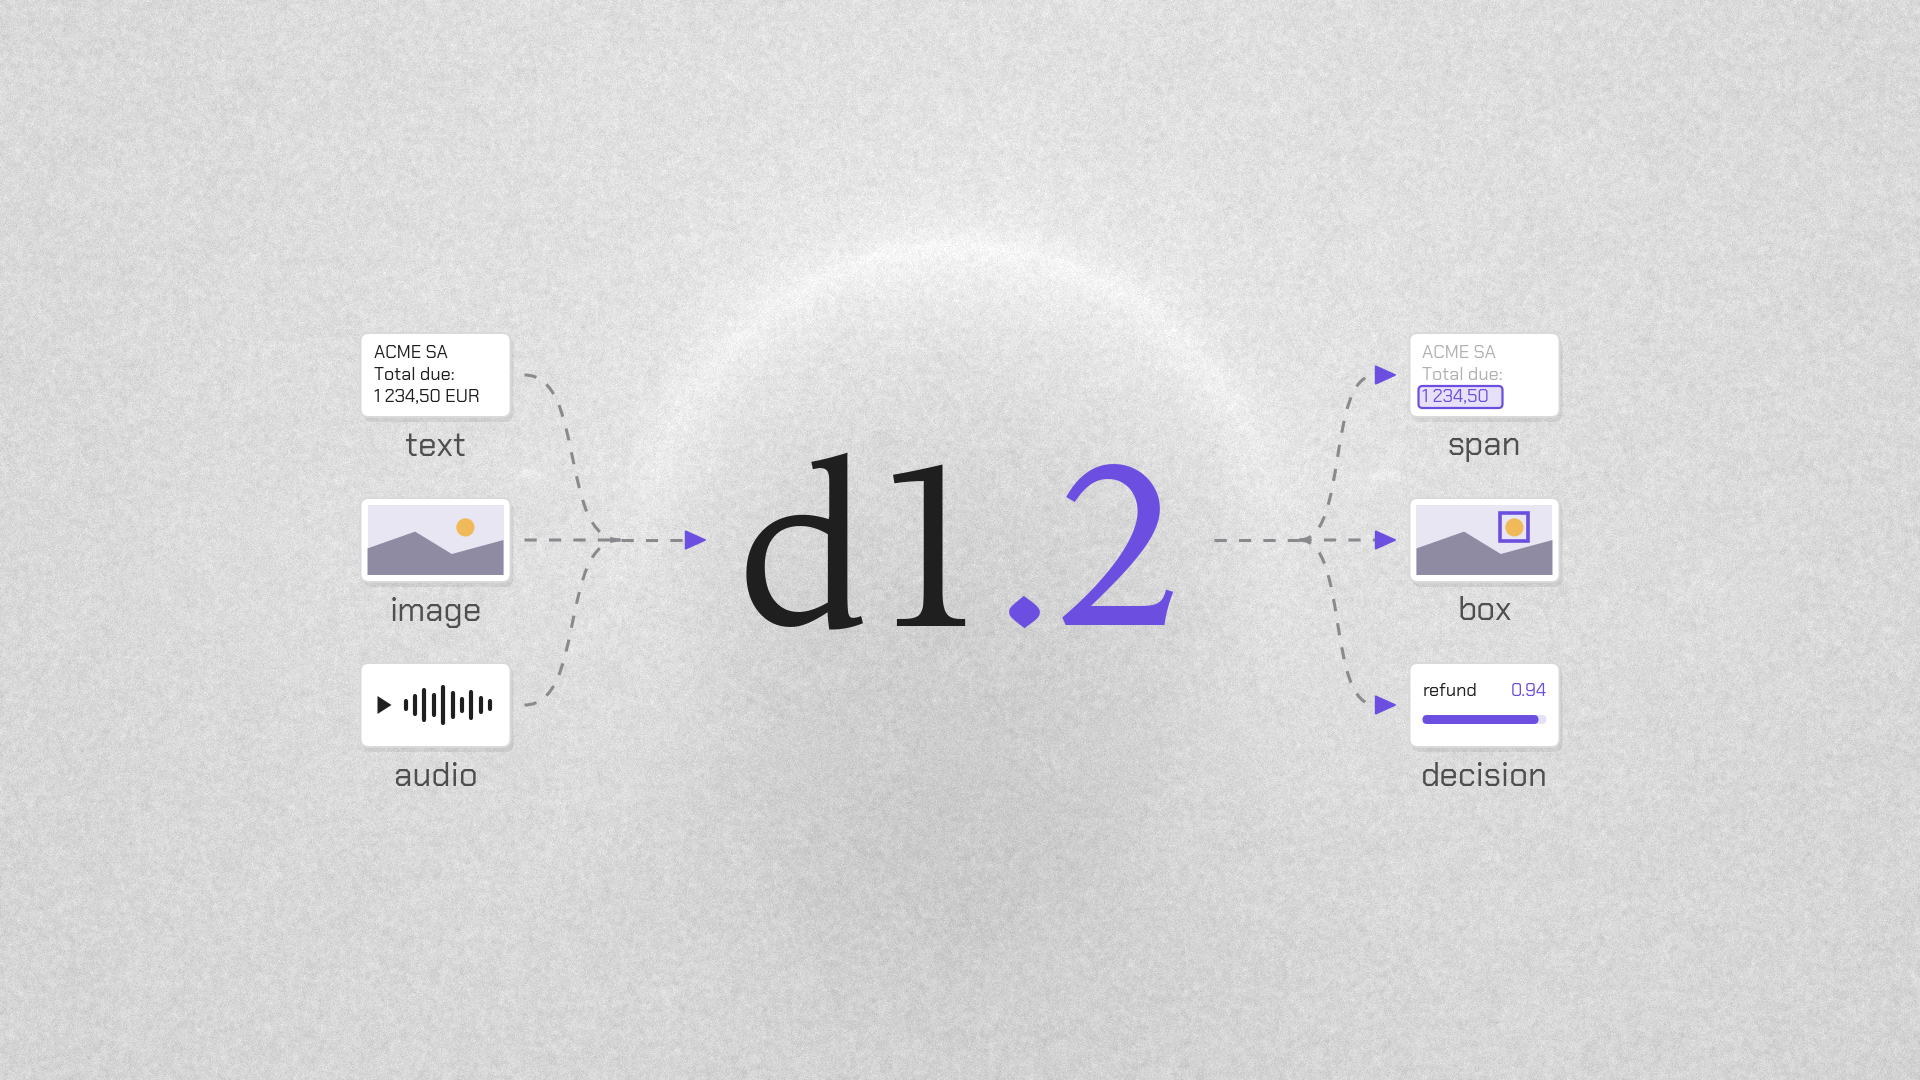
Liquid AI 发布决策模型新版本 d1.2 和 d1.2-ultra,可处理文本、图片和音频,新增读取数值、抽取片段、图中定位、数量估计和多选五类任务。d1.2-ultra 在 Artificial Analysis Decision Index v2.1 得 75 分,排名第一,比此前最佳决策模型高 2 分。两款模型已上线 Liquid API,只按输入计费:d1.2 每百万输入 token 0.02 美元,d1.2-ultra 0.042 美元,价格与上一代相同。
核心要点速览
- ✓d1.2-ultra 在 Artificial Analysis Decision Index v2.1(6 项基准,同时考核答案概率)得 75 分,决策模型第一;Liquid 称同等花费下没有模型比 d1.2 分数更高
- ✓新增 5 类任务:读取文本/数字/日期值(找不到时回答「not found」)、抽取所有同类片段、图中框出单个或全部目标、带区间的数量估计、多选并给出各自概率
- ✓新增音频输入:既可以问关于录音的问题(如说的是哪种语言、背景是否有警笛),问题本身也可以是语音
- ✓只收输入费用,无输出 token 费:d1.2 每百万输入 token 0.02 美元,d1.2-ultra 0.042 美元;图片按每 32x32 像素块 1.5 token 计,1024x1024 约 1536 token
- ✓Liquid 自测校准误差:d1.2-ultra 0.8、d1.2 1.2,对比 Jev 1.14 为 2.7、Perplexity Decider v1.3 为 3.7;新任务准确率来自 Liquid 内部测试集,非公开基准
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
「决策模型」不写长文,而是对输入回答结构化问题并给出概率,适合票据处理、审核、工单分类等需要设阈值、低置信度转人工的流程。Liquid AI 在 X 和官方博客发布 d1.2 和 d1.2-ultra,把输入扩展到音频,并补上抽取和定位类任务。
架构亮点与底层机制
两款模型可处理文本、图片和音频。新增五类任务:读取数值(附出处字符,缺失时答 not found)、找出所有同类片段、在图中框出一个或全部目标、估计数量并给区间、多选并给出各选项概率。
权威 Benchmark 与实测跑分对比
第三方 Artificial Analysis Decision Index v2.1 上,d1.2-ultra 得 75 分排名第一,比此前最佳决策模型高 2 分。Liquid 公布的校准误差为 d1.2-ultra 0.8、d1.2 1.2,对比 Jev 1.14 的 2.7 和 Perplexity Decider v1.3 的 3.7。新任务准确率来自 Liquid 内部测试集,暂无公开基准对照。
开发者实战落地与开箱指南
在 console.liquid.ai 创建 API Key 即可调用,只按输入计费:d1.2 每百万输入 token 0.02 美元,d1.2-ultra 0.042 美元,与上一代同价;官方称即将上线 OpenRouter 和 Vercel。做票据抽取、PII 识别或图像检查的团队,建议先用自己的样本验证 not found 行为和概率阈值。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察