vLLM 联合蚂蚁集团开源 Humming 算子库:最高 5 倍算子加速,MoE 端到端吞吐提升 43.3%
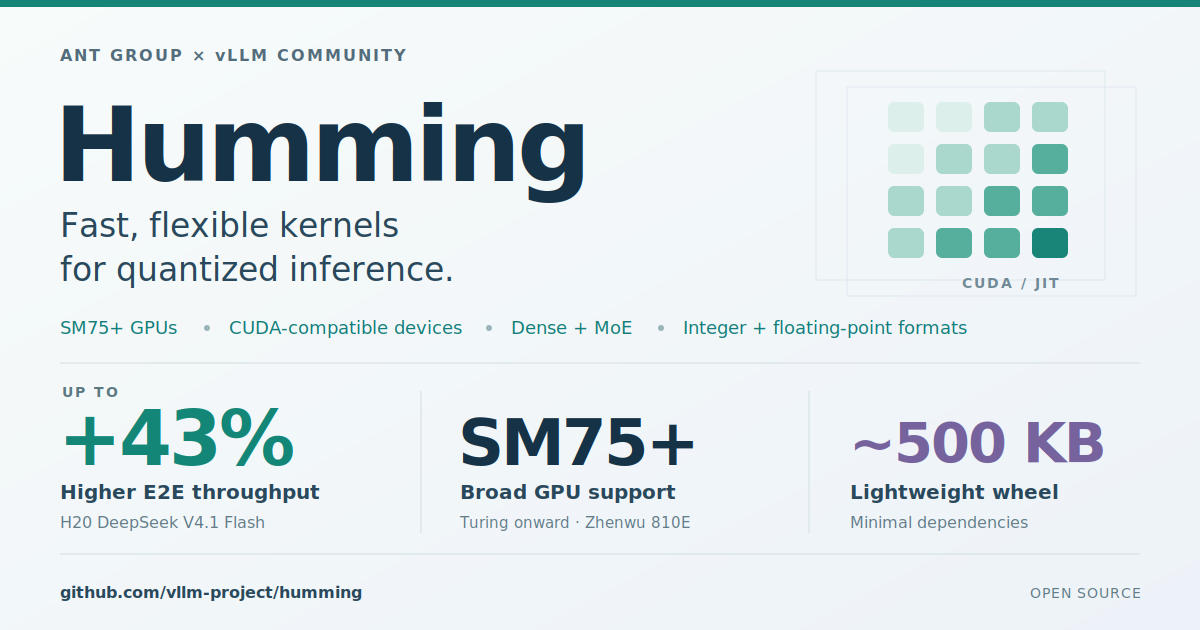
vLLM 官方联合蚂蚁集团正式开源底层高性能量化推理算子库 Humming(humming-kernels)。该算子库专为大规模混合专家(MoE)与低精度密集模型的高并发服务而设计,全面覆盖 WnA16、W8A8、W4A8 与 W4A4 多种量化精度,横跨 INT1~INT8 与 FP4~FP8 数据格式,并原生适配从 NVIDIA Turing 到 Blackwell 架构及平头哥真武 810E 芯片。实测显示,Humming 算子在小 Batch 下比 cuBLAS 快 3~4 倍,在大 Batch 下比 Marlin 快 2 倍;在 8 张 H20 GPU 上运行 DeepSeek-V4.1-Flash,64 并发下整机端到端吞吐暴增 43.3%,首字时延(TTFT)大幅降低 32%,现已作为默认引擎整合至 vLLM v0.29.0+ 中。

核心要点速览
- vLLM 与蚂蚁集团联合开源 Humming 高性能算子库(Apache 2.0),现已原生内置于 vLLM 0.29.0+ 核心代码中
- 全方位打通 WnA16、W8A8、W4A8 与 W4A4 低比特精度,算子即时编译耗时仅需 1.82 秒(相比 CUTLASS 的 23.35 秒提速 12 倍)
- 在 8 卡 H20 集群部署 DeepSeek-V4.1-Flash 实测:64 并发下吞吐从 442 提升至 634 tokens/s(净增 +43.3%)
- 首字生成时延(TTFT)缩减 25%~32%,在下一代 B300 架构上 MoE 核心算子实现最高 5 倍极限加速
关联模型 / 智能体 / 厂商: