AI 编程实时动态与要闻

Kimi 推出 3D Make:K3.1 Pro 可直接操作 Blender、CAD 和 Unreal/Unity/Godot 引擎建模、搭场景、做游戏

月之暗面 Kimi 官方账号 10 月 30 日 03:14(UTC)发布 3D Make,称 Kimi 可连接 Blender 和 CAD 等工具来建模、组装场景和开发游戏,已在 kimi.ai 和 Kimi Work 上线。官方同步发布的 3D 教程说明,K3.1 Pro 经过专门训练,通过 Python 脚本操作 3D 软件,即使没有 MCP 支持的专业软件也能纳入工作流;人物、动物等网格模型则自动调用 Tripo 等扩散模型生成。需要本地软件的插件仅在 Kimi Work 中可用。
Kimi 推出 3D Make:K3.1 Pro 可直接操作 Blender、CAD 和 Unreal/Unity/Godot 引擎建模、搭场景、做游戏

核心要点速览

  • 上线范围:3D Make 已在 kimi.ai 和 Kimi Work 提供,依赖本地软件的插件仅限 Kimi Work
  • 两种建模路线:参数化建模由 K3.1 Pro 写 Python 脚本完成(家具、机械件、建筑),网格建模自动调用 Tripo、Meshy、Hyper3D 等服务
  • 引擎适配:官方称已适配 Unreal Engine、Unity 和 Godot,可导入模型、搭场景、逐步实现玩法
  • 官方案例:K3.1 Pro 发布视频里的天宫场景用 Unreal Engine 5.8 制作,源模型合计 3600 万个三角形,用 Nanite 和 Lumen 渲染
  • 跑分:官方未公布 3D 相关基准,教程也承认部分任务需要多轮修改,骨骼绑定和复杂材质仍是短板
阅读全文

GitHub Universe 2026:Copilot Fusion 正式 GA,自动路由与编排多模型,Fusion Max 在 Artificial Analysis 编码智能体指数拿 60 分,成本约为 Claude Code + Opus 5.5 Max 的一半

GitHub 10 月 28 日在 Universe 2026 宣布 Copilot Fusion 正式可用(GA)。它把此前研究预览的 Project HydraFusion 多模型编排和 Copilot auto 模型选择合并:用户在模型选择器里选 Copilot Fusion 和努力档位(Standard / High / Max),由系统按任务决定用哪些模型、走 Single、Cascade 还是 Critique 流程。官方称 Fusion Max 在 Artificial Analysis 编码智能体指数得 60 分,比 Claude Code + Opus 5.5 Max 低 2 分,但每任务 API 成本约一半、token 约一半、耗时少约 40%。按所用模型标准价计费,付费用户到 11 月 30 日享 30% 折扣。

GitHub Universe 2026:Copilot Fusion 正式 GA,自动路由与编排多模型,Fusion Max 在 Artificial Analysis 编码智能体指数拿 60 分,成本约为 Claude Code + Opus 5.5 Max 的一半

核心要点速览

  • 跑分(Artificial Analysis 编码智能体指数 v2.0):Fusion Max 60 分,Claude Code + Opus 5.5 Max 62 分;每任务成本 5.59 美元对 11.42 美元,Devin Fusion 组合 62 分、8.00 美元
  • 分项:Terminal-Bench 4.0 得 71 分略领先;FrontierCode 51 分排第三(Claude Code 56、Devin Fusion 54);SWE-Atlas-QnA-AA 57 分偏弱
  • 效率:每任务约 720 万 token,约为 Claude Code + Opus 5.5 的一半,比 Devin Fusion 少 30%;GitHub 称耗时少约 40%
  • 模型池含 Claude Opus 5.5、Claude Sonnet 5.5、GPT-6 Astra、GPT-6 Sol 等;管理员可单独禁用某模型供 Fusion 使用,并把 Fusion 设为默认
  • 可用范围:所有 Copilot 套餐,VS Code、Copilot app、Copilot CLI 和 JetBrains;原 auto / HydraFusion / HydraFusion Max 设置自动迁移到对应档位
阅读全文

港大 Dream 团队创立的 DiffuSpace 开源 Clover-35B-A3B 扩散语言模型:单卡 680 tokens/s,SWE-bench Verified 73.6

扩散智能 DiffuSpace(成员来自推出 Dream 7B 的港大 NLP 实验室)10 月 28 日发布首个模型 Clover-35B-A3B-Preview:基于 Qwen3.6-35B-A3B 初始化的 MoE 扩散语言模型,总参 35B、激活约 3B、128K 上下文,按块并行去噪生成。官方口径下 SWE-bench Verified 73.6、Terminal-Bench 2.1 51.7、GPQA Diamond 83.8,单张 GB300 上 Agent 场景生成速度 680 tokens/s。权重 Apache 2.0,已上 Hugging Face、ModelScope 和 GitHub,支持 SGLang 与 llama.cpp。

港大 Dream 团队创立的 DiffuSpace 开源 Clover-35B-A3B 扩散语言模型:单卡 680 tokens/s,SWE-bench Verified 73.6

核心要点速览

  • 35B 总参、约 3B 激活的 MoE 扩散模型,由 Qwen3.6-35B-A3B 初始化,128K 上下文,支持思考模式
  • 官方称六项 Agent 评测全部第一:SWE-bench Verified 73.6、Terminal-Bench 2.1 51.7、τ³ Overall 65.3,超过 LLaDA2.2 flash、Mercury 2.5 和 Qwen3.6-35B-A3B
  • 速度(官方口径):单张 GB300、BF16、batch=1 下 Agent 场景 680 tokens/s;单张 H200 上 515 tokens/s,高于 DFlash2 加速 Qwen 的 365 tokens/s
  • INT4 量化后可在 16GB 显存的 RTX 5070 Ti 上运行,MATH-500 生成速度 101.8 tokens/s
  • Hugging Face 权重 Apache 2.0,BF16 约 69GB,官方推荐用 SGLang 部署
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Clover-35B-A3B-Preview⚡ Qwen3.6-35B-A3B⚡ Dream 7B⚡ LLaDA2.2 flash⚡ Mercury 2.5🌐 DiffuSpace🌐 HKU NLP🌐 Alibaba Qwen🌐 NVIDIA

Oracle AI World 发布 Fusion Claw 执行运行时与 25 个智能体应用,Fusion Companion 让员工在 ChatGPT 里直接调度 ERP/HCM 流程

Oracle 10 月 26 日在拉斯维加斯 Oracle AI World 发布一组企业 AI 更新:新的智能体执行运行时 Oracle Fusion Claw,以及基于它的 25 个 Agentic Applications,已覆盖 ERP、HCM、供应链(SCM)和客户体验(CX);同时推出 Fusion Companion 和 Fusion Agentic Home,员工可以在 ChatGPT 等受支持的 AI 工具或 Fusion 原生界面里用自然语言描述目标,由系统自动挑选并协调交易、工作流、审批和 AI 智能体,全程沿用企业现有的身份、权限和审批控制。官方未公布定价、跑分或具体上线时间表。

Oracle AI World 发布 Fusion Claw 执行运行时与 25 个智能体应用,Fusion Companion 让员工在 ChatGPT 里直接调度 ERP/HCM 流程

核心要点速览

  • 运行时:Fusion Claw 是新的智能体执行运行时,官方称支持更大规模、更长时间运行的任务、持续重新规划、确定性执行和受治理的自主度(官方新闻稿)
  • 应用数量:25 个 Claw 驱动的 Agentic Applications 已可用,覆盖 ERP、HCM、SCM、CX 四大套件,示例包括 Ledger、Workforce Orchestration、Payroll Activity Workspace、Procurement Spend 等
  • 入口:Fusion Companion 可在 ChatGPT 等受支持的 AI 工具及客户或伙伴自建界面中调用 Fusion,Fusion Agentic Home 是原生入口(Fusion Companion 新闻稿)
  • 治理:所有执行都沿用企业既有身份、权限、策略和审批控制,需人类判断的决策会上报
  • 未公布:定价、跑分和各应用的详细上线时间表官方均未公布
阅读全文
AD赞助内容

SolarRenderer 突破结构化视频生成:4 步去噪极速渲染灰模与深度图,768p 实时流式合成高保真世界

来自新加坡国立大学(NUS)、香港中文大学(深圳)等机构的研究团队在 arXiv:2610.28630 正式发布视频生成渲染框架 SolarRenderer。针对当前 3D 游戏引擎灰模、姿态骨骼、深度图与点云难以极速转化为高保真视觉视频的难题,SolarRenderer 基于冻结的 MiniMax-H3 33B 基础视频模型,引入轻量化控制 LoRA 与 4 步生成 LoRA。利用结构引导分布匹配算法,仅需 4 步去噪即可完成高质量渲染(比传统 50 步采样提速 12.3 倍),并提出块因果(Block-Causal)变体,成功实现 768p 高清视频的毫秒级实时流式生成,为下一代神经游戏引擎与虚拟制片树立了全新标杆。

SolarRenderer 突破结构化视频生成:4 步去噪极速渲染灰模与深度图,768p 实时流式合成高保真世界

核心要点速览

  • SolarRenderer(arXiv:2610.28630)发布,实现基于粗糙 3D 几何(灰模、骨骼、深度、网格)的高保真视频极速渲染
  • 冻结 MiniMax-H3 33B 视频底座,仅微调轻量 Control LoRA 与 4-step LoRA,保持基座生成能力的同时强化几何控制
  • 仅需 4 步去噪采样即可完成高保真视频渲染,生成速度较传统 50 步扩散采样提速惊人的 12.3 倍
  • 研发块因果(Block-Causal)注意力流式架构,在工业级 GPU 上实现 768p 分辨率视频实时连续生成
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MiniMax-H3⚡ SolarRenderer

NVIDIA 集中发布 Nemotron 3.5 开源模型矩阵:涵盖超强检索、物理世界大模型与 13 倍速蛋白质设计

在 GTC Berlin 开幕主题演讲中,NVIDIA 官方集中发布了横跨多个专业垂直领域的全新开源模型矩阵。核心亮点包括:支持长文本视觉推理的 Nemotron 3.5 Super VL 与即开即用的 Bolt 系列语言模型;专为高精度 RAG 打造的 Nemotron Retriever 嵌入、重排与文档解析全套套件;面向实体工业的 Cosmos 物理世界模型;面向自动驾驶的 Alpamayo 2 Edge;以及与华盛顿大学 Baker 实验室联合开发的蛋白质生成大模型 BioNeMo RFD4-Proteina。官方实测显示,RFD4-Proteina 在 10 项以上蛋白质设计基准中斩获全球第一,在 200 个氨基酸的靶点设计上比 RFdiffusion3 提速惊人的 13 倍。

NVIDIA 集中发布 Nemotron 3.5 开源模型矩阵:涵盖超强检索、物理世界大模型与 13 倍速蛋白质设计

核心要点速览

  • NVIDIA 在 GTC Berlin 集中开源全栈垂直基础模型:包含 Nemotron 3.5 Super VL、Bolt 4GB 端侧版与 Cosmos 物理世界模型
  • 发布 Nemotron Retriever 全套套件,将企业级 RAG 检索、跨模态重排与复杂 PDF 版面解析的准确率推至行业前列
  • 与顶尖 Baker 实验室联合开源 BioNeMo RFD4-Proteina,在 10 余项蛋白质靶向结合任务中登顶全球性能榜首
  • RFD4-Proteina 生成 200 氨基酸蛋白质结构的设计速度比前代标杆 RFdiffusion3 提速整整 13 倍,大幅缩短原研药发现周期
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Super VL⚡ Nemotron 3.5 Bolt⚡ BioNeMo RFD4-Proteina⚡ Cosmos🌐 NVIDIA🌐 Baker Lab

Artificial Analysis 实测 Devin Fusion 双模型异构智能体:综合得分为 68.1,任务成本立降 31%

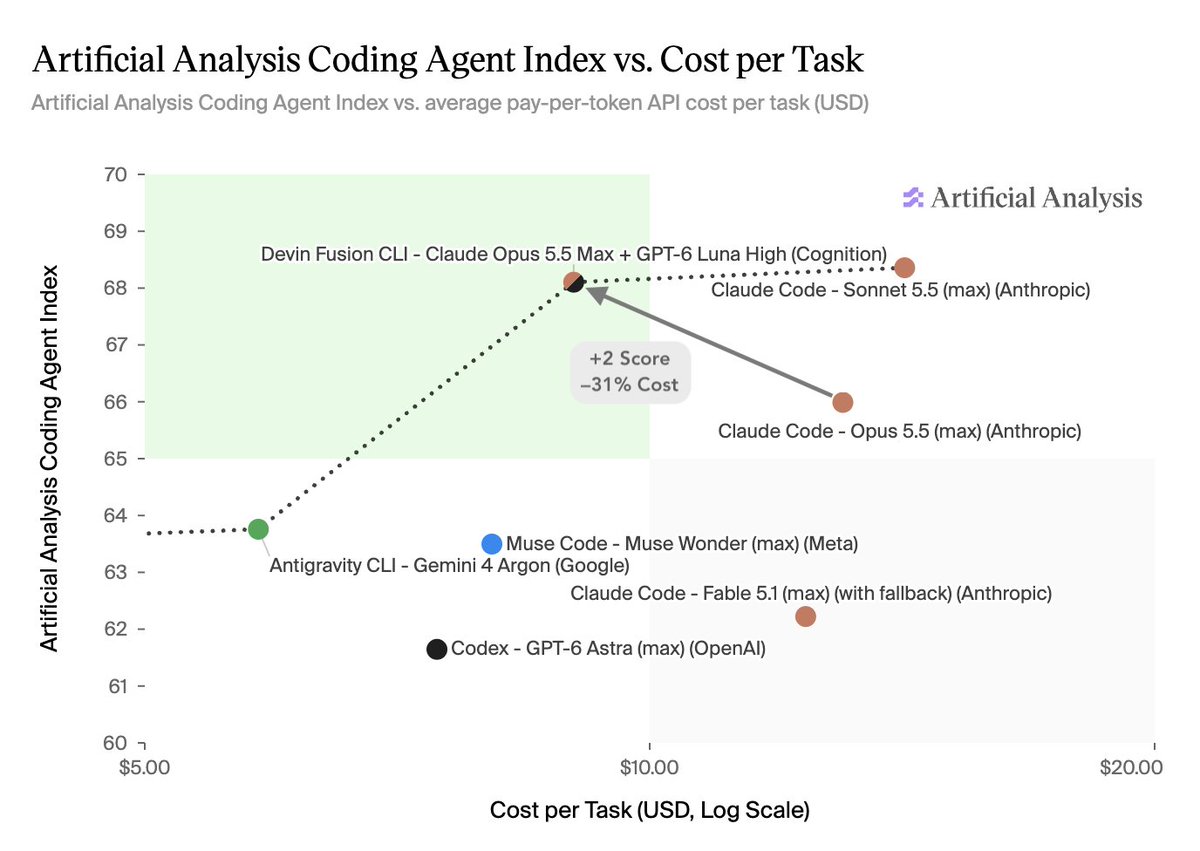
权威独立 AI 基准测试机构 Artificial Analysis 正式发布针对 Cognition 旗下最新编程智能体 Devin Fusion 的全面实测报告。Devin Fusion 采用了革命性的“异构双模型并行协同架构”:由旗舰级的 Claude Opus 5.5(Max)担任总架构师与核心决策大脑,配合轻量极速的 GPT-6 Luna(High)作为并行子智能体执行具体检索与代码试跑。在 Coding Agent Index 综合大考中,Devin Fusion 斩获 68.1 分的高分,位居全球最顶级智能体梯队;而在经济性方面,单任务综合调用成本从 Claude Code Opus 单模型的 13.04 美元骤降至 9.01 美元(成本节省达 31%),单任务平均耗时由 65 分钟缩短至 55 分钟。

Artificial Analysis 实测 Devin Fusion 双模型异构智能体:综合得分为 68.1,任务成本立降 31%

核心要点速览

  • Artificial Analysis 发布 Devin Fusion 权威评测(Status #2112773422698606736),以 68.1 分稳居全球 Coding Agent 前三甲
  • 首创异构双模型协同:由 Claude Opus 5.5 主导架构规划,配合 GPT-6 Luna 承担轻量高并发子任务与终端执行
  • 单任务端到端开销从纯 Opus 5.5 的 13.04 美元骤降至 9.01 美元,实现 31% 的显著降本与 15% 的执行提速
  • 在 DeepSWE v1.1 软件工程实测中达成 72.6% 解决率(远超 Opus 5.5 单模的 68.4%),在 SWE-Atlas-QnA 取得 69.6% 胜率
阅读全文

vLLM-Omni 宣布整合 PhysisServe:物理世界与视频扩散模型推理加速,4.1 毫秒极速输出

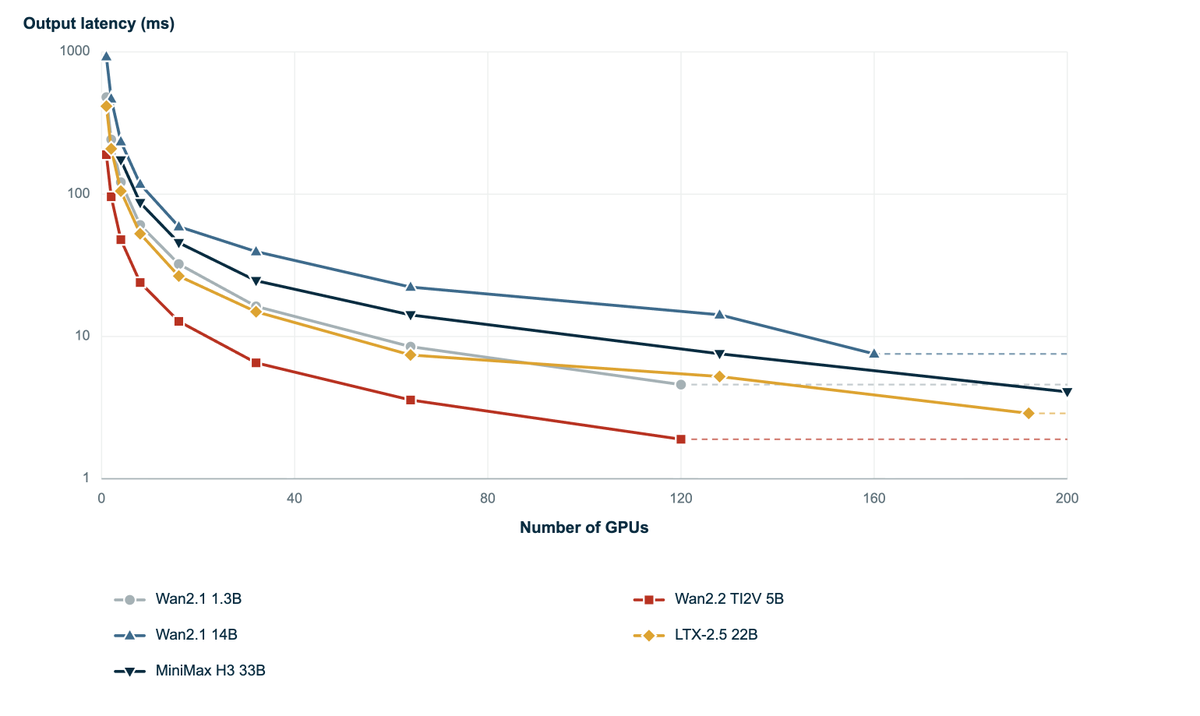
vLLM 官方项目组正式宣布将 PhysisServe 的核心推理加速架构整合至 vLLM-Omni 多模态全能推理引擎中。针对物理世界 AI、视频扩散生成与具身大模型在长程去噪阶段面临的高显存占用与高延迟痛点,PhysisServe 创新性提出去噪步与 Transformer 跨块流水线并行(Block Pipelining)、时间分片批处理与虚拟秩联合调度。在 200 张 GPU 集群上对 MiniMax H3 33B 展开实测,实现每 4.1 毫秒输出一个 Chunk(折合千帧/秒渲染),Wan2.2 5B 单卡单请求延迟从 173 毫秒降至 98 毫秒。

vLLM-Omni 宣布整合 PhysisServe:物理世界与视频扩散模型推理加速,4.1 毫秒极速输出

核心要点速览

  • vLLM 官方宣布将 PhysisServe 核心加速架构合流至 vLLM-Omni,专精于物理世界大模型与视频扩散生成推理
  • 首创去噪步与 Transformer 跨块流水线并行(Block Pipelining)与时间分片批处理,彻底消除多卡通信气泡
  • 在 200 卡集群上 MiniMax H3 33B 达成每 4.1 毫秒产出单 Chunk(纯 DiT 计算达千帧/秒),Wan2.2 5B 单卡时延降至 98 毫秒
  • 24 卡集群并发承载能力暴增 1.7~3.3 倍,代码已全面开源至 GitHub 并即将进入 vLLM-Omni 正式版
阅读全文
关联模型 / 智能体 / 厂商:

Adobe 与布朗大学开源多模态多参考视频编辑框架 OmniXRef:镜头轨迹误差大降 5 倍,横扫五大属性控制

Adobe Research 与布朗大学在 arXiv:2610.22744 中正式发布统一多模态多参考视频编辑框架 OmniXRef。针对现有视频编辑模型通常仅支持单一文本提示、难以精确解耦多参考源(如参考视频的运镜、参考图像的主体外观与自然语言指令)的行业痛点,OmniXRef 采用单流扩散 Transformer(Diffusion Transformer)架构,提出 Mix-Patchify 与参考相对位置编码(R2-RoPE)。实测显示在运镜轨迹迁移中旋转误差低至 0.874、平移误差 3.961,超越顶尖商用闭源系统达 5 倍以上。

Adobe 与布朗大学开源多模态多参考视频编辑框架 OmniXRef:镜头轨迹误差大降 5 倍,横扫五大属性控制

核心要点速览

  • Adobe 与布朗大学联合开源多模态多参考视频编辑框架 OmniXRef(arXiv:2610.22744),支持文本、图像与视频多参考源自由组合
  • 基于单流 Diffusion Transformer 架构,提出 Mix-Patchify 与 R2-RoPE 相对位置编码,实现多模态上下文联合注意力建模
  • 在镜头轨迹迁移中旋转误差仅 0.874、平移误差 3.961,精度超越顶尖商用视频系统 Seedance 2.5 达 5 倍以上
  • 全面覆盖运镜、动作、主体、画风与特效五大属性解耦控制,开源项目主页已正式上线
阅读全文
关联模型 / 智能体 / 厂商:

Devin Fusion 以 Opus 5.5 主控、GPT-6 Luna 执行拿下 Artificial Analysis 编码智能体指数 68.1,官方称每任务成本比 Claude Code + Opus 5.5 低 31%

Cognition 10 月 19 日宣布,Devin Fusion 用 Claude Opus 5.5 做主控(lead)、GPT-6 Luna 做执行助手(sidekick)的组合,在 Artificial Analysis Coding Agent Index v1.5 拿到 68.1 分。按 Artificial Analysis 网站当前数据,这一分数位列榜首,但只比第二名 Muse Code + Muse Wonder Full(68.0)高 0.1 分,基本并列;第三名 Antigravity CLI + Gemini 4 Argon 为 63.8。Cognition 称该组合每任务成本比 Claude Code 搭配 Opus 5.5 低 31%(厂商口径)。Fusion 已在 Devin CLI 和桌面版提供。

Devin Fusion 以 Opus 5.5 主控、GPT-6 Luna 执行拿下 Artificial Analysis 编码智能体指数 68.1,官方称每任务成本比 Claude Code + Opus 5.5 低 31%

核心要点速览

  • 总分 68.1:DeepSWE v1.1 72.6、SWE-Atlas-QnA 69.6、Terminal-Bench v4 62.1,三项等权(Artificial Analysis 数据)。
  • 与第二名 Muse Code + Muse Wonder Full(68.0)只差 0.1 分;Antigravity CLI + Gemini 4 Argon 63.8,Codex + GPT-6.1 Sol(xhigh)62.9。
  • 成本:Cognition 称比 Claude Code + Opus 5.5 每任务低 31%(厂商口径)。
  • 此前 Fusion 搭配 Fable 5.1 + SWE-2 在 DeepSWE 1.1 上把单任务成本从 14.63 美元降到 7.88 美元(−46%),得分 64.3→63.1。
  • 官方推荐组合为 Opus 5.5 + GPT-6 Luna,安装 Devin CLI 即可使用。
阅读全文
AD赞助内容

Skyfall AI 发布工程世界模型 SKY-001:文字或草图直接生成可执行 CAD 建模步骤,官方称 CAD 任务比 GPT-6 Astra 快 51 倍、便宜 150 倍

由 Maluuba(已被微软收购)原班团队创办的 Skyfall AI 于 10 月 19 日发布研究预览版 SKY-001,自称首个「工程世界模型」。它不做下一个 token 预测,而是从文字或一张 2D 图出发,先并行生成几种粗略 3D 方案,再递归拆成零件树,逐个零件画 2D 草图、拉伸成 3D,最后按层级组装,可在 Autodesk Fusion 等 CAD 软件中查看。官方自测 3D CAD 任务:IoU 79.7%(GPT-6 Astra 79.1%),单例 3.9 秒、0.005 美元(Astra 199 秒、0.75 美元)。目前仅开放候补名单,商用部署目标是 2027 年初;所有跑分均为厂商自测,暂无独立复现。

Skyfall AI 发布工程世界模型 SKY-001:文字或草图直接生成可执行 CAD 建模步骤,官方称 CAD 任务比 GPT-6 Astra 快 51 倍、便宜 150 倍

核心要点速览

  • 3D CAD 自测:SKY-001 IoU 79.7%、3.9 秒、0.005 美元/例;GPT-6 Astra 79.1%、199 秒、0.75 美元;Opus 5.5 69.4%;Grok 4.7 未完成任何样例(官方口径)。
  • BIM 自测:SKY-001 IoU 43.6%、1.22 秒、约 0.0024 美元/例;最佳 LLM 为 Gemini 3.8 Flash 42.3%;相对 GPT-6 Astra 快 118 倍、便宜 188 倍(官方口径)。
  • 四阶段流程:并行方案探索 → 递归扩散式 3D 拆解 → 2D 到 3D 潜空间建模 → 层级组装,演示中 Jaguar E-Type 拆出 103 个末级零件、139 个节点。
  • 可用性:研究预览,仅候补名单;新闻稿称商用部署目标 2027 年初,官方未公布参数量、训练数据和 API 定价。
  • 团队:Maluuba 创始人 Sam Pasupalak、Kaheer Suleman、Sumit Pasupalak,投资方含 Fidelity、Touring Capital、M13、iNovia Capital。
阅读全文

Inception 正式发布 Mercury 3:扩散架构大模型突破 1000 Token/s,100 万上下文挑战 GPT-6 与 Haiku

前沿 AI 初创公司 Inception 联合创始人 Stefano Ermon 宣布正式推出新一代扩散架构大语言模型 Mercury 3。模型在 NVIDIA GPU 上实现高达 1,068 Token/秒的超高生成吞吐,参数量达到前代 Mercury 1 的 40 倍并支持 100 万(1M)Token 原生上下文。在 IFBench、GPQA Diamond 与 SWE-Bench Atlas 基准上全面对标前沿闭源基线,输入/输出百万 Token 标准定价为 0.20 / 0.70 美元(上线期半价优惠仅需 0.10 / 0.35 美元)。

Inception 正式发布 Mercury 3:扩散架构大模型突破 1000 Token/s,100 万上下文挑战 GPT-6 与 Haiku

核心要点速览

  • Inception 联合创始人 Stefano Ermon 正式发布扩散架构大模型 Mercury 3,在 NVIDIA GPU 上实现 1,068 Token/秒的超高吞吐
  • 模型参数扩充至 Mercury 1 的 40 倍,支持 100 万原生超长上下文(4 倍于 Mercury 2.5),标准定价百万输入/输出仅 0.20 / 0.70 美元
  • 在 IFBench、GPQA Diamond 与 SWE-Bench Atlas 测试中表现亮眼,基准综合智能达到前代 3 倍且同步上线 OpenRouter
  • 彻底摆脱自回归逐字预测瓶颈,以并行扩散去噪实现亚秒级长文本代码生成,极大优化高并发 Agent 运行效率
阅读全文
关联模型 / 智能体 / 厂商:

Inception 发布扩散语言模型 Mercury 3:每秒 1068 token、1M 上下文,官方称多项跑分超过 GPT-6 Luna 与 Haiku 5.5

Inception 10 月 19 日发布 Mercury 3,称其为迄今最强的扩散式大语言模型(dLLM)。官方口径:参数规模是 Mercury 1 的 40 倍以上,输出速度 1068 token/秒,上下文从 Mercury 2.5 的 26 万扩到 100 万 token,在 GPQA Diamond、IFBench、SWE-Bench Atlas 等基准上超过 GPT-6 Luna 与 Claude Haiku 5.5(均为 medium 档)。标价每百万输入 0.20 美元、输出 0.70 美元,首发五折。已上线 Inception API、OpenRouter、Baseten 和 Vercel AI Gateway,兼容 OpenAI API。跑分均为厂商自测,暂无独立复现。

Inception 发布扩散语言模型 Mercury 3:每秒 1068 token、1M 上下文,官方称多项跑分超过 GPT-6 Luna 与 Haiku 5.5

核心要点速览

  • 速度:输出 1068 token/秒,官方对比表中 GPT-6 Luna 约 130、Haiku 5.5 约 240(厂商口径)。
  • 跑分:GPQA Diamond 89.23、IFBench 76.84、SWE-Bench Atlas 51.08,均高于 Luna 与 Haiku 5.5;但 DeepSWE v1 46.31 低于 Haiku 5.5 的 51.62,MRCR v2 也落后 Haiku。
  • 规模与上下文:参数是 Mercury 1 的 40 倍以上,上下文 100 万 token(Mercury 2.5 为 26 万)。
  • 价格:标价输入 $0.20/M、输出 $0.70/M,首发五折为 $0.10/$0.35,缓存输入再打 1 折;新 API key 赠 1 亿 token。
  • 渠道:Inception API、OpenRouter、Baseten、Vercel AI Gateway,OpenAI API 兼容,可直接替换。
阅读全文
关联模型 / 智能体 / 厂商:

小红书、北大与港中文深圳提出 LangDiT:专为连续扩散语言模型重构 Transformer,生成困惑度骤降至 11.33 刷新 SOTA

现有连续扩散语言模型(CDLM)普遍直接套用自回归 LLM 或图像 DiT 架构,存在特征尺度失控与梯度路由紊乱问题。小红书、北京大学、香港中文大学(深圳)与 UCLA 团队联合发表 LangDiT(arXiv:2610.22330)。通过骨干网与 Q/K RMSNorm、展宽噪声条件调制、词表头残差截断解耦及置信度门控自条件引导,在 OpenWebText 基准上将 LangFlow 生成困惑度压至 21.72,适配 Plaid 架构后进一步取得 11.33 的全新 SOTA 困惑度记录。

小红书、北大与港中文深圳提出 LangDiT:专为连续扩散语言模型重构 Transformer,生成困惑度骤降至 11.33 刷新 SOTA

核心要点速览

  • 小红书、北大与港中文深圳联合发表 LangDiT(arXiv:2610.22330),首次系统重构专属于连续扩散语言模型的 Transformer 架构
  • 通过 Q/K RMSNorm、展宽噪声条件调制解耦数值稳定性与时间步注入,利用词表头梯度截断消除自条件反馈污染
  • 在 OpenWebText 1024 长度无条件文本生成中,将 LangFlow 生成困惑度降至 21.72,将 Plaid 困惑度大幅压缩至 11.33 的全新纪录
  • 在仅需 128 步去噪采样下仍取得 27.51 的优异困惑度,证实骨干网络定制是非自回归语言模型取得质变的核心动力
阅读全文
关联模型 / 智能体 / 厂商:

4D/3D 视觉与自回归视频扩散加速突破:Gen4P 单次前馈 4D 感知、SUPRA-TEX 超对齐材质生成与港科大 ForcingBooster 削减 50% 去噪计算

三维与四维视觉生成迎来三项底层革新:Gen4P(arXiv:2610.22371)将预训练视频生成模型改造为无需迭代去噪的单次前馈 4D 感知器,在 WorldTrack 基准全面超越 MonST3R 与 Any4D;华科与华为团队推出 SUPRA-TEX(arXiv:2610.22352),将 DTC-Tex 渲染 PBR PSNR 推高至 32.08 dB(超越 TRELLIS.2 的 28.60 dB);港科大 ForcingBooster(arXiv:2610.12625)通过自适应分块去噪将自回归视频扩散 Patch NFE 砍半(-50.19%),实现无损画质下 1.30 倍端到端加速。

4D/3D 视觉与自回归视频扩散加速突破:Gen4P 单次前馈 4D 感知、SUPRA-TEX 超对齐材质生成与港科大 ForcingBooster 削减 50% 去噪计算

核心要点速览

  • Gen4P(arXiv:2610.22371)将预训练视频生成器转化为无需迭代去噪的单次前馈 4D 感知器,在 WorldTrack 基准(ADT 91.93 APD / 0.112 EPE)全面超越 MonST3R、Any4D 与 OpenD4RT
  • 华科与华为 SUPRA-TEX(arXiv:2610.22352)结合 MLLM 光照剥离、只读 3D VAE 隐空间锚点与交错流 Transformer,在 DTC-Tex 上斩获 32.08 dB PBR PSNR(超越 TRELLIS.2 的 28.60 dB 与 Hunyuan3D 2.1 的 26.80 dB)
  • 港科大 ForcingBooster(arXiv:2610.12625)提出自适应分块去噪,在 Causal Forcing 上削减 50.19% Patch NFE,实现 1.30 倍端到端加速(11.15s 降至 8.56s)且语义分数无损(72.20 vs 72.21)
  • ForcingBooster 已在 Wan2.1 14B、LingBot-World-V2 与 LongLive 等主流自回归视频扩散架构上完成通用性验证
阅读全文
关联模型 / 智能体 / 厂商: