AI 编程实时动态与要闻

X 热议:Theo 称大模型「仍然很不擅长给 Agent 造工具」,让 Opus 搭 MCP 认证流程屡屡出错,提醒别轻信 Agent 给的 MCP「最佳实践」

T3 Chat / T3 Code CEO、YouTuber Theo(@theo)11 月 8 日发帖称,大模型「在给 Agent 造工具这件事上仍然非常糟糕」:每次让 Opus 搭建 MCP 认证路径,它都会做出离谱的假设,写出「根本跑不通」的东西。两小时后他追发一帖:他在写一份给自家 Agent 用的「MCP 正确用法」指南,先让 Agent 起草初稿,结果 Agent 建议把 MCP 地址渲染成给用户点击的链接,他直言「别相信 Agent 关于 MCP、连接策略和 Agent『最佳实践』说的任何话」。截至发稿,主帖约 880 赞、136 条回复、6.5 万次浏览。

X 热议:Theo 称大模型「仍然很不擅长给 Agent 造工具」,让 Opus 搭 MCP 认证流程屡屡出错,提醒别轻信 Agent 给的 MCP「最佳实践」

核心要点速览

  • 主帖(@theo,11 月 8 日):让 Opus 搭 MCP 认证路径时,它总会「做出离谱的假设」,写出「根本跑不通」的实现
  • 追帖(@theo):Agent 起草的「MCP 正确用法」指南建议把 MCP 地址渲染成可点击链接,Theo 称 Agent 在 MCP 和连接策略上「一无所知」
  • 热度(X 公开数据,截至发稿):主帖约 880 赞、136 条回复、138 次收藏、约 6.5 万次浏览;追帖约 344 赞、51 条回复、164 次收藏
  • 背景:MCP 授权规范基于 OAuth 2.1,要求客户端实现 PKCE,并引用受保护资源元数据(RFC 9728)、动态客户端注册(RFC 7591)等多份标准;stdio 传输则不走这套流程(MCP 规范)
  • 回帖观点:有人认为 MCP 认证一年里改过几版、训练数据跟不上;也有人建议先把规范原文和一个能跑通的请求喂给模型,无头服务器场景默认用设备码授权(RFC 8628)
阅读全文
关联模型 / 智能体 / 厂商:

Google 发布 ReproBridge:把一次成功复现打包给下一个编码 Agent,ML 论文实验复现成功率从 76.4% 升至 92.6%

Google 与滑铁卢大学在 arXiv(2611.08452,2026-11-05)发布 ReproBridge:把 Agent 复现论文时摸索出的代码修复、环境配置、启动脚本和复现指南固化为标准化产物。配套 ReproBridge-Bench 含 36 篇论文、387 个实验、1,029 个任务。作者口径:Sonnet 4.6/Sonnet 5/Opus 5/Gemini 3.8 Flash 平均成功率由 76.4% 升至 92.6%,API 花费平均降 19.7%。

Google 发布 ReproBridge:把一次成功复现打包给下一个编码 Agent,ML 论文实验复现成功率从 76.4% 升至 92.6%

核心要点速览

  • 基准:36 篇论文、387 个实验、1,029 个任务,每题 5 个人工核验参考分
  • 作者口径:4 个模型平均复现成功率 76.4% → 92.6%,API 花费平均降 19.7%
  • 模型间差距从 21.6 个百分点缩到 3.9,四个模型均超 90%
  • 增益 5.5pp(Opus 5)到 23.2pp(Gemini 3.8 Flash);消融中去掉代码或环境损失最大
  • 每篇论文 24 小时时限、8×H100;Codex 担任主审计 Auditor
阅读全文

Google DeepMind:人类引导的 AI Agent 加速密码分析,发现遗留 1024 位 RSA 两处弱点;2048 位及以上仍安全

2026-11-06,Google DeepMind(@GoogleDeepMind)与 VP Science Pushmeet Kohli 发布研究:在人类监督下,AI Agent 对遗留 1024 位 RSA 找出两处弱点——签名填充在攻击者控制约一半签名块时不再提供额外防护(沙箱复现较先前约省 3.5× CPU),以及同长度批量分解每把额外密钥平均成本约降 30×。官方强调现代 2048 位及以上协议不受影响。

Google DeepMind:人类引导的 AI Agent 加速密码分析,发现遗留 1024 位 RSA 两处弱点;2048 位及以上仍安全

核心要点速览

  • 来源:@GoogleDeepMind 2026-11-06 帖 + Pushmeet Kohli X Article;技术 PDF 两篇(签名 / Batch NFS)
  • 范围:仅针对遗留 1024 位 RSA;官方明确 2048 位及以上仍安全
  • 签名:攻击者控制约一半签名块时,填充不再额外防护;沙箱在已解 1024 位基准钥上约 3.5× 更少 CPU,且不到破钥算力的千分之一
  • 短指纹(如 32 字节):理论估计新算法对 1024 位约改进 1600×(相对先前最佳)
  • 批量分解:同长度多钥场景,每把额外钥平均成本约降 30×(相对既有 batch 方法)
阅读全文

Cua 联合 Scale AI 发布 Cua Driver Bench:评测后台桌面 Agent 是否打扰用户,macOS 厂商口径 cua-driver 全通过率约 58%

2026-11-06,Cua(@trycua)与 Scale AI AgentEnv 联合发布 Cua Driver Bench(Bench v2):固定 Claude Sonnet 5.5 与任务,只换 computer-use driver,考核任务完成、仅 GUI、以及 8 项「用户未被打扰」。Scale 口径 macOS 后台全通过:cua-driver 约 58%(23/40)、agent-desktop 约 20%、browser-use 约 3%;Cua 自跑 Codex Computer Use 约 33%。任务与轨迹公开可复跑。

Cua 联合 Scale AI 发布 Cua Driver Bench:评测后台桌面 Agent 是否打扰用户,macOS 厂商口径 cua-driver 全通过率约 58%

核心要点速览

  • 来源:Cua 官方博客 + @trycua 线程 2026-11-06;Scale 独立跑 macOS/Linux,Cua 自跑 Windows 与部分对照
  • 方法:10 项 Bench v2;后台有模拟用户持续打字;全通过=任务完成+仅 GUI+用户 8 项不被打扰
  • macOS 后台全通过(Scale,厂商口径):cua-driver 58%、agent-desktop 20%、browser-use 3%;Codex CU(Cua 跑)33%
  • 前台对照(Scale):cua-driver 约 78%、agent-desktop 70%、browser-use 64%;差距主要来自打扰
  • 落地:GitHub blog 与 libs/cua-driver-bench;HF Space/数据集 earakely-scale/CuaDriverBench-AgentEnv
阅读全文
AD赞助内容

Hugging Face 发布 Ultimate MoE Training Handbook:约 50–80 万 GPU 小时实验沉淀为 Megatron-LM 训练手册

2026-11-05,Hugging Face 发布免费「The Ultimate MoE Training Handbook」。Thomas Wolf(联合创始人)称约 80 万 GPU 小时、约 7 万字与 55 幅交互图;作者 Nouamane Tazi 另称约 50 万 GPU 小时。手册面向 Megatron-LM,覆盖路由、专家规模、通信与调试,入口为官方 Space。

Hugging Face 发布 Ultimate MoE Training Handbook:约 50–80 万 GPU 小时实验沉淀为 Megatron-LM 训练手册

核心要点速览

  • 官方:Hugging Face Space「The Ultimate MoE Training Handbook」(2026-11-05)
  • Thomas Wolf(HF 联合创始人)X 口径:约 80 万 GPU 小时、约 7 万字、55 幅交互图
  • 作者 Nouamane Tazi 另称约 50 万 GPU 小时;以 Space 正文为准,不统一编造单一数字
  • 覆盖 Megatron-LM:路由/专家规模/all-to-all/aux loss 与 loss-free bias/升采样与服务
  • 免费开源;适合小团队按 runbook 逐项对照日志落地
阅读全文
关联模型 / 智能体 / 厂商:
⚡ DeepSeek-V4 (Next-Gen MoE)⚡ Nemotron 3 Super⚡ Nemotron 3 Ultra🌐 Hugging Face🌐 NVIDIA

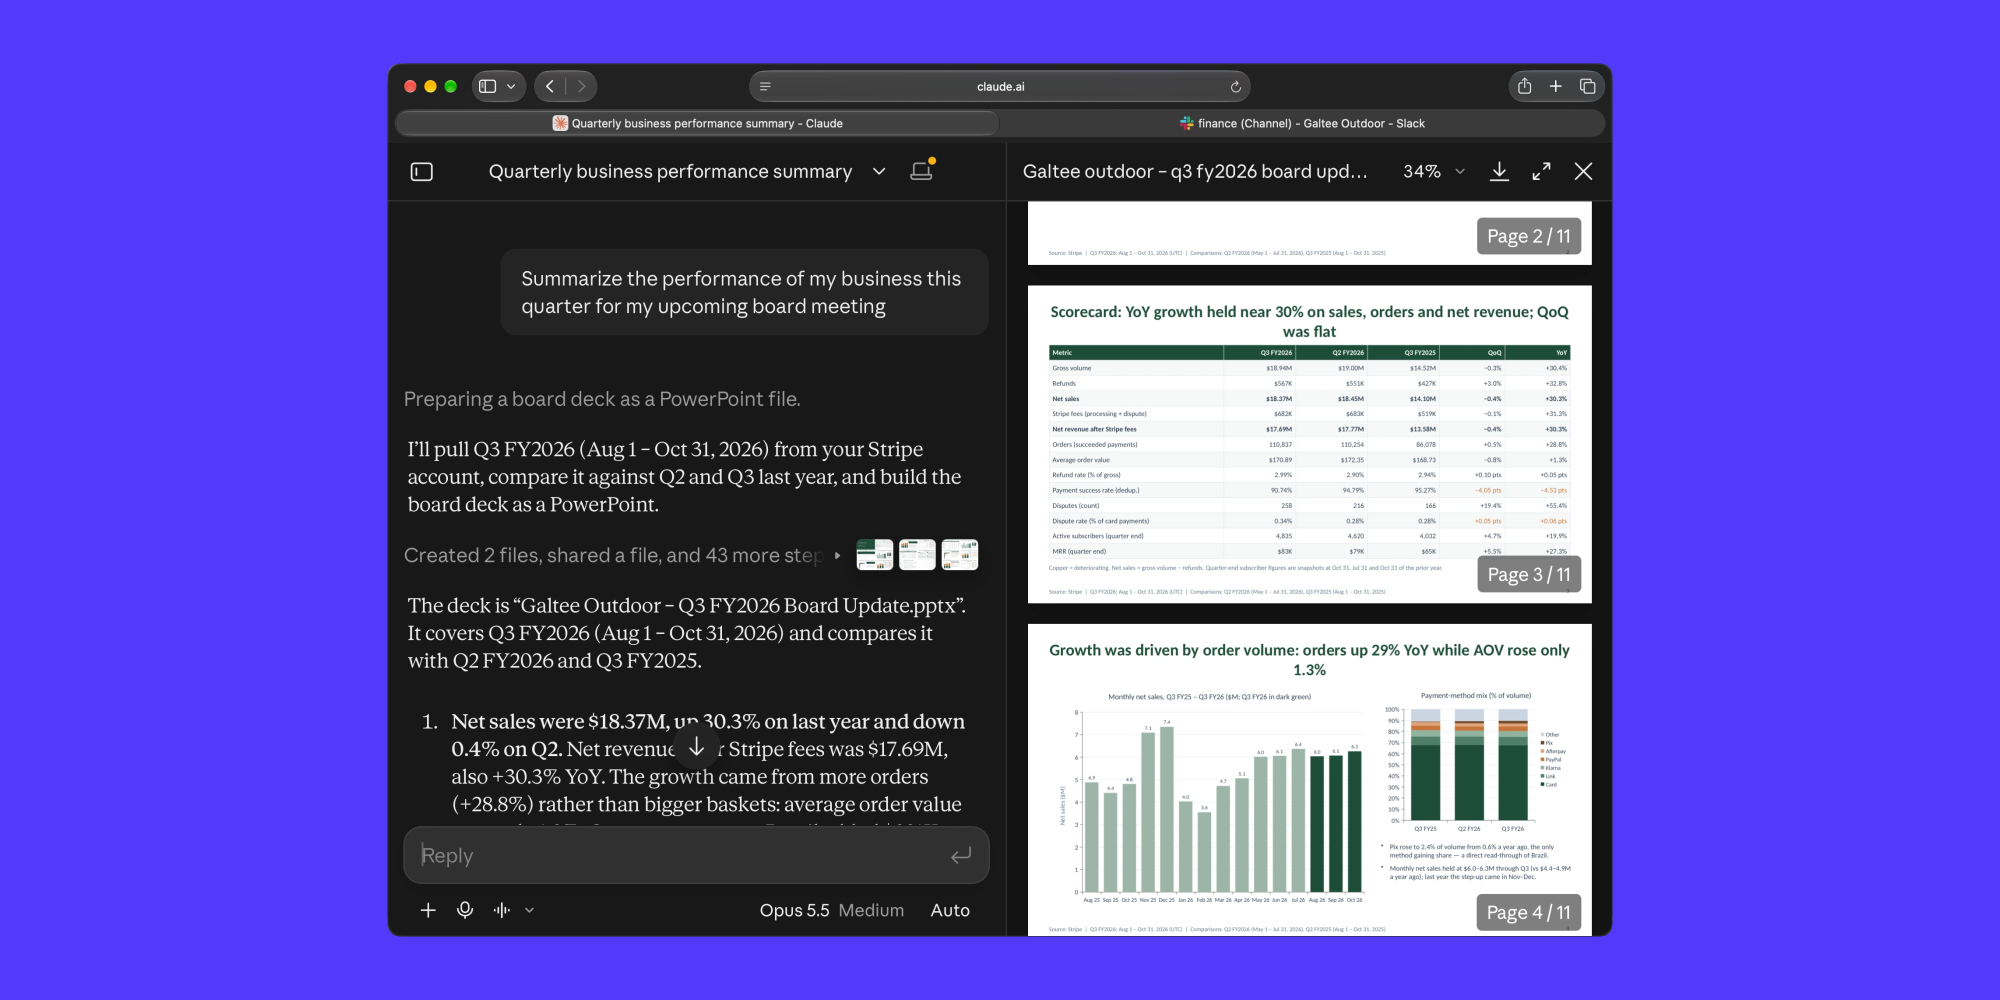
Stripe 开放「用 Agent 分析数据」:全量用户可经 MCP / Queries / Reports API 自然语言查 MRR、欺诈与对账,Queries 免费至 2027-01-31

Stripe 于 11 月 5 日宣布,所有用户都可通过 Stripe MCP 或直接调用 Queries / Reports API,用 Claude、Cursor 等兼容 Agent 以自然语言分析自家 Stripe 数据,包括 MRR、流失、欺诈与对账。Reports API 内置 300+ 表建模与用法指引;Queries API 免费至 2027 年 1 月 31 日,之后按用量计费,Reports API 保持免费。每次分析可核对底层 SQL。

Stripe 开放「用 Agent 分析数据」:全量用户可经 MCP / Queries / Reports API 自然语言查 MRR、欺诈与对账,Queries 免费至 2027-01-31

核心要点速览

  • 覆盖:全量 Stripe 用户可用;经 MCP 或 Queries / Reports API 直连 Claude、Cursor 等兼容 Agent
  • 能力:自然语言查 MRR、扩张/收缩/流失、欺诈、对账与付款表现;可拼 PostHog 等外部工具上下文
  • 数据:Reports API 带 300+ 表建模与用法指引;每次分析可检查并编辑底层 SQL
  • 定价(官方):Queries API 免费至 2027-01-31,之后按 credit 计费、无月费;Reports API 持续免费
  • 权限:只读 Data Metrics / Queries / Reports;勿把 secret key 贴进聊天,用 agent API key 或 OAuth
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Vercel CEO Guillermo Rauch 称「AI 会把人类写的软件全部重写很多遍」,引发关于形式化验证与重写风险的争论

11 月 5 日 Rauch 在 X 发帖称,大多数人写的软件又慢、漏洞多、规格不清,AI 会把它们重写很多遍,并做形式化验证、压测和加固,「这才是软件工程真正的诞生」。帖子约 3,000+ 赞、270+ 转发、近 10 万浏览;赞同者举出用 AI 从零重写的案例,反对者提醒规格缺失和人工复核的问题。这是个人观点,不是 Vercel 官方公告。

核心要点速览

  • Rauch 原帖(11-05 02:22 UTC)约 3,060 赞、272 转发、681 收藏、约 9.9 万浏览(抓取时数据)
  • 核心观点:AI 会重写人类软件「很多遍」,并做形式化验证、压测、加固,把内存不安全的底层换成更稳的实现
  • 前一小时他还转发 Vercel Security Review 数据:24 小时发现 6,817 个漏洞、580 个严重/高危、Agent 已修 1,411 个(厂商口径)
  • 反方声音:重写缺规格的代码只会更快复制错误行为,形式化验证也不会让 bug 消失,只是上移到更高抽象层
  • 这是观点讨论,不是事实或官方路线图
阅读全文
关联模型 / 智能体 / 厂商:

AMD 三季度数据中心营收 85 亿美元同比增 97%:Helios 机架已为 Anthropic、OpenAI 等运行模型,四季度指引约 170 亿美元

AMD 11 月 3 日公布 2026 年第三季度财报:总营收 133.77 亿美元,同比增长 45%;数据中心业务营收创纪录的 85.46 亿美元,同比增长 97%、环比增长 27%,主要来自 EPYC 服务器 CPU 和刚上市的 Instinct MI450 系列 GPU。公司称 Anthropic、Meta、微软、OpenAI 和 Oracle 云已在首批 Helios 机架级系统上运行模型和工作负载。AMD 给出四季度营收指引约 170 亿美元(上下浮动 3%),中值同比约增长 66%。

核心要点速览

  • 数据中心营收 85.46 亿美元,同比 +97%、环比 +27%,占总营收约 64%(一年前约 47%);部门经营利润 28.82 亿美元,利润率 34%
  • 首批 Helios 机架(Instinct MI450 系列 GPU + 第六代 EPYC)已为 Anthropic、Meta、微软、OpenAI 和 Oracle 云运行模型,MI455X 本季度开始量产出货
  • 总营收 133.77 亿美元(+45%),非 GAAP 毛利率 56%、每股收益 2.09 美元;GAAP 净利润 24.28 亿美元,含 10.97 亿美元客户认股权证公允价值变动
  • 四季度营收指引约 170 亿美元 ±3%,中值同比约 +66%、环比约 +27%,非 GAAP 毛利率约 55%
  • 同期还发布 ROCm 10(含 ROCm.AI)、Helion 机架级 Agent 系统参考架构,并宣布拟收购 World Labs 与 Taalas
阅读全文

谷歌调整 K-12 学校 AI 管控:Gemini、Gemini Notebook 和 Google 搜索对学生账号默认关闭,需管理员手动开启;Guided Learning 全球上线 Classroom

谷歌教育副总裁兼总经理 Chris Phillips 11 月 3 日在 Google 官方博客宣布,Gemini、Gemini Notebook、Gemini in Classroom 和 Google 搜索将对 K-12 学生账号完全关闭,直到学校管理员明确开启;同时 Guided Learning 即日起在 Google Classroom 全球可用,并将在搜索中为学生账号提供分步引导,本月先在部分美国学校试点。因为搜索已内置 AI Mode 和 AI 概览,完全禁用 AI 的学校学生也将用不了搜索,引发外界强烈反弹;谷歌随后在 X 上澄清可单独开启搜索。据 EdWeek 和 AP 报道,变更将于明年初落地,官方未公布具体日期。

谷歌调整 K-12 学校 AI 管控:Gemini、Gemini Notebook 和 Google 搜索对学生账号默认关闭,需管理员手动开启;Guided Learning 全球上线 Classroom

核心要点速览

  • 默认关闭范围:Gemini、Gemini Notebook、Gemini in Classroom 和 Google 搜索,对 K-12 学生账号完全关闭,需学校管理员明确开启(Google 官方博客)
  • 关键争议:搜索已内置 AI Mode 和 AI 概览,不提供“无 AI 的传统搜索”,所以完全禁用 AI 的学生群体也会失去搜索(据 EdWeek、NBC News 报道)
  • 谷歌在 X 上澄清:学校可以只开搜索、不开 Gemini 产品,学生账号里的 AI Mode 和 AI 概览会改为分步引导解题,而不是直接给答案
  • Guided Learning 即日起在 Google Classroom 全球可用;搜索版本月先在部分美国学校试点,之后数月扩展
  • 时间线:据 EdWeek 和 AP 报道变更明年初开始;官方只说未来几个月向学校公布细节,未给具体日期
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Gemini🌐 Google

腾讯混元发布 Hy4 正式版:首次加入视觉理解与电脑操作,已上线腾讯云和 OpenRouter,权重“近期开源”

腾讯混元 11 月 4 日在官网发布 Hy4 正式版。相比 8 月的 Hy4 preview,官方称扩大了预训练和后训练规模,首次加入视觉理解,首次支持电脑操作(命令行+图形界面),并专项训练了 Blender、CAD、Unreal/Unity/Godot 等场景。Hy4 已上线腾讯云和 OpenRouter(tencent/hy4,1M 上下文),API 价格与 preview 相同;模型权重和系统卡片将在近期开源发布,更便宜的 Hy4 flash 也在路上。

核心要点速览

  • 官方博客:Introducing Hy4,发布日 2026-11-04;透明度中心同步列出 V1.0 Hy4
  • 两个“首次”:视觉理解(细粒度看图、复杂图表、数学视觉推理)和电脑操作(CLI+GUI 结合,针对 Blender、CAD 和跨应用长程任务专项训练)
  • 官方自测:579 项真实金融任务(213 位金融从业者评估)Hy4 得 3.04,开放权重模型中第一(DeepSeek-V4.1-Flash-1017 2.97、Kimi K3.1 Pro 2.68、GLM-5.3 2.68);GameDev +19.1%、GameLogic +9.8%;内部搜索评测幻觉率 15.76%→5.45%
  • API 价格与 preview 相同:每百万 token 缓存输入 $0.042、输入 $0.834、输出 $2.501;OpenRouter 页面目前标注 5 折($0.417/$1.251),1,048,576 上下文、最多 65,536 输出
  • 权重尚未公开:官方称将开源权重并发布完整系统卡片,已与 vLLM、SGLang 合作;Hy4 flash 近期发布
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Hy4⚡ Hy4 preview⚡ Hy4 flash🤖 CodeBuddy🤖 WorkBuddy🌐 Tencent
AD赞助内容

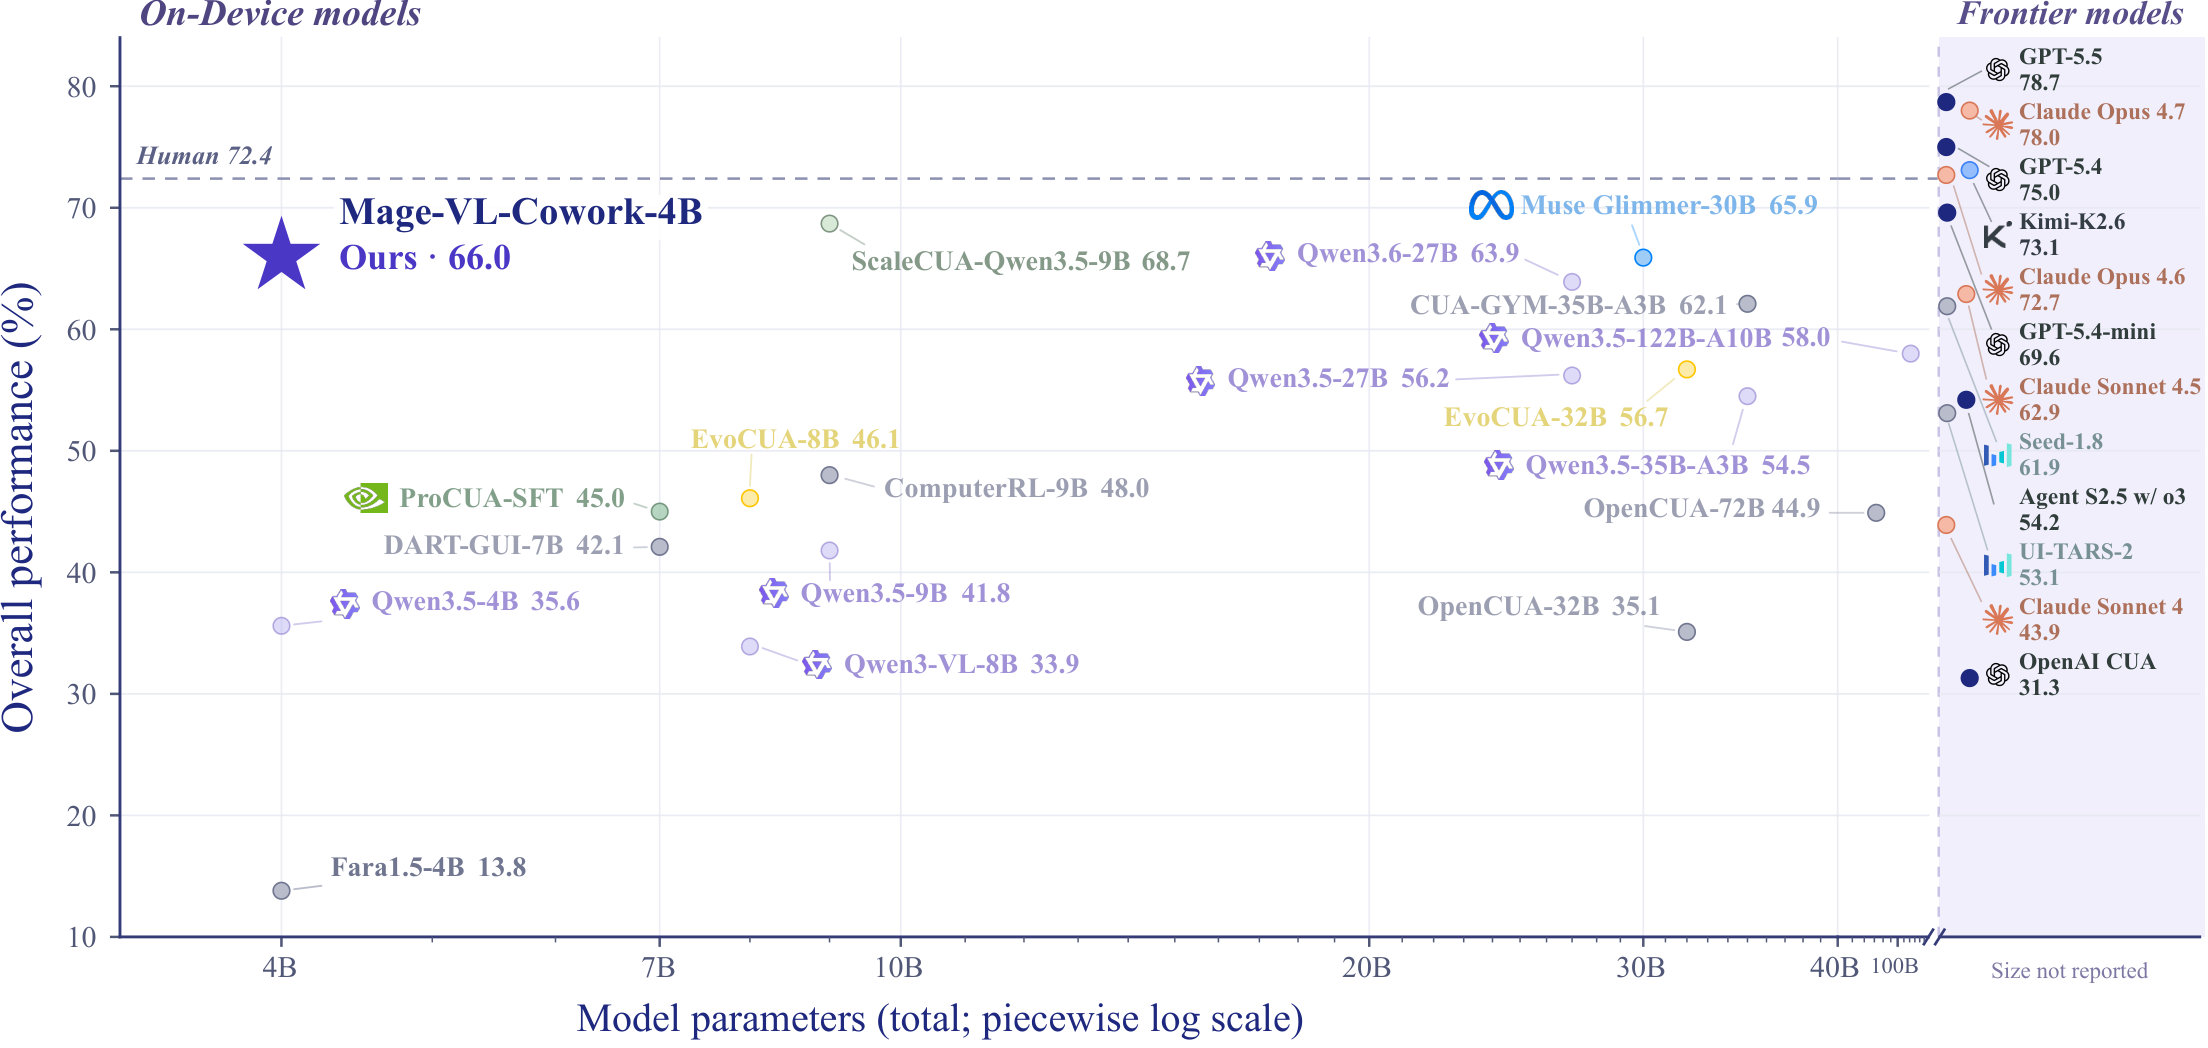
微软开源 4B 电脑操作智能体 Mage-VL-Cowork:一个模型自己决定点界面还是写 bash,OSWorld-Verified 66.0%

微软 Mage 团队 10 月 30 日在 Hugging Face 以 Apache-2.0 发布 Mage-VL-Cowork:4B 参数的多模态电脑操作智能体,同一个模型每一步自己选择用截图点界面(computer_use)还是在终端跑 bash/Python,不需要外部调度器。官方报告它在 OSWorld-Verified(361 题、50 步上限)两次平均 66.0%,高于 Qwen3.6-27B 的 63.9%,但仍低于 9B 的 SCALECUA-Qwen3.5-9B(68.7%)。

微软开源 4B 电脑操作智能体 Mage-VL-Cowork:一个模型自己决定点界面还是写 bash,OSWorld-Verified 66.0%

核心要点速览

  • 4B 参数,基于 Mage-VL(Mage-ViT 视觉编码器 + Qwen3-4B-Instruct-2507),bf16 权重约 9.48 GB,Apache-2.0 许可。
  • OSWorld-Verified 两次独立跑分 65.33% 和 66.75%,取平均 66.0%;操作系统类任务 87.5%,多应用工作流 62.7%。
  • 官方对比:同一个 LibreOffice Calc 建图表任务,它用终端里的 Python 改表格 39 秒完成(6 步),纯界面操作的 Qwen3.6-27B 用了 9 分 56 秒(39 步)。
  • 在线 RL 比混合 SFT 再提升 10.16 个百分点,同时平均模型调用次数减少 13.0%、输出 token 减少 25.4%。
  • 训练数据由 Mage-CUA-Forge 生成约 29.4 万个桌面和网页任务,覆盖 6,915 种技能,单任务生成成本从 0.906 美元降到 0.158 美元。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Mage-VL-Cowork⚡ Mage-VL⚡ Qwen3-4B⚡ Qwen3.6-27B🌐 Microsoft

X 热议:Vercel CEO Guillermo Rauch 喊话「拥有你自己的智能」,呼吁本地模型继续普及、自己掌握 Agent 的 harness 与数据

Vercel CEO Guillermo Rauch 11 月 1 日在 X 上发帖:「拥有你自己的智能。任何反对这一点的人都有东西要卖给你(也许是把你自己的智能再卖回给你)。」他认为本地模型需要继续普及,超大模型暂时跑不了本地,所以最好的选择是保持选择权:自己掌握 harness、数据、连接和运行时,也就是自己的 Agent,并拥抱开源。帖子约 12 小时内获得约 2500 赞、12.8 万浏览,100 多条引用,讨论集中在本地与云端如何取舍。

核心要点速览

  • 这是 Rauch 的个人观点帖,不是 Vercel 官方公告或产品发布。
  • 原帖(2026-11-01 21:08 UTC)约 2533 赞、255 转发、266 回复、107 引用、12.8 万浏览,581 次收藏(抓取时数据)。
  • 核心主张:本地模型要继续普及;在超大模型跑不了本地之前,保持选择权,自己掌握 harness、数据、连接、运行时和 Agent,拥抱开源。
  • Maple AI 联合创始人兼 CEO Mark(@marksuman)引用回应:会是混合形态,云端永远更强,未来要把本地优先的 AI 和私有云配合起来。
  • 工程师 Shantanu Goel(@shantanugoel)引用称「Guillermo 说出了多数人不愿说的真话」,约 37 赞。
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:FT 首席数据记者 Burn-Murdoch 称美国生产率上升「不像 AI 带来的」,主要是科技裁员;Gavin Baker 反驳称看到了「AI 回报」

11 月 1 日,《金融时报》专栏作者兼首席数据记者 John Burn-Murdoch 在 X 发布长串推文并附 FT 文章,认为美国 AI 采用行业的生产率上升始于 2020 年、早于 AI 智能体,而且只在美国出现,主要来自科技公司裁员和招聘收缩,而不是 AI。该串首帖约 1,344 赞、306 转发、18.6 万浏览。Atreides Management 管理合伙人兼 CIO Gavin Baker 引用 FT 图表回应,称很难不从中看到「AI 回报」的证据,并引用 a16z 与 EPB Research 的数据,该帖约 793 赞、10.2 万浏览。Burn-Murdoch 随后回复说自己「有点拿不准」,承认数据无法排除 AI 的作用。这是对同一组数据的两种解读,不是定论。

X 热议:FT 首席数据记者 Burn-Murdoch 称美国生产率上升「不像 AI 带来的」,主要是科技裁员;Gavin Baker 反驳称看到了「AI 回报」

核心要点速览

  • 首帖:John Burn-Murdoch 的推文串,发布于 2026-11-01 15:04 UTC,约 1,344 赞、306 转发、18.6 万浏览;他的 X 简介写明是 FT 专栏作者兼首席数据记者
  • Burn-Murdoch 的核心论点:美国 AI 采用行业的生产率上升从 2020 年就开始了,2022 年的再加速也太早,「当时还是聊天机器人,不是智能体」;而且其他高收入国家同样大量用 AI,却没有出现同样的上升
  • 他把生产率拆成产出和人数两部分后认为:2022 年起的美国加速主要是科技公司裁员,产出基本在趋势线上,人数却下降了
  • 反方:Gavin Baker 的回应,约 793 赞、10.2 万浏览;他引用 EPB Research 数据称 AI 采用最深的 3 个行业生产率增速从 2.2% 升到 5%,并说美国贡献了 Anthropic 72% 的收入(均为他引用的第三方或厂商口径,本站未独立核实)
  • Burn-Murdoch 回复 Baker 时说自己「有点拿不准」:「看起来像 AI」的说法被夸大了,但数据也不能排除 AI 的作用
阅读全文
关联模型 / 智能体 / 厂商:

Artificial Analysis 发布 AA-Omniscience v1.1:题库精简到 3,000 题并公开 300 题校准集,Gemini 4 Carbon 以 54 分领跑知识与幻觉榜

独立评测机构 Artificial Analysis 10 月 31 日发布知识与幻觉基准 AA-Omniscience v1.1,作为 Intelligence Index v5 的组成部分。新版题库从 6,000 题精简为 3,000 题,删掉已公开和已饱和的题目、修正错误与歧义并补充新题,同时在 Hugging Face 公开一套 300 题、难度与私有集校准的公开集,两者 Net Score 的 Pearson 与 Spearman 相关系数均为 0.99。结果显示 Gemini 4 Carbon(high)以 54 分领先,Claude Opus 5.5 为 48、Claude Fable 5.1 为 46;Fable 5.1 准确率最高(68%),Gemini 4 Argon 幻觉率最低(4%)。模型平均比 v1 低约 1.9 分,MiniMax M3.1 Flash 下滑 22 分。以上均为 Artificial Analysis 口径。

Artificial Analysis 发布 AA-Omniscience v1.1:题库精简到 3,000 题并公开 300 题校准集,Gemini 4 Carbon 以 54 分领跑知识与幻觉榜

核心要点速览

  • 题库从 6,000 题精简到 3,000 题,覆盖 6 大领域、42 个主题:理工数学 600、软件工程 600,金融、健康、人文社科、法律各 450
  • 新的 300 题公开集已上 Hugging Face,与私有集 Net Score 的相关系数 0.99,中位差 0.0 分
  • Net Score 排名:Gemini 4 Carbon(high)54、Claude Opus 5.5 48、Claude Fable 5.1 46;开源权重最好的是 Muse Spark Open,落后 Gemini 4 Carbon 28 分
  • 准确率最高为 Claude Fable 5.1(68%),其次 Claude Opus 5.5(66%);幻觉率最低为 Gemini 4 Argon(4%)
  • 与 v1 排名的 Spearman 相关 0.98,但平均低 1.9 分;MiniMax M3.1 Flash 从 16 跌到 -6,MiMo V2.6 Pro 从 8 跌到 -5(官方口径)
阅读全文

X 热议:Shopify CEO Tobi Lütke 力挺 monorepo,公司工程师称单一代码库对编程智能体「是一大利好」,反方坚持拆仓

Shopify 杰出工程师 Burke Libbey 11 月 1 日发帖称,迁到 monorepo(单一代码库)对 Shopify 内部的智能体「是一大利好」,虽然需要配套工具、也有要花力气缓解的缺点,但他「不会回头」。这条帖子回应的是 Darren Shepherd 前一天的观点:他讨厌「monorepo 适合智能体」的说法。Shopify CEO Tobi Lütke 随后引用并讲述 Mikhail Parakhin 当年的话:每个工程师都讨厌迁 monorepo,但迁完后没人愿意去不用它的公司。Tobi 的帖子约 1,115 赞、454 收藏、8.9 万浏览,引发大量讨论。这是从业者观点,不是官方技术公告。

核心要点速览

  • 原帖:@tobi 11 月 1 日,15:39 UTC 发布,约 1,115 赞、454 收藏、95 条回复、8.9 万浏览(抓取时)
  • Shopify 杰出工程师 Burke Libbey 原话:迁 monorepo 对 Shopify 的智能体是一大利好,需要用心做工具、缺点要花力气缓解,但「不会回头」
  • 反方 Darren Shepherd(Rancher / k3s 背景)10 月 31 日发帖:讨厌「monorepo 适合智能体」的说法,认为最好的扩展方式是避免扩展
  • Mikhail Parakhin 回应 Tobi 的转述:「有了智能体,这话比以往更对」
  • 引用帖中支持方的核心理由是智能体能一次看到所有调用方、做跨栈类型检查和原子改动;也有人质疑在智能体时代是否更该保留独立演化的小仓库
阅读全文
关联模型 / 智能体 / 厂商: