AI 编程实时动态与要闻

Kimi 推出 3D Make:K3.1 Pro 可直接操作 Blender、CAD 和 Unreal/Unity/Godot 引擎建模、搭场景、做游戏

月之暗面 Kimi 官方账号 10 月 30 日 03:14(UTC)发布 3D Make,称 Kimi 可连接 Blender 和 CAD 等工具来建模、组装场景和开发游戏,已在 kimi.ai 和 Kimi Work 上线。官方同步发布的 3D 教程说明,K3.1 Pro 经过专门训练,通过 Python 脚本操作 3D 软件,即使没有 MCP 支持的专业软件也能纳入工作流;人物、动物等网格模型则自动调用 Tripo 等扩散模型生成。需要本地软件的插件仅在 Kimi Work 中可用。
Kimi 推出 3D Make:K3.1 Pro 可直接操作 Blender、CAD 和 Unreal/Unity/Godot 引擎建模、搭场景、做游戏

核心要点速览

  • 上线范围:3D Make 已在 kimi.ai 和 Kimi Work 提供,依赖本地软件的插件仅限 Kimi Work
  • 两种建模路线:参数化建模由 K3.1 Pro 写 Python 脚本完成(家具、机械件、建筑),网格建模自动调用 Tripo、Meshy、Hyper3D 等服务
  • 引擎适配:官方称已适配 Unreal Engine、Unity 和 Godot,可导入模型、搭场景、逐步实现玩法
  • 官方案例:K3.1 Pro 发布视频里的天宫场景用 Unreal Engine 5.8 制作,源模型合计 3600 万个三角形,用 Nanite 和 Lumen 渲染
  • 跑分:官方未公布 3D 相关基准,教程也承认部分任务需要多轮修改,骨骼绑定和复杂材质仍是短板
阅读全文

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

独立评测机构 Artificial Analysis 10 月 28 日发布 Intelligence Index v5,是 1 月 v4 以来最大一次改版:新增 Cognition 的 FrontierCode 2.0 和 Terminal-Bench-Science,用 HLE-Diamond 替换 Humanity's Last Exam,60% 的权重来自私有或答案保留的测试集。榜首为 Claude Opus 5.5(max)58 分,GPT-6 Astra 57、GPT-6.1 Sol 55;开源权重最高的 Kimi K3.1 Pro(权重尚未发布)46 分,与榜首差距从 v4.3 的 3 分扩大到 12 分。同时推出跨年代对比的 Progress Index v1。

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

核心要点速览

  • 总榜(官方口径):Claude Opus 5.5(max)58、GPT-6 Astra(max)57、GPT-6.1 Sol(max)55,前五名都来自 Anthropic 和 OpenAI,Gemini 4 Argon(high)50 分排第六档
  • 开源差距从 3 分扩大到 12 分:Kimi K3.1 Pro 46 分;已发布权重的 DeepSeek V4.1 Flash 1017 和 GLM-5.3(max)都是 32 分,低于 Claude Haiku 5.5(max)的 36 分
  • 成本差距超过 13 倍:前十名中 GPT-6.1 Terra(max)每任务 0.96 美元最便宜,Claude Fable 5.1(max)13.04 美元最贵;GPT-6.1 Sol 以约八分之一成本(1.27 对 10.04 美元)落后 Opus 5.5 仅 4 分
  • 四大类各占 25%:知识工作、编程(FrontierCode 2.0 占 15%、Terminal-Bench 4.0 占 10%)、科学、通用;移除 GDPval-AA v2.1、SciCode 和 AA-LCR
  • 任务更重:每任务输出 token 中位数从 35k 升到 59k;推理强度影响更大,Opus 5.5 低档 35 分、最高档 58 分,成本差 10 倍
阅读全文

Kimi 官方就 K3.1 Pro 订阅限流与额度误耗致歉:全体订阅用户一次性返还 25% 月度额度,并下调子 Agent 调用与输出长度

月之暗面官方账号 @Kimi_Moonshot 在 UTC 2026-10-25 20:14 发帖(原帖),承认 K3.1 Pro 订阅计划出现限流和不必要的额度消耗,称「这是我们的问题,本应更早修复」。补偿方案:所有计划的每位订阅用户获得一次性用量重置,返还 25% 月度额度(已用不足 25% 的直接清零),约等于一周用量,用量条将在太平洋时间当天结束前更新。官方同时调整了计划参数,减少不必要的子 Agent 调用和输出长度,让额度更耐用。

核心要点速览

  • 补偿力度:一次性返还 25% 月度额度,约等于 1 周用量(官方原帖)
  • 已用不足 25% 的用户用量直接清零,覆盖所有订阅计划
  • 生效时间:用量条在太平洋时间 10-25 当天结束前更新(约新加坡时间 10-26 15:00)
  • 根因方向:官方称将减少不必要的子 Agent 调用和输出长度,并调整计划参数
  • 背景:K3.1 Pro 于 10-23 发布,API 价格 $2/$10 每百万 token(官方口径)
阅读全文
关联模型 / 智能体 / 厂商:

月之暗面发布 Kimi K3.1 Pro:2.8T 总参 / 104B 激活的开放权重 MoE,1M 上下文,Terminal-Bench 4.0 达 65.7%,API 降至 $2/$10,权重 11 月 4 日前开放

2026-10-23(UTC 17:15,SGT 10-24 01:15),Kimi 官方账号 @Kimi_Moonshot 正式发布 Kimi K3.1 Pro,同时推出快 2–3 倍的 K3.1 Pro Highspeed,已在 Kimi.ai、Kimi Work、Kimi Code 和 Kimi API 上线,完整权重承诺 2026-11-04 前开放。官方技术博客称它是 K3 的后训练版本(更大规模多领域联合 RL),MoE 总参 2.8T、激活 104B,1M token 上下文,多模态。厂商口径跑分:Terminal-Bench 4.0 65.7%(GPT-6 Astra 58.2%、Claude Opus 5.5 66.4%),BenchCAD 带工具 92.7%。Kimi API 定价页显示 kimi-k3.1-pro 输入 $2、输出 $10、缓存命中 $0.20 每百万 token,低于 K3 的 $3/$15。

月之暗面发布 Kimi K3.1 Pro:2.8T 总参 / 104B 激活的开放权重 MoE,1M 上下文,Terminal-Bench 4.0 达 65.7%,API 降至 $2/$10,权重 11 月 4 日前开放

核心要点速览

  • MoE 总参 2.8T、激活 104B,1M token 上下文,多模态;完整权重承诺 2026-11-04 前开放(官方博客)
  • 厂商口径:Terminal-Bench 4.0 65.7%,高于 GPT-6 Astra 的 58.2%,略低于 Claude Opus 5.5 的 66.4%;内部 Kimi Code Bench 3.0 长程 61.2%(K3 为 55.95%)
  • API 定价:kimi-k3.1-pro 输入 $2 / 输出 $10 / 缓存命中 $0.20 每百万 token;Highspeed 版 $4 / $20(定价页)
  • 内部幻觉压力测试 Kimi Hallu Bench Hard:声明级幻觉率从 K3 的 23.4% 降到 8.3%(官方注明不代表日常错误率)
  • 开放权重版在中期训练和 RL 阶段移除了网络安全相关数据:xdev-bench-hard pass@3 从未处理版的 90.5% 降到 81.0%
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Kimi 官方预告视频露出 Kimi K3.1 型号:Kimi Code 终端显示 K3.1 thinking: high,演示 Three.js 3D 场景生成

2026-10-23(UTC 01:41,SGT 09:41),Kimi 官方账号 @Kimi_Moonshot 发布一段 24 秒、复古 CRT 电脑风格的纯视频帖,没有任何文字。视频开头的 Kimi Code 终端清楚显示「Model: Kimi K3.1」「Version: 2.2.0」,状态栏为「Kimi K3.1 thinking: high」,并提示「Kimi Code Desktop is here」;随后用户输入「Build a complex procedural 3D scene in Three.js.」,模型调用 Write 工具生成 ./scene.js。这是 Kimi K3.1 型号首次由官方素材露出。官方没有文字说明,也没有公布发布日期、跑分、价格或参数,因此它是预告,不等于已发布。

Kimi 官方预告视频露出 Kimi K3.1 型号:Kimi Code 终端显示 K3.1 thinking: high,演示 Three.js 3D 场景生成

核心要点速览

  • 官方预告视频中,Kimi Code 终端显示「Model: Kimi K3.1」,状态栏为「Kimi K3.1 thinking: high」,这是 K3.1 型号首次由官方素材露出
  • 视频同时露出 Kimi Code 2.2.0 版本号,并提示「Kimi Code Desktop is here」,可用 /desktop 命令或访问 kimi.com/code 安装
  • 演示任务是「Build a complex procedural 3D scene in Three.js.」,模型用 Write 工具生成 ./scene.js,全片约 24 秒
  • 官方帖无文字,发布日期、跑分、价格和参数均官方未公布,应视为预告,不是正式发布;截至 SGT 10-23 晚,该帖约 163 万展示、1.75 万点赞(X 公开数据)
阅读全文

实测揭秘并发 Sub-Agent 的代价:SWE-bench 修复率暴跌 24%,Token 消耗剧增 3.3 倍

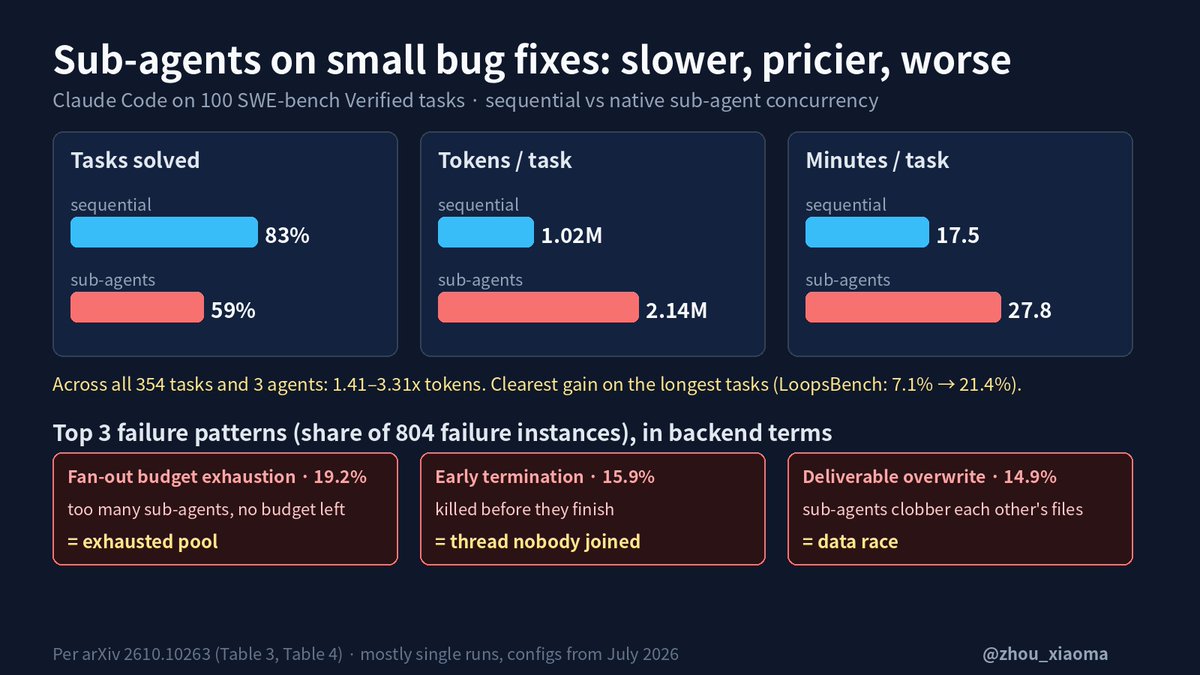
针对业内盲目推崇多智能体并发(Sub-Agent Concurrency)的狂热,最新实测研究对 Claude Code、Codex 与 Kimi Code 在开启/关闭原生 Sub-Agent 模式下进行了 2,124 次对比测试(覆盖 354 项任务,消耗超 2 万美元 API 额度)。结果显示:在 100 项标准 SWE-bench Verified Bug 修复中,开启 Sub-Agent 导致 Claude Code 成功率从 83% 骤跌至 59%,Kimi Code 从 77% 跌至 59%,且 Token 消耗激增 1.41~3.31 倍。研究揭秘了并发死锁、提前终止与文件覆盖三大致命缺陷。

实测揭秘并发 Sub-Agent 的代价:SWE-bench 修复率暴跌 24%,Token 消耗剧增 3.3 倍

核心要点速览

  • 资深研究者开展耗资 2 万美元的大规模实测,运行 2,124 次对比测试揭秘编程智能体开启 Sub-Agent 并发的真实代价
  • 在 SWE-bench Verified 100 项 Bug 修复中,开启 Sub-Agent 导致 Claude Code 成功率从 83% 跌至 59%,Kimi Code 跌至 59%
  • Token 消耗激增 1.41~3.31 倍,平均耗时从 17.5 分钟增加至 27.8 分钟,暴露预算耗尽、孤儿提前终止与文件相互覆盖三大并发缺陷
  • 仅在复杂多文件长任务(LoopsBench,7.1%→21.4%)或设立独立验证者时有净增益,建议日常常规开发维持单 Agent 顺序执行
阅读全文
关联模型 / 智能体 / 厂商:

SemiAnalysis 披露 Google 与 Inferact 首份 TPUv7 评测:TorchTPU vLLM 大核驱动 2.8T Kimi K3,高交互吞吐力压 GB200 NVL72 与 B300

半导体分析机构 SemiAnalysis 发布最新评测:Inferact(vLLM 核心团队)联合 Google 正式提交了首份基于 Google TPUv7 的 Kimi K3 2.8T 巨型 MoE 模型推理基准。在单芯片时租仅 1.21 美元(相比 GB300 2.31 美元、B300 2.26 美元、GB200 1.86 美元)下,借助 TorchTPU vLLM 大核与 TPU-Sync KVCache 卸载库,TPUv7 在 390 tok/s 超高交互区实现每美元 220 万 Token 吞吐,TCO 表现越级反超 NVIDIA GB200 NVL72、B300 与 AMD MI355X。

SemiAnalysis 披露 Google 与 Inferact 首份 TPUv7 评测:TorchTPU vLLM 大核驱动 2.8T Kimi K3,高交互吞吐力压 GB200 NVL72 与 B300

核心要点速览

  • Inferact(vLLM 核心团队)联合 Google 提交首份 Google TPUv7 Kimi K3 2.8T 巨型 MoE 推理基准
  • TPUv7 单芯片时租仅 1.21 美元,显著低于 GB300(2.31 美元)、B300(2.26 美元)与 GB200(1.86 美元)
  • 在 390 tok/s 超高交互区实现每美元 220 万 Token 吞吐,TCO 表现越级反超 NVIDIA GB200 NVL72、B300 与 AMD MI355X
  • 基于 TorchTPU vLLM 大核与 TPU-Sync KVCache 库,标志着 vLLM 在 Google TPU 架构上取得生产级重大突破
阅读全文
关联模型 / 智能体 / 厂商:

Arena Code Arena: WebDev 官方更新:DeepSeek-V4.1-Flash 登顶开源榜首,1670 分逼近 GPT-6 Sol 并击败 Claude Opus 5

Arena 官方正式发布 Code Arena: WebDev 最新榜单:深度求索最新推出的 DeepSeek-V4.1-Flash-20261017 (Max) 以 1670 分登顶开源模型第一,全面超越 Kimi K3 (Max) 且推理成本降低近 10 倍。该模型位列全榜总榜第 12,超越 Claude Opus 5 (High) 并与顶尖闭源旗舰 GPT-6 Sol (Max) 差距缩小至约 10 分以内,以百万 Token 输入 $0.3 / 输出 $1.2 的极低资费大幅改写 Pareto 前沿。

Arena Code Arena: WebDev 官方更新:DeepSeek-V4.1-Flash 登顶开源榜首,1670 分逼近 GPT-6 Sol 并击败 Claude Opus 5

核心要点速览

  • DeepSeek-V4.1-Flash-20261017 (Max) 以 1670 分斩获 Arena Code Arena: WebDev 开源模型第一名,超越 Kimi K3 (Max)
  • 位居全榜第 12 名,越级战胜顶尖商业模型 Claude Opus 5 (High),与商业旗舰 GPT-6 Sol (Max) 差距缩小至约 10 分
  • 以百万 Token 输入 $0.3 / 输出 $1.2 的极致费率颠覆性重构 Web 代码生成的 Pareto 效率前沿,成本仅为同等闭源模型的 1/10
  • 相较一个月前的 20260910 版本单月实现 +52 分的性能狂飙
阅读全文
关联模型 / 智能体 / 厂商:

南加州大学与 UCLA 推出离散空间状态追踪基准 Grid-Bench:8,928 组可执行测试揭示大模型长链推演严重失真,64 步长轨迹开闭源断崖式分化

当前 LLM 能否在复杂连续空间操作中精确预测离散物理世界的演变?南加州大学(USC)、UCLA 与 CMU 联合发布 Grid-Bench(arXiv:2610.22312,GitHub: grid-bench/Grid-Bench)。该基准基于 8 种离散几何变换规则,测试 2D/3D/4D 网格在 0 至 64 步长事件链下的全状态精确预测。对 GPT-5.6 Sol、Claude 5 Sonnet、GLM-5、Kimi K2.5 等 6 款顶尖模型的评测表明:在 64 步长轨迹下,开源与中型模型完整状态精确率几乎归零,唯闭源旗舰维持断层领先。

南加州大学与 UCLA 推出离散空间状态追踪基准 Grid-Bench:8,928 组可执行测试揭示大模型长链推演严重失真,64 步长轨迹开闭源断崖式分化

核心要点速览

  • 南加州大学、UCLA 与 CMU 联合发布可执行多维空间推理基准 Grid-Bench(arXiv:2610.22312),跨越 2D/3D/4D 网格与 8 大几何规则
  • 涵盖 8,928 组可执行测试实例,评测历史步长从 T=0 延伸至极端复杂的 T=64 步连续离散世界演变
  • 在 T=16 步中程推演中,GPT-5.6 Sol(98.0% 单元准度)与 Claude 5 Sonnet(96.8%)保持领先,中型模型精确世界命中率跌至个位数
  • 在 T=64 步极限长链下,GLM-5 与 Kimi K2.5 完全精确世界命中率归零,证实长程离散空间推演必须外挂确定性状态机
阅读全文
关联模型 / 智能体 / 厂商:

2.8 万亿参数 Kimi K3 单请求飙至 842 tok/s!NVIDIA 联合 vLLM 开源 1.2 万行 CuTe DSL 巨型融合内核,GB300 NVL72 交互吞吐暴涨 1.8 倍

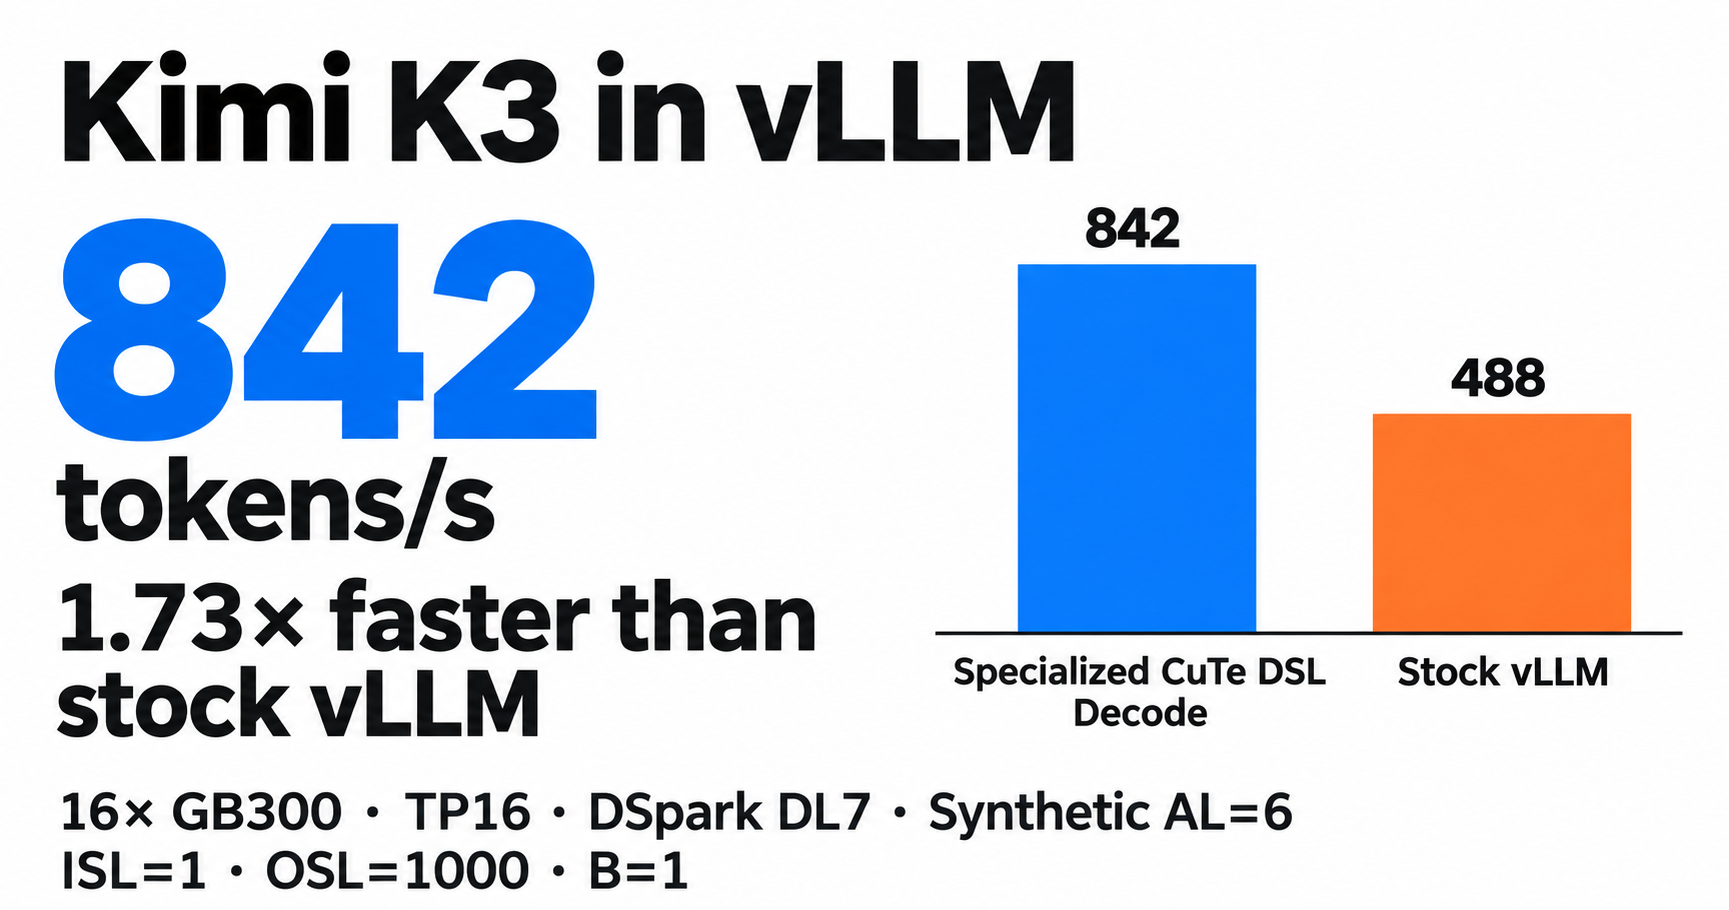
vLLM 联合 NVIDIA 正式发布面向月之暗面旗舰模型 Kimi K3(SemiAnalysis 披露达 2.8 万亿参数)的底层解码巨型内核(Megakernel):由 NVIDIA CentML 工程师采用 CuTe DSL 编写的 1.2 万行代码将注意力、MoE 路由与跨卡通信深度融合,将单层内核启动数从 23 个砍至 13 个、单层耗时从 130 µs 压至 69 µs。在 16 卡 NVIDIA GB300 NVL72 上配合 DSpark 投机解码实现 Batch=1 高达 842 tok/s 的极速输出(提速 1.73 倍),并在 SemiAnalysis AgentX 负载上实现最高 1.8 倍的 P90 单用户交互吞吐提升(突破 403.2~423 tok/s/user),下一步将适配 DeepSeek-V4.1-Flash 与 GLM-5.3。

2.8 万亿参数 Kimi K3 单请求飙至 842 tok/s!NVIDIA 联合 vLLM 开源 1.2 万行 CuTe DSL 巨型融合内核,GB300 NVL72 交互吞吐暴涨 1.8 倍

核心要点速览

  • NVIDIA CentML 联合 vLLM 为 2.8 万亿参数 Kimi K3 打造 1.2 万行 CuTe DSL 解码巨型内核,将单层内核数从 23 个减至 13 个、单层耗时从 130 µs 压至 69 µs
  • 在 16 卡 NVIDIA GB300 NVL72 上配合 DSpark 投机解码实现 Batch=1 高达 842 tok/s 输出(提速 1.73 倍),无投机 Batch=1 达 256.4 tok/s(提速 1.88 倍)
  • 在 SemiAnalysis AgentX 基准上将 P90 单用户交互吞吐提升至最高 403.2~423 tok/s/user(最高 1.8 倍提升),DeepSeek-V4.1-Flash(PR #61868)与 GLM-5.3 支持即将合入
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

vLLM 联手 NVIDIA 为 Kimi K3 定制 GB300 解码路径:batch 1 达 842 tok/s,无投机解码提速 1.3–1.9 倍

vLLM 官方博客(作者 NVIDIA 的 Benjamin Chislett)披露:借助编码 Agent 辅助开发,团队为 Kimi K3 在 NVIDIA GB300 上重写了一条 CuTe DSL 统一解码路径,把注意力、MoE 与 NVLink 通信融合,单层耗时从 130 微秒/23 个 kernel 降到 69 微秒/13 个。16 卡配合 DSpark 投机解码在 batch 1 达到 842 tok/s,是原版 vLLM 的 1.73 倍;相关 PR #61867 已于 10 月 16 日合入。

vLLM 联手 NVIDIA 为 Kimi K3 定制 GB300 解码路径:batch 1 达 842 tok/s,无投机解码提速 1.3–1.9 倍

核心要点速览

  • 16 卡 GB300 + DSpark(7 个草稿 token、合成接受长度 6)batch 1 解码 842 tok/s,原版 vLLM 为 488,提速 1.73 倍(官方口径)
  • 无投机解码时 TP16 提速 1.62–1.92 倍(batch 64 达 3,606 tok/s),TP8 提速 1.31–1.58 倍
  • 单层 kernel 从 23 个减到 13 个,耗时 130 微秒降至 69 微秒
  • AgentX 编码 Agent 负载下 P90 交互速度 403.2 对 223.7 tok/s/用户(1.8 倍),但对比基线为此前 8 卡结果
  • 同一套「快速通道」方法已扩展到 DeepSeek-V4.1-Flash(PR #61868 待合入),Muse Spark Open 早期结果超 950 tok/s/用户
阅读全文

MLE-Bench 奖牌率从 37.9% 飙至 72.7%!上海 AI Lab 开源 35B MoE 机器学习工程智能体 MLExpert,追平 Kimi-K3 与 GLM-5.3

为推动‘AI 研发 AI(AI4AI)’向模型自主导向演进,上海 AI 实验室(InternScience)开源了 35B 混合专家(MoE)机器学习工程智能体模型 MLExpert(arXiv:2610.22344)。通过构建 Kaggle-MLE Factory 可执行任务工厂、分层智能体 SFT 以及窗口化交互强化学习(WIRL),MLExpert 在 MLE-Bench Lite 上将基座模型的平均奖牌率从 37.9% 暴拉至 72.7%,以仅 35B 总参追平超大尺寸前沿模型 Kimi-K3 与 GLM-5.3,并成功泛化至智能体脚手架优化与算法调优。

MLE-Bench 奖牌率从 37.9% 飙至 72.7%!上海 AI Lab 开源 35B MoE 机器学习工程智能体 MLExpert,追平 Kimi-K3 与 GLM-5.3

核心要点速览

  • MLE-Bench Lite 奖牌率狂飙至 72.7%:将基座模型平均奖牌率从 37.9% 提升近一倍,以 35B MoE 轻量规模比肩 Kimi-K3 与 GLM-5.3
  • 首创窗口化交互强化学习(WIRL):将两次实验反馈之间的多轮决策视为独立执行窗口分配结果奖励,支持长轨迹未结束即异步更新策略
  • 泛化赋能 Agent 脚手架优化:习得的实验迭代能力零样本迁移至 NatureBench Lite、智能体脚手架调优与算法优化
阅读全文

vLLM 正式支持 NVIDIA Vera Rubin NVL72:AgentX 上 MiniMax M3 单卡吞吐达 GB200 的 7.84 倍

vLLM 团队联合 Inferact、Red Hat 与 NVIDIA 于 10 月 9 日发布 Rubin 早期支持:基于 CUDA 13.4 的每日镜像已可在 Vera Rubin NVL72 上服务 DeepSeek、Kimi、GLM、MiniMax。官方口径下,SemiAnalysis AgentX 上 MiniMax M3 同等交互性单卡吞吐最高为 GB200 的 7.84 倍;MLPerf Inference v6.1 的 VLM 项上 Qwen3-VL-235B-A22B 相对 GB300 NVL72 最高 3.7 倍。

vLLM 正式支持 NVIDIA Vera Rubin NVL72:AgentX 上 MiniMax M3 单卡吞吐达 GB200 的 7.84 倍

核心要点速览

  • 硬件对比 GB200 NVL72:NVFP4 算力 5 倍、HBM4 带宽约 2.4 倍、NVLink 双向带宽 1.7 倍,softmax 指数运算快 2–4 倍(vLLM 博文)
  • AgentX + MiniMax M3:同等交互性单卡吞吐最高 7.84 倍,150 TPS 约束下 5.18 倍(官方口径,早期结果)
  • MLPerf Inference v6.1:Qwen3-VL-235B-A22B 经 vLLM + Dynamo,相对 GB300 NVL72 最高 3.7 倍
  • CUDA 13.4 locality domain 拆分 MoE 权重,小 token decode 场景 MoE 层平均提速约 1.2 倍
  • 开箱镜像:vllm/vllm-openai:cu134-nightly(CUDA 13.4 + PyTorch 2.15)
阅读全文

Microsoft×Hugging Face 开源 ThinkingBox:507 项有状态业务工作流,按数据库终态而非「说完了」打分

微软 Copilot Studio 与 Hugging Face 于 2026-10-03 联合发布 ThinkingBox 沙箱与 ThinkingBox-Bench(507 题×每题 20 次),经隔离 MCP 会话后用可执行终态/副作用检查打分,并接入 OpenEnv。官源榜:Claude Opus 5.5 总体 pass@1 67.16%;Kimi-K3 pass@20 93.89% 但全对仅 13.41%——「一次成功≠可靠」。框架 MIT:microsoft/thinkingbox;数据 CDLA:microsoft/thinkingbox-data;论文 arXiv:2608.19741。

核心要点速览

  • 官源:HF 博客 2026-10-03 + OpenEnv docs + microsoft/thinkingbox(MIT)+ thinkingbox-data(CDLA)+ arXiv:2608.19741
  • 评测对象:507 有状态业务工作流(零售/保险/旅宿/新银行 IT/咨询),每题独立重置 MCP 会话跑 20 次
  • 核心主张:终态数据库与副作用是证据;约 67% 失败轨迹仍「干净结束」却写错字段/多副作用
  • 榜面:Opus 5.5 pass@1 67.16%;Kimi-K3 最广(pass@20 93.89%)但 20/20 仅 13.41%;可靠性成本 GPT-5.4≈$6.80/可依赖题
  • 落地:clone OpenEnv + [email protected] → Typesense + MCP Session Proxy → thinkingbox-eval
阅读全文
A
AgentField / Santosh Radha@Agent-Field·
👀81
🔥95

AgentField 开源 CodeAF v0.6:单 Go 二进制「软件工厂」专打开源模型;厂商 DeepSWE 同模对比 54.9% 居首

Agent-Field/CodeAF 以 Apache-2.0 单二进制把开源权重(DeepSeek/Qwen/GLM/Kimi 等)编成「工厂」:一窗派活、子 harness 分工、Pareto Crewing 按任务选模型。v0.6.0 发布于 2026-10-01T18:59:00Z;本跑 ★259。厂商文档:同模 DeepSeek V4 Flash 上 /senior-dev 在 DeepSWE 113 题解出 62(54.9%),单位成本标为对照 1x(有单种子与采样契约差异等限制)。

AgentField 开源 CodeAF v0.6:单 Go 二进制「软件工厂」专打开源模型;厂商 DeepSWE 同模对比 54.9% 居首

核心要点速览

  • 仓库 Agent-Field/CodeAF Apache-2.0;本跑 ★259 / forks 34;安装 curl -fsSL https://agentfield.ai/get/codeaf | bash
  • 正式标签 v0.6.0 发布于 2026-10-01T18:59:00Z;README 仍标 early preview
  • 厂商 DeepSWE 对照(同模 deepseek-v4-flash-0731,113 题):senior-dev 62/113=54.9%、每题约 22¢;mini-swe-agent 49.6%、codex 45.1%、pi 37.2%、claude-code 14.2%(见仓库 docs/benchmarks/deepswe)
  • 后续同套题:DeepSeek V4.1 Flash 上报 88/113=77.9%;Kimi K3 78/113=69.0%(仅 senior-dev,非跨 harness 对比)
  • 内置 OpenRouter/DeepSeek/GLM/Kimi/MiniMax/Qwen/Codex/Ollama;crew 默认 worker/planner/checker 三角色自动选模
阅读全文