AI 编程实时动态与要闻

OpenAI 公开自研 Git 后端 Pando:中位推送延迟降近 5 倍,每天交付近 1PB 数据,10 周用 Codex 建成

OpenAI 11 月 2 日在工程博客发布《Scaling Git at OpenAI》,介绍为单体仓库自研的 Git 兼容后端 Pando。官方口径:上线后中位推送延迟降低近 5 倍(约 80%),每天交付近 1PB Git 数据,单小时峰值超过 57TB。Pando 用 Rust 编写,由一名工程师设计核心、Codex 智能体团队实现,10 周从立项到上线,今年 4 月开始承接生产流量。起因是 Codex 让并行分支和推送暴增,旧系统可靠性一度跌破 90%。
OpenAI 公开自研 Git 后端 Pando:中位推送延迟降近 5 倍,每天交付近 1PB 数据,10 周用 Codex 建成

核心要点速览

  • 官方口径:中位推送延迟降低近 5 倍(约 80%),每天交付近 1PB Git 数据,单小时峰值超过 57TB,其中 99% 以上字节来自本地磁盘缓存。
  • 起因:Codex 让工程师并行提交更多分支和 CI 任务,旧系统从去年底开始吃紧,可靠性一度低于 90%。
  • 核心取舍:放弃全仓库一致性,改为按分支独立更新的因果一致性;推送的 packfile 原样存入 blob 存储并在后续 fetch 中复用。
  • 用 Rust 编写,1 名工程师设计核心、Codex 智能体团队实现,10 周上线;还用 GPT-6 Astra 让智能体写 Lean 和 TLA+ 形式化验证。
  • 部分 packfile-uri 等改进已合入上游 Git,OpenAI 表示正在探索把这套技术开放给用户。
阅读全文
关联模型 / 智能体 / 厂商:

百度开源 Unlimited OCR 2:SR-SWA 让超长文档解析显存与延迟近乎恒定,官方称 MarathonDocBench 77.1 分

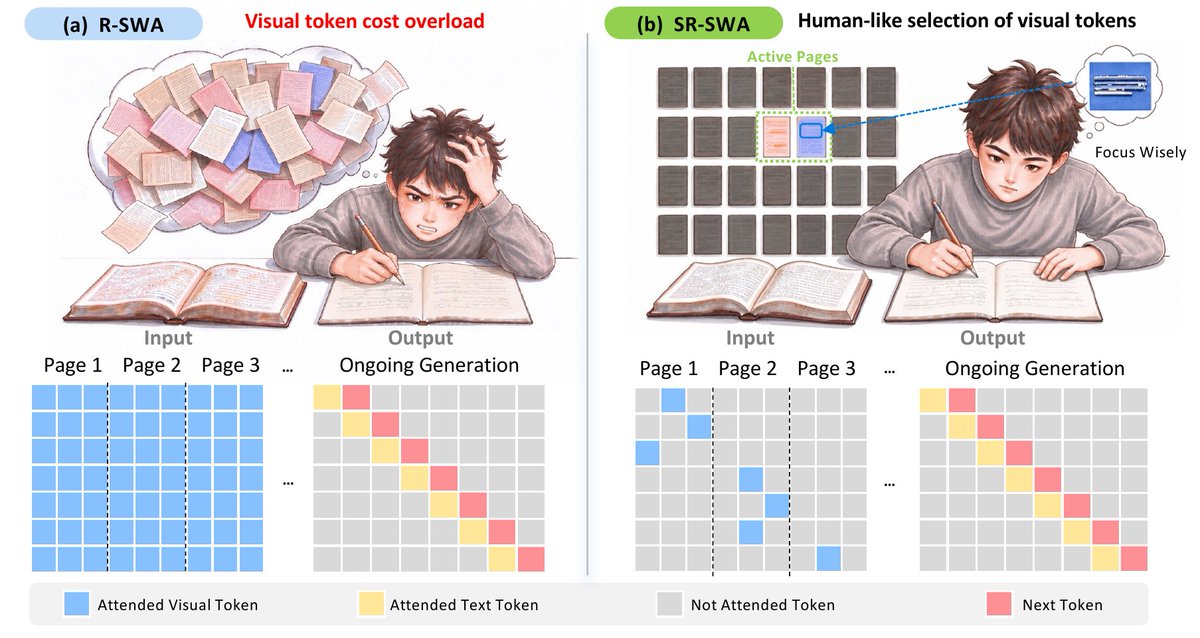
百度官方账号 @Baidu_Inc 10 月 27 日宣布开源 Unlimited OCR 2,以 MIT 协议发布在 Hugging Face。新的 SR-SWA 稀疏参考滑窗注意力把图文注意力压缩到固定大小的参考集合,官方称可在有限上下文内解析任意长度文档,在几十页的 MPDocBench 得 84.6、上百页的 MarathonDocBench 得 77.1,均为厂商自测。

百度开源 Unlimited OCR 2:SR-SWA 让超长文档解析显存与延迟近乎恒定,官方称 MarathonDocBench 77.1 分

核心要点速览

  • SR-SWA 把超长序列的图文注意力压缩到固定大小的参考集合(如 512 token),官方称每步解码延迟和显存几乎不随页数增长
  • 官方口径:MPDocBench 总分 84.6,比次优的 Qwen3.8-Max(78.3)高 6.3 分
  • 官方口径:MarathonDocBench 总分 77.1,比次优的 Kimi-K3(33.7)高 43.3 分;一代 Unlimited-OCR 在该榜为 0
  • 权重以 MIT 协议发布在 Hugging Face,约 3.3B 参数(按 HF 权重统计),支持 Transformers 和定制版 SGLang 部署
  • 所有跑分均为百度自测,尚无第三方复现
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Unlimited OCR 2⚡ Unlimited-OCR⚡ DeepSeek-OCR🌐 Baidu

Anthropic 发布智能体构建指南:多数场景应把子智能体并回单一主循环,靠 Skills 与工具按需加载;一家客户实测提速约 2 倍

Anthropic 应用 AI 团队于 2026-10-22 在 Claude 官网发布文章《Building agents: When to fold subagents into your main agent loop》,并配套开源参考实现 anthropics/single-agent-loop-kit。文章称在多个企业部署的对比中,「单一智能体 + Skills」常在质量上胜过「一个大提示词」和「多子智能体」两种设计,单任务成本和延迟往往也更低;一家客户把多智能体框架换成单循环后运行时间快了约 2 倍。Anthropic 还透露已将面向高级模型的 Claude Code 系统提示词精简 80% 以上。子智能体仍适用于上下文膨胀、需并行且用完即弃的任务、工具选择或指令冲突三种情况。该文过去两天在 X 上引发大量讨论。

Anthropic 发布智能体构建指南:多数场景应把子智能体并回单一主循环,靠 Skills 与工具按需加载;一家客户实测提速约 2 倍

核心要点速览

  • 官方原文:Building agents: When to fold subagents into your main agent loop,页面日期 2026-10-22
  • 客户实测(官方口径):一家客户把多智能体框架与单一智能体循环对比,后者运行时间快约 2 倍
  • Anthropic 称已把面向高级模型的 Claude Code 系统提示词精简 80% 以上,部分来自 Skills 与工具的渐进式披露
  • 子智能体只在 3 种情况保留:上下文膨胀导致可量化的性能下降、需要并行且可丢弃上下文的任务、工具选择困难或系统提示词指令冲突
  • 配套开源 single-agent-loop-kit:按「先测量、再合并、后折叠」三步迁移,官方起步建议 10 条黄金样例的端到端评测
阅读全文
关联模型 / 智能体 / 厂商:

Cache Engineering for Agents: 清华与港中文提出 AKV 显存工程新范式,终结长程 Agent 状态丢失与重计算

来自清华大学和香港中文大学的研究团队在 arXiv:2610.28577 中正式发布划时代论文《Cache Engineering for Agents》,并开源专用服务引擎 AKV(thu-nics/AKV)。针对自主 Agent 在多轮长轨迹交互中,因传统“上下文工程(Context Engineering)”修剪文本导致前缀 KV 缓存彻底失效、引发高昂重预填(Re-prefilling)开销与关键记忆遗忘的痛点,论文提出“显存缓存工程(Cache Engineering)”。通过引入 drop(剔除显存中过期 Token)与 repos(位置编码重对齐)两大底层原语,配合 AKV 状态感知基数树引擎,在保持长程记忆的同时将 Agent 推理成本大幅削减 27.7%,P95 请求延迟提速 1.5 倍,基准测试准确率提升 1.7 分。

Cache Engineering for Agents: 清华与港中文提出 AKV 显存工程新范式,终结长程 Agent 状态丢失与重计算

核心要点速览

  • 清华大学与港中文团队在 arXiv:2610.28577 提出智能体显存工程(Cache Engineering)全新理论体系
  • 指出传统上下文工程(Prompt 截断与摘要)会破坏前缀一致性,导致 KV 缓存失效并产生巨大二次重计算开销
  • 引入 drop(显存局部淘汰)与 repos(旋转位置编码动态平移)两大底层原语,实现显存级无感精准瘦身
  • 开源 AKV 状态感知推理引擎(thu-nics/AKV),实测将 Agent 推理成本降低 27.7%,P95 延迟提速 1.5 倍,基准得分提升 1.7 分
阅读全文
AD赞助内容

NVIDIA 官宣 OpenShell 智能体安全参考架构:硬件级隔离安全护栏,终结 Agent 越权操作隐患

在 GTC Berlin 大会上,NVIDIA 官方正式发布 OpenShell 智能体安全参考架构与全新的 Agent Knowledge Foundation 套件。针对自主 AI 智能体(Autonomous Agents)在拥有系统写权限、数据库查询与终端执行能力后,极易因提示词注入或失控执行产生越权访问机密数据、发起破坏性命令的行业痛点,OpenShell 基于硬件级隔离信任根(Hardware-Isolated Security)构建了严密的运行时安全边界。系统能够以纳秒级开销实时监控并拦截智能体跨越授权边界的工具调用与数据交互,成为企业级安全可靠智能体调度的基石标准。

NVIDIA 官宣 OpenShell 智能体安全参考架构:硬件级隔离安全护栏,终结 Agent 越权操作隐患

核心要点速览

  • NVIDIA 在 GTC Berlin 峰会重磅发布 OpenShell 参考架构,以硬件级安全隔离为自主智能体划定不可逾越的运行边界
  • 提供全生命周期运行时动态拦截机制,在智能体试图访问非授权数据库、外发敏感 Token 或执行越权脚本时实现硬核阻断
  • 无缝整合 NVIDIA Agent Toolkit 与全新的 Agent Knowledge Foundation,打通企业知识库安全鉴权与合规审计链路
  • 彻底破解企业在生产环境部署高权限 Coding Agent 与自动化运维智能体(SRE)的安全合规合流难题
阅读全文
关联模型 / 智能体 / 厂商:

Krafton AI 开源 Raon-1 mini 30B MoE 模型:4B 激活参数性能媲美 Muse Glimmer,全面开放 Apache 2.0 权重

韩国知名游戏巨头 Krafton 旗下人工智能研究院 Krafton AI 正式公开了其自主从头预训练的代码与智能体轻量级模型 Raon-1 mini。该模型采用总参数量 300 亿(30B)、单 Token 仅激活 40 亿(4B)的稀疏混合专家(MoE)拓扑,遵循宽松的 Apache 2.0 开源许可证。官方同步开源了专用的 DFlash 快速投机解码模型与可在线体验的交互沙盒。实测显示,Raon-1 mini 在复杂编程、命令行排障与多轮工具调用智能体基准上全面对标 Meta 最新推出的 Muse Glimmer,而单卡显存占用与推理延迟显著更优。

Krafton AI 开源 Raon-1 mini 30B MoE 模型:4B 激活参数性能媲美 Muse Glimmer,全面开放 Apache 2.0 权重

核心要点速览

  • Krafton AI 正式开源 Raon-1 mini(Apache 2.0),采用 30B 总参、4B 激活参数的高效稀疏 MoE 架构
  • 完全从头自主训练,在多步编程、环境交互与 Agent 工具编排基准上追平 Meta 开源的 Muse Glimmer
  • 同步发布基于 DFlash 的配套投机草稿模型(Draft Model),大幅缩减端侧部署环境下的单步解码时延
  • 全面开放免费在线交互体验 Demo(raon-mini.krafton.ai),为轻量化游戏 AI 与本地桌面 Agent 提供开源新基座
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Raon-1 mini⚡ Muse Glimmer🌐 Krafton AI

可玩游戏世界模型新架构:Matrix-Game 4.0 解耦可执行游戏状态与视觉生成,破解长程一致性与规则执行

研究团队在 arXiv:2610.27999 中正式发布第四代交互式游戏世界模型系统 Matrix-Game 4.0。针对当前基于视频扩散模型的生成式世界普遍停留在“仅视觉受控”、缺乏持久游戏状态(World State)、无法严密执行游戏规则(如碰撞检测、计分、死亡判定)以及超高交互延迟的根本缺陷,Matrix-Game 4.0 提出了“游戏执行与视觉生成彻底解耦”的创新架构。通过轻量级可执行游戏脚手架维护物理与规则,驱动高帧率自回归视频生成骨干网络,在 100% 保障游戏可玩性与状态持久一致的同时,实现了真正实时的沉浸式游戏世界交互体验。

可玩游戏世界模型新架构:Matrix-Game 4.0 解耦可执行游戏状态与视觉生成,破解长程一致性与规则执行

核心要点速览

  • Matrix-Game 4.0 正式发布(arXiv:2610.27999),提出将游戏可执行逻辑与视觉生成解耦的世界模型全新技术路线图
  • 构建轻量可执行游戏脚手架(Game Harness),由确定性引擎负责持久状态与规则演算,彻底终结视频世界模型物理幻觉
  • 实现了从单纯“受控视频播放”到“真正具备可玩性与规则约束的交互世界”的质的飞跃,长程场景与状态一致性达成 100%
  • 在动作到画面的超低延迟交互渲染下稳定维持高帧率,为次世代 AI 驱动的无代码游戏创作与数字孪生提供核心基础设施
阅读全文
关联模型 / 智能体 / 厂商:

Mistral 正式发布 Voxtral 3 语音大模型套件与实时 Voice-Agent API:端到端延迟低至 500 毫秒

Mistral AI 正式推出 Voxtral 3 语音多模态大模型家族与配套的实时 Voice-Agent API。该套件包含 40 亿参数的 Mini 转录模型、超越 Whisper 与 Gemini 3.5 的 Small 转录模型,以及基于 LiveKit 的端到端语音智能体 SDK。系统支持 50 种语言高精听写与说话人分离、跨 35+ 语言带情感标签的情感语音合成(TTS)以及 30 分钟音频专业级声音克隆。在 Artificial Analysis 独立基准评测中,Small Transcribe 3 以 2.1% 极低字错率登顶全球语音识别榜单季军,Realtime 转录单步延迟低至 500ms 以内,每分钟语音智能体调度成本低至 0.04 美元。

Mistral 正式发布 Voxtral 3 语音大模型套件与实时 Voice-Agent API:端到端延迟低至 500 毫秒

核心要点速览

  • Mistral 官方正式发布 Voxtral 3 全栈语音多模态模型家族,包含转录、情感 TTS、专业声音克隆与实时 Voice-Agent SDK
  • 在 Artificial Analysis 独立实测中,Small Transcribe 3 斩获 2.1% 极低错词率,击败 ElevenLabs Scribe v2(2.2%)与 Grok Voice 2.0(2.3%)
  • Realtime Transcribe 3 响应时间压缩至 500ms 以内,端到端完整语音 Agent 回合交互延迟突破 1 秒大关
  • 极致价格革命:Mini 转录每分钟仅需 0.0035 美元,搭配 Mistral Small 4 调度的全托管语音智能体每分钟仅 0.04 美元
阅读全文
关联模型 / 智能体 / 厂商:

Hao AI Lab 开源 FastH3 Omni:把 MiniMax H3 蒸馏到 8 步,多参考音视频生成端到端延迟降低 5.6–11.9 倍

10 月 20 日,UCSD Hao AI Lab 的 FastVideo 团队开源 FastH3 Omni,这是 MiniMax H3 参考生成音视频(Ref2VA)模型的蒸馏版,可同时用文本、最多 9 张图、视频片段和人声参考生成带同步立体声的视频。采样从 50 步降到 8 次 transformer 计算,官方在 8 张 GB200 上测得端到端延迟降低 5.6–11.9 倍,训练代码一并开源,并提供面向 DGX Spark、RTX 5090 的 NVFP4 权重和 ComfyUI 支持。

Hao AI Lab 开源 FastH3 Omni:把 MiniMax H3 蒸馏到 8 步,多参考音视频生成端到端延迟降低 5.6–11.9 倍

核心要点速览

  • 步数:8 次 transformer 计算,基座 MiniMax H3 为 50 步,采用 PDD + DMD 蒸馏
  • 速度(官方口径):27 组对照负载、8×GB200,端到端延迟降低 5.6–11.9 倍;例如 15 秒单图请求 139.69 秒降到 14.14 秒
  • 输入:最多 9 张图、3 段视频、3 段音频,合计不超过 12 个参考;输出 24 FPS 视频 + 32kHz 立体声
  • 本地运行:DGX Spark(128GB)和 RTX 5090(32GB)用 NVFP4 QAD 权重,默认 480p;RTX 4090 可用 FP8 版
  • 许可:沿用 MiniMax-H3 Community License,不是 Apache/MIT
阅读全文
关联模型 / 智能体 / 厂商:

Perplexity 官宣 Perplexity Computer 登陆 macOS:本地大模型与端侧 Agent 深度整合,实现 100% 离线 Mac 控制

Perplexity 官方正式宣布将 Perplexity Computer 功能原生集成至 macOS 客户端应用中。与此前高度依赖云端传输屏幕截图并接收键盘鼠标动作指令的传统 Computer-Use 方案不同,Perplexity Computer 实现了模型与智能体执行回路的全本地化运行(The model and the agent both run on your Mac)。通过深度调用 macOS 原生辅助功能(Accessibility API)与本地端侧轻量多模态模型,该功能消除了云端网络延迟,并在彻底保护用户屏幕隐私的前提下,赋能智能体在用户桌面上全自主操作本地应用、整理文件与执行跨软件复杂工作流。

Perplexity 官宣 Perplexity Computer 登陆 macOS:本地大模型与端侧 Agent 深度整合,实现 100% 离线 Mac 控制

核心要点速览

  • Perplexity 官方正式在 macOS 客户端推出 Perplexity Computer,实现模型推理与智能体循环全本地运行
  • 彻底打破传统云端 GUI Agent 的隐私隐患,屏幕画面与按键事件无需上传服务器,100% 杜绝敏感数据外泄
  • 零云端往返时延(Zero Cloud RTT),利用 Apple Silicon 统一内存与硬件神经引擎,实现极速桌面响应
  • 深度结合 macOS 原生无障碍体系与应用沙盒,支持跨终端、浏览器与本地开发套件的端到端自动化编排
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

vLLM-Omni 宣布整合 PhysisServe:物理世界与视频扩散模型推理加速,4.1 毫秒极速输出

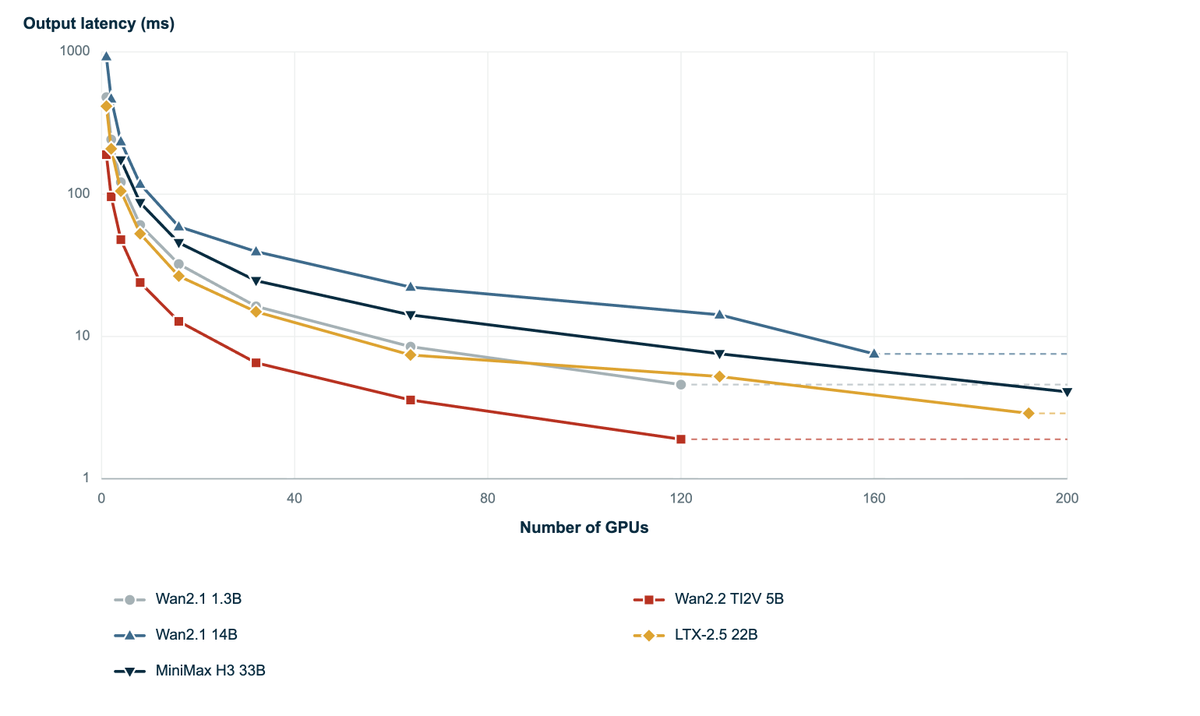
vLLM 官方项目组正式宣布将 PhysisServe 的核心推理加速架构整合至 vLLM-Omni 多模态全能推理引擎中。针对物理世界 AI、视频扩散生成与具身大模型在长程去噪阶段面临的高显存占用与高延迟痛点,PhysisServe 创新性提出去噪步与 Transformer 跨块流水线并行(Block Pipelining)、时间分片批处理与虚拟秩联合调度。在 200 张 GPU 集群上对 MiniMax H3 33B 展开实测,实现每 4.1 毫秒输出一个 Chunk(折合千帧/秒渲染),Wan2.2 5B 单卡单请求延迟从 173 毫秒降至 98 毫秒。

vLLM-Omni 宣布整合 PhysisServe:物理世界与视频扩散模型推理加速,4.1 毫秒极速输出

核心要点速览

  • vLLM 官方宣布将 PhysisServe 核心加速架构合流至 vLLM-Omni,专精于物理世界大模型与视频扩散生成推理
  • 首创去噪步与 Transformer 跨块流水线并行(Block Pipelining)与时间分片批处理,彻底消除多卡通信气泡
  • 在 200 卡集群上 MiniMax H3 33B 达成每 4.1 毫秒产出单 Chunk(纯 DiT 计算达千帧/秒),Wan2.2 5B 单卡时延降至 98 毫秒
  • 24 卡集群并发承载能力暴增 1.7~3.3 倍,代码已全面开源至 GitHub 并即将进入 vLLM-Omni 正式版
阅读全文
关联模型 / 智能体 / 厂商:

实测揭秘并发 Sub-Agent 的代价:SWE-bench 修复率暴跌 24%,Token 消耗剧增 3.3 倍

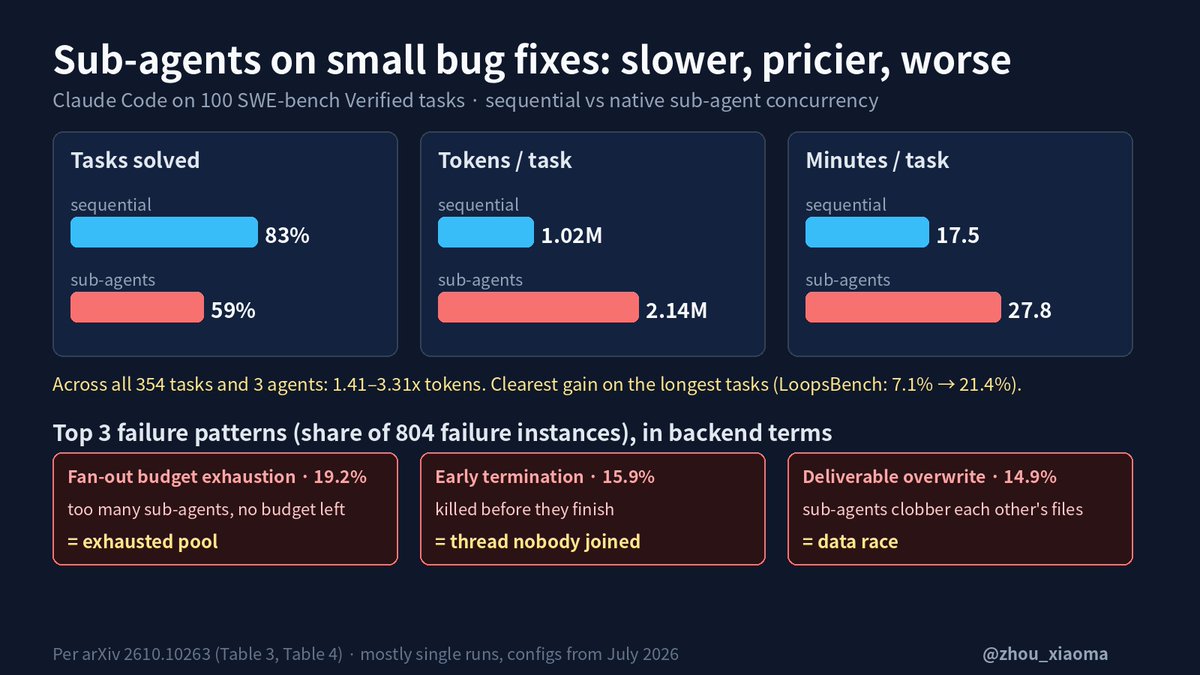
针对业内盲目推崇多智能体并发(Sub-Agent Concurrency)的狂热,最新实测研究对 Claude Code、Codex 与 Kimi Code 在开启/关闭原生 Sub-Agent 模式下进行了 2,124 次对比测试(覆盖 354 项任务,消耗超 2 万美元 API 额度)。结果显示:在 100 项标准 SWE-bench Verified Bug 修复中,开启 Sub-Agent 导致 Claude Code 成功率从 83% 骤跌至 59%,Kimi Code 从 77% 跌至 59%,且 Token 消耗激增 1.41~3.31 倍。研究揭秘了并发死锁、提前终止与文件覆盖三大致命缺陷。

实测揭秘并发 Sub-Agent 的代价:SWE-bench 修复率暴跌 24%,Token 消耗剧增 3.3 倍

核心要点速览

  • 资深研究者开展耗资 2 万美元的大规模实测,运行 2,124 次对比测试揭秘编程智能体开启 Sub-Agent 并发的真实代价
  • 在 SWE-bench Verified 100 项 Bug 修复中,开启 Sub-Agent 导致 Claude Code 成功率从 83% 跌至 59%,Kimi Code 跌至 59%
  • Token 消耗激增 1.41~3.31 倍,平均耗时从 17.5 分钟增加至 27.8 分钟,暴露预算耗尽、孤儿提前终止与文件相互覆盖三大并发缺陷
  • 仅在复杂多文件长任务(LoopsBench,7.1%→21.4%)或设立独立验证者时有净增益,建议日常常规开发维持单 Agent 顺序执行
阅读全文
关联模型 / 智能体 / 厂商:

Modal 将用 NVIDIA Vera CPU 跑 Agent 沙箱:高并发下吞吐最高达同级 x86 的 2 倍

Modal 10 月 19 日发布博客,宣布将为 Modal Sandboxes 引入 NVIDIA 的 Arm 架构 Vera CPU,这是它首次走出纯 x86 机群。Modal 用 50 个 Terminal-Bench 任务自建了 Agentless Agent Bench,测得在大量并发容器下,Vera 的任务吞吐最高可达同级 x86 GNR 机器的 2 倍,单任务延迟持平或更低(厂商口径)。空载串行时 Vera 优势并不明显。这批算力主要服务后台编码 Agent 和强化学习 rollout。

Modal 将用 NVIDIA Vera CPU 跑 Agent 沙箱:高并发下吞吐最高达同级 x86 的 2 倍

核心要点速览

  • 吞吐:高并发下 Vera 任务吞吐最高为同级 x86 GNR 机器的 2 倍,单任务延迟持平或更低(Modal 早期测试,厂商口径)。
  • 基准:Agentless Agent Bench 由 50 个 Terminal-Bench 官方解法与校验器组成,去掉网络调用,只测编译、grep、git、设备模拟等 CPU 工作。
  • 空载串行:50 个任务里 Vera 常常更快但并非总是,领先幅度不大;优势主要出现在资源争抢时。
  • 原因:Modal 认为 Vera 的高内存带宽让每核可多塞容器而不降频;增加 CPU 数量时 x86 方案提前到达吞吐平台期。
  • 落地:这是 Modal 首次支持 Arm,需要改造基础设施和镜像构建;官方未公布上线时间和价格。
阅读全文

2.8 万亿参数 Kimi K3 单请求飙至 842 tok/s!NVIDIA 联合 vLLM 开源 1.2 万行 CuTe DSL 巨型融合内核,GB300 NVL72 交互吞吐暴涨 1.8 倍

vLLM 联合 NVIDIA 正式发布面向月之暗面旗舰模型 Kimi K3(SemiAnalysis 披露达 2.8 万亿参数)的底层解码巨型内核(Megakernel):由 NVIDIA CentML 工程师采用 CuTe DSL 编写的 1.2 万行代码将注意力、MoE 路由与跨卡通信深度融合,将单层内核启动数从 23 个砍至 13 个、单层耗时从 130 µs 压至 69 µs。在 16 卡 NVIDIA GB300 NVL72 上配合 DSpark 投机解码实现 Batch=1 高达 842 tok/s 的极速输出(提速 1.73 倍),并在 SemiAnalysis AgentX 负载上实现最高 1.8 倍的 P90 单用户交互吞吐提升(突破 403.2~423 tok/s/user),下一步将适配 DeepSeek-V4.1-Flash 与 GLM-5.3。

2.8 万亿参数 Kimi K3 单请求飙至 842 tok/s!NVIDIA 联合 vLLM 开源 1.2 万行 CuTe DSL 巨型融合内核,GB300 NVL72 交互吞吐暴涨 1.8 倍

核心要点速览

  • NVIDIA CentML 联合 vLLM 为 2.8 万亿参数 Kimi K3 打造 1.2 万行 CuTe DSL 解码巨型内核,将单层内核数从 23 个减至 13 个、单层耗时从 130 µs 压至 69 µs
  • 在 16 卡 NVIDIA GB300 NVL72 上配合 DSpark 投机解码实现 Batch=1 高达 842 tok/s 输出(提速 1.73 倍),无投机 Batch=1 达 256.4 tok/s(提速 1.88 倍)
  • 在 SemiAnalysis AgentX 基准上将 P90 单用户交互吞吐提升至最高 403.2~423 tok/s/user(最高 1.8 倍提升),DeepSeek-V4.1-Flash(PR #61868)与 GLM-5.3 支持即将合入
阅读全文
关联模型 / 智能体 / 厂商:

零生成 Token 提速 5.6 倍!MJev-Spatial 原生注意力匹配登顶 HuggingFace 热榜,港中大 CarryOn 双环具身框架将违规率砍至 6.1%

针对视觉语言模型(VLM)在空间感知中依赖自回归文本生成导致的高延迟,以及具身 VLA 模型缺乏个性化与物理安全兜底的难题,今日两项重磅开源成果给出解法:MJev-Spatial(arXiv:2610.22276,HF 350 赞登顶)复用骨干 Q/K 投影将空间判断转化为单次前向分类,零新增参数提速 5.6 倍并在 12 项基准斩获 65.64% 第一;港中大贾佳亚团队 CarryOn(arXiv:2610.21453)以规划-执行双环 Harness 将机器人安全违规率从 52.6% 降至 6.1%,故障恢复成功率从 13% 飙至 80%。

零生成 Token 提速 5.6 倍!MJev-Spatial 原生注意力匹配登顶 HuggingFace 热榜,港中大 CarryOn 双环具身框架将违规率砍至 6.1%

核心要点速览

  • MJev-Spatial 复用 VLM 原生 Q/K 投影将三类空间感知任务统一为单次前向分类,生成 0 个 Token,推理较 Qwen3.5-4B 基座提速 5.6 倍,12 项空间基准均分达 65.64%
  • 联合粗到细 Teacher Forcing 监督与长度感知全局批处理,使 MJev-Spatial 在 1,230 万空间问答对上的训练吞吐提升 30.8%
  • 港中大贾佳亚团队 CarryOn 双环具身 Harness 将安全微调后 VLA 的违规率从 52.6% 压降至 6.1%,物理失败自主恢复成功率从 13% 提升至 80%
阅读全文
关联模型 / 智能体 / 厂商: