AI 编程实时动态与要闻

Pruna 开源 P-H3-Image:把 MiniMax-H3 视频模型改造成图像生成/编辑模型,8 步出图、提速 5 倍、体积缩小 7 倍

11 月 3 日,模型压缩公司 Pruna AI 开源 P-H3-Image:基于 MiniMax 今夏开源的 MiniMax-H3 视频模型,改造成文生图与图像编辑模型。官方口径:采样步数从 50 步降到 8 步,4MP 图在单张 B200 上从 12.4 秒降到 2.6 秒;4-bit 版下载 20GB(H3 为 143GB),8MP 峰值显存约 21GB;支持 2–16MP 输出和多图参考编辑。权重已上 Hugging Face,ComfyUI 原生支持。注意它沿用 MiniMax H3 社区许可,欧盟、英国、韩国和美国默认不在授权范围内。

Pruna 开源 P-H3-Image:把 MiniMax-H3 视频模型改造成图像生成/编辑模型,8 步出图、提速 5 倍、体积缩小 7 倍

核心要点速览

  • 速度(官方口径):8 步替代 50 步;单张 B200 上 4MP 图 12.4 秒→2.6 秒,8MP 图 30.6 秒→5.8 秒;L40S 上 4-bit 版 4MP 约 6.3 秒
  • 体积:Transformer 从 33B 缩到 20B 参数,文本编码器从 32B 蒸馏到 4B(67GB→9GB);下载包 bf16 55GB、4-bit 20GB,H3 原版 143GB
  • 显存:8MP 出图峰值 bf16 约 56GB、4-bit 约 21GB;带提示词改写器的 diffusers bf16 管线约需 100GB
  • 能力:输出 2–16MP,最擅长写实/纪实摄影、电影剧照、动漫与短文字平面设计;支持多图参考编辑(X 帖写 8 张,博客写 9 张)
  • 许可:MiniMax H3 社区许可,欧盟、英国、韩国、美国需另行向 MiniMax 取得授权,产品须标注 “Powered by MiniMax H3”
阅读全文
关联模型 / 智能体 / 厂商:
⚡ P-H3-Image⚡ MiniMax-H3⚡ Qwen3.5-9B🌐 Pruna AI🌐 MiniMax🌐 Hugging Face🌐 ComfyUI

Artificial Analysis 发布 AA-Omniscience v1.1:题库精简到 3,000 题并公开 300 题校准集,Gemini 4 Carbon 以 54 分领跑知识与幻觉榜

独立评测机构 Artificial Analysis 10 月 31 日发布知识与幻觉基准 AA-Omniscience v1.1,作为 Intelligence Index v5 的组成部分。新版题库从 6,000 题精简为 3,000 题,删掉已公开和已饱和的题目、修正错误与歧义并补充新题,同时在 Hugging Face 公开一套 300 题、难度与私有集校准的公开集,两者 Net Score 的 Pearson 与 Spearman 相关系数均为 0.99。结果显示 Gemini 4 Carbon(high)以 54 分领先,Claude Opus 5.5 为 48、Claude Fable 5.1 为 46;Fable 5.1 准确率最高(68%),Gemini 4 Argon 幻觉率最低(4%)。模型平均比 v1 低约 1.9 分,MiniMax M3.1 Flash 下滑 22 分。以上均为 Artificial Analysis 口径。

Artificial Analysis 发布 AA-Omniscience v1.1:题库精简到 3,000 题并公开 300 题校准集,Gemini 4 Carbon 以 54 分领跑知识与幻觉榜

核心要点速览

  • 题库从 6,000 题精简到 3,000 题,覆盖 6 大领域、42 个主题:理工数学 600、软件工程 600,金融、健康、人文社科、法律各 450
  • 新的 300 题公开集已上 Hugging Face,与私有集 Net Score 的相关系数 0.99,中位差 0.0 分
  • Net Score 排名:Gemini 4 Carbon(high)54、Claude Opus 5.5 48、Claude Fable 5.1 46;开源权重最好的是 Muse Spark Open,落后 Gemini 4 Carbon 28 分
  • 准确率最高为 Claude Fable 5.1(68%),其次 Claude Opus 5.5(66%);幻觉率最低为 Gemini 4 Argon(4%)
  • 与 v1 排名的 Spearman 相关 0.98,但平均低 1.9 分;MiniMax M3.1 Flash 从 16 跌到 -6,MiMo V2.6 Pro 从 8 跌到 -5(官方口径)
阅读全文

Pika 发布开放权重视频模型 Pika H3 Flex:基于 MiniMax H3 后训练,6 步出片、5 轨音频分轨,API 起价 0.01 美元/秒

Pika 于 10 月 29 日发布 Pika H3 Flex,这是在 MiniMax H3 基础上后训练的音视频一体生成模型,权重已上架 Hugging Face、代码开源在 GitHub,并支持 ComfyUI 和 Diffusers。官方称它把去噪步数从 50 步蒸馏到 6 步,在 768p 下 DiT 去噪平均比 Fal H3 Max 快约 1.8 倍,15 秒带配乐片段最快约 7 秒生成;托管 API 额外提供 1080p 到 4K 超分和对白、配乐、音效、拟音、环境声 5 条可导出音轨。以上速度与质量数据均为官方口径。

Pika 发布开放权重视频模型 Pika H3 Flex:基于 MiniMax H3 后训练,6 步出片、5 轨音频分轨,API 起价 0.01 美元/秒

核心要点速览

  • 定价(官方口径):文/图生视频起价 0.01 美元/输出秒,参考生视频起价 0.03 美元/秒;官方对比表中 MiniMax H3 为 0.08 美元/秒、Seedance 2.5 为 0.103 美元/秒
  • 速度(官方口径):6 步采样,768p 下 DiT 去噪平均比 Fal H3 Max 快约 1.8 倍,10–15 秒文/图生视频约 2 倍;8 张 B300 上 5 秒 768p 生成全流程提速 1.60 倍
  • 排名:官方产品页称在 DesignArena 文生视频榜得分 1293、总第 7,是榜上最高的开放权重模型
  • 开源形态:Hugging Face 标注为基于 MiniMax-H3 的 adapter,许可证为 other;本地推理原生支持 480p/768p 与混合立体声,4K 超分和分轨音频仅在托管 API 提供
  • 支持最多 12 个参考输入(图、音、视频、草图等),以及风格迁移、动作迁移、角色替换、局部编辑等下游任务
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Pika H3 Flex⚡ MiniMax H3⚡ Fal H3 Max⚡ HeyGen Video⚡ Gemini Omni 1.1 Flash🌐 Pika🌐 MiniMax

X 热议:Sam Altman 称个人电脑占用稀缺 DRAM「相当糟糕」,本地推理派强烈反弹

Stripe 联合创始人 John Collison 的 Cheeky Pint 播客 10 月 29 日上线 Sam Altman 专访。谈到内存短缺时,Altman 说很多人以为开源模型加本地推理就能绕开算力紧张,但从全球配置角度看,让每个人电脑里放着一堆稀缺 DRAM、只有约 5% 的时间在用「相当糟糕」,供给紧张时应追求云端的最大利用率。pubity 转述这段话的帖子获得 2.6 万多点赞、800 多万次浏览,大量用户反驳称 PC 内存并非只为 AI 服务,本地模型还关乎隐私和离线可用。以下按观点讨论整理,不代表已证实结论。

X 热议:Sam Altman 称个人电脑占用稀缺 DRAM「相当糟糕」,本地推理派强烈反弹

核心要点速览

  • 出处:Cheeky Pint 播客 10 月 29 日 Sam Altman 专访,官方文字稿可查,原话含「being used 5% of the time」
  • Altman 的论点:DRAM 供给紧张时,放在个人电脑里的内存利用率低,云端数据中心可持续服务多用户,应追求最大利用率
  • 热度(X API,10 月 31 日 13:06 SGT 读取):pubity 帖 26,124 赞、8,557 条引用、5,210 条回复、约 806 万次浏览
  • 主要反驳:PC 内存还要跑系统、浏览器和游戏;本地模型让数据留在本机;也有人指出这与 OpenAI 的云端商业模式一致
  • 5% 这个数字 Altman 未解释口径,媒体建议当作粗略估计而非测量值
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

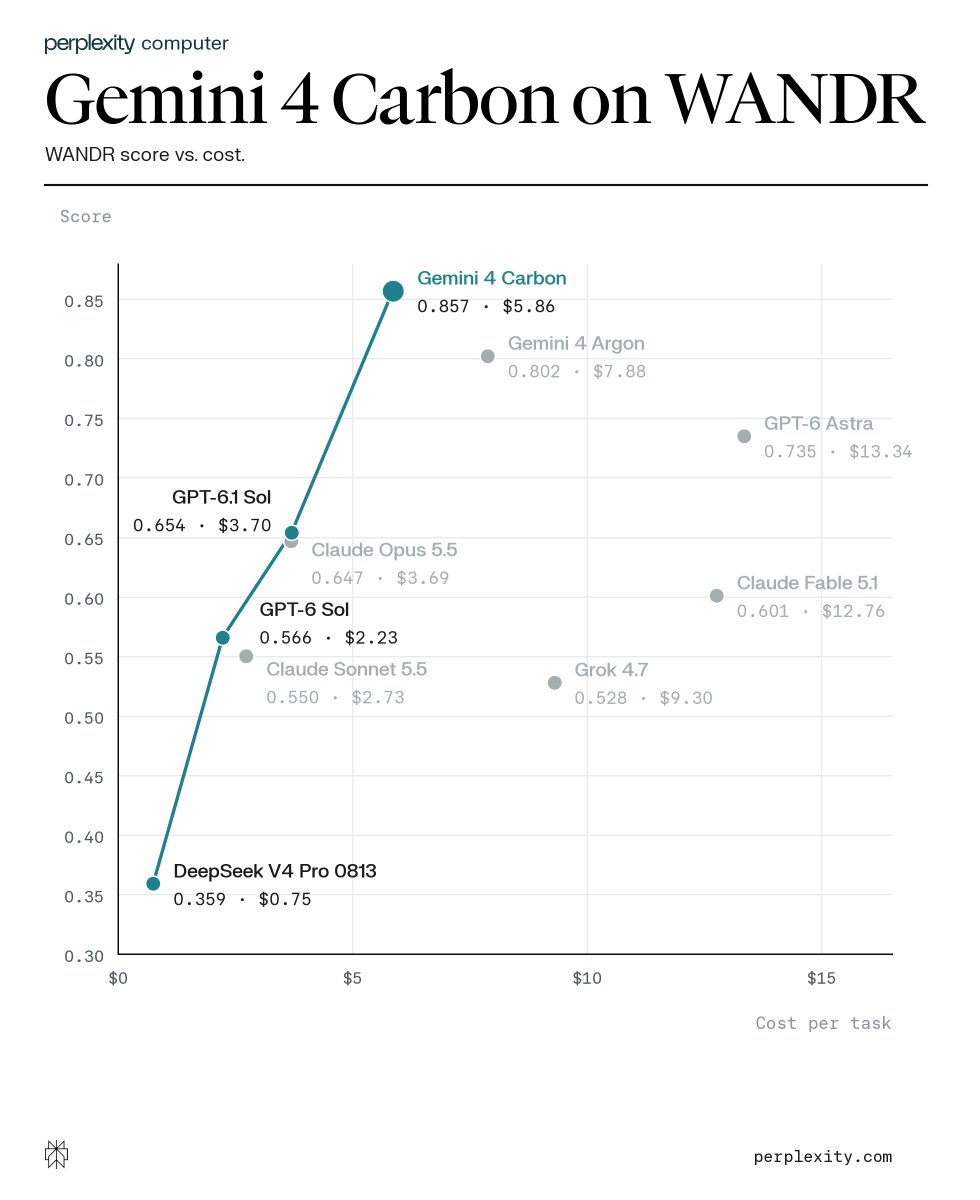
Perplexity CEO 公布 Gemini 4 Carbon 早期评测:WANDR 深度研究基准 0.857 创新高,每任务 5.86 美元,高于 Argon 和 GPT-6 Astra

Perplexity CEO Aravind Srinivas 在 X 上公布 Gemini 4 Carbon 的早期评测:在 Perplexity 的 Wide-And-Deep-Research(WANDR)长篇研究基准上拿到 0.857,创新高,每任务成本 5.86 美元;Gemini 4 Argon 为 0.802(7.88 美元),GPT-6 Astra 为 0.735(13.34 美元)。他称 Carbon 是 Perplexity 目前见过长篇研究和回答质量最强的模型,待 token 容量充足后将向所有 Pro 和 Max 用户在 Perplexity Computer 中开放。

Perplexity CEO 公布 Gemini 4 Carbon 早期评测:WANDR 深度研究基准 0.857 创新高,每任务 5.86 美元,高于 Argon 和 GPT-6 Astra

核心要点速览

  • WANDR 得分(Perplexity 口径):Gemini 4 Carbon 0.857、Gemini 4 Argon 0.802、GPT-6 Astra 0.735、GPT-6.1 Sol 0.654、Claude Opus 5.5 0.647、Claude Fable 5.1 0.601
  • 成本更低:Carbon 每任务 5.86 美元,低于 Argon 的 7.88 美元和 GPT-6 Astra 的 13.34 美元
  • 性价比曲线:DeepSeek V4 Pro 0813(0.359,0.75 美元)、GPT-6 Sol(0.566,2.23 美元)、GPT-6.1 Sol(0.654,3.70 美元)和 Carbon 构成 Perplexity 图中的成本前沿
  • Claude Sonnet 5.5 为 0.550(2.73 美元),Grok 4.7 为 0.528(9.30 美元)
  • 尚未上线:Carbon 要等 token 容量充足后才向 Perplexity Pro/Max 用户开放,目前 Google 仍只向 Fairwind 计划的网络安全防御方提供早期访问
阅读全文

Claude API 上线 Usage and Cost Analytics API 测试版,可按模型、API Key、调用者拆分用量与成本;单次请求上限提到 128 MB

据 Claude 官方 API 更新日志,10 月 29 日 Anthropic 推出 Usage and Cost Analytics API 测试版,新增 /v1/organizations/analytics/usage 和 /analytics/cost 两个端点,可按模型、工作区、API Key 以及发起请求的用户或服务账号筛选、分组,按分钟、小时或天出时间序列;旧的 Usage and Cost API 转为 legacy 但继续支持。10 月 28 日,第一方 Claude API 的 Messages 和 Token Counting 接口单次请求上限从 32 MB 提高到 128 MB。

核心要点速览

  • 新 API 需带 beta 头 analytics-usage-cost-2026-08-24,两个端点分别返回 token/请求数和美元成本(据官方文档)
  • group_by 最多 5 个维度,时间桶可选 1m、1h、1d,每个筛选条件最多传 100 个值
  • Claude Console 和 Claude Enterprise 组织共用同一套端点和字段;AWS 与 Google Cloud(Anthropic 托管)上也可调用
  • 旧 Usage and Cost API 及 Enterprise Analytics 的 4 个用量/成本报表端点转为 legacy,仍继续支持并提供迁移指南
  • 10 月 28 日起,Messages API 和 Token Counting API 单次请求上限从 32 MB 提到 128 MB(约 4 倍),仅限第一方 Claude API
阅读全文
关联模型 / 智能体 / 厂商:

Claude 订阅改名:Max 5x 改叫 Max,Max 20x 改叫 Ultra,已验证的 Ultra 账号取消 5 小时额度限制

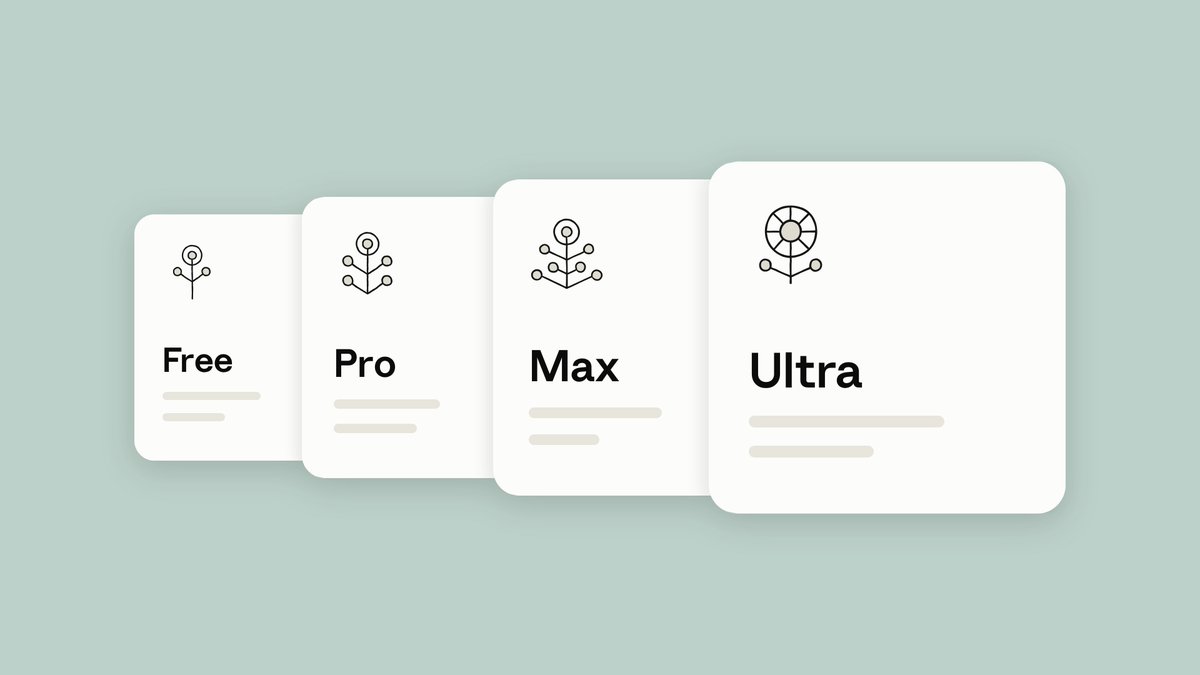
Anthropic 官方账号 @claudeai 于 10 月 30 日宣布:Max 5x 更名为 Max(仍为每月 100 美元),Max 20x 更名为 Ultra(仍为每月 200 美元),现有订阅者无需操作。同时,已验证的 Ultra 账号从当天起取消 5 小时滚动额度限制,先覆盖大部分老订阅者;较新的账号在验证前保留临时限制,每周额度不变。

Claude 订阅改名:Max 5x 改叫 Max,Max 20x 改叫 Ultra,已验证的 Ultra 账号取消 5 小时额度限制

核心要点速览

  • 价格不变:Max 每月 100 美元,Ultra 每月 200 美元,Pro 按月付为 20 美元(据 claude.com/pricing)
  • 定价页显示:Max 为 Pro 的 5 倍用量(每 5 小时和每周),Ultra 为 Pro 每周用量的 10 倍且无 5 小时限制(仅限已验证账号)
  • 两档都含每月 API 额度:Max 100 美元,Ultra 200 美元;Fable 模型最多可用掉每周额度的一半
  • 新账号在完成验证前保留临时 5 小时限制,官方称是为防欺诈和滥用,解除后会发邮件通知
  • 每周额度不变;官方未公布验证的具体条件和完成时间
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Claude Fable⚡ Claude Opus⚡ Claude Sonnet🤖 Claude Code🌐 Anthropic

GitHub Universe 2026:Copilot Fusion 正式 GA,自动路由与编排多模型,Fusion Max 在 Artificial Analysis 编码智能体指数拿 60 分,成本约为 Claude Code + Opus 5.5 Max 的一半

GitHub 10 月 28 日在 Universe 2026 宣布 Copilot Fusion 正式可用(GA)。它把此前研究预览的 Project HydraFusion 多模型编排和 Copilot auto 模型选择合并:用户在模型选择器里选 Copilot Fusion 和努力档位(Standard / High / Max),由系统按任务决定用哪些模型、走 Single、Cascade 还是 Critique 流程。官方称 Fusion Max 在 Artificial Analysis 编码智能体指数得 60 分,比 Claude Code + Opus 5.5 Max 低 2 分,但每任务 API 成本约一半、token 约一半、耗时少约 40%。按所用模型标准价计费,付费用户到 11 月 30 日享 30% 折扣。

GitHub Universe 2026:Copilot Fusion 正式 GA,自动路由与编排多模型,Fusion Max 在 Artificial Analysis 编码智能体指数拿 60 分,成本约为 Claude Code + Opus 5.5 Max 的一半

核心要点速览

  • 跑分(Artificial Analysis 编码智能体指数 v2.0):Fusion Max 60 分,Claude Code + Opus 5.5 Max 62 分;每任务成本 5.59 美元对 11.42 美元,Devin Fusion 组合 62 分、8.00 美元
  • 分项:Terminal-Bench 4.0 得 71 分略领先;FrontierCode 51 分排第三(Claude Code 56、Devin Fusion 54);SWE-Atlas-QnA-AA 57 分偏弱
  • 效率:每任务约 720 万 token,约为 Claude Code + Opus 5.5 的一半,比 Devin Fusion 少 30%;GitHub 称耗时少约 40%
  • 模型池含 Claude Opus 5.5、Claude Sonnet 5.5、GPT-6 Astra、GPT-6 Sol 等;管理员可单独禁用某模型供 Fusion 使用,并把 Fusion 设为默认
  • 可用范围:所有 Copilot 套餐,VS Code、Copilot app、Copilot CLI 和 JetBrains;原 auto / HydraFusion / HydraFusion Max 设置自动迁移到对应档位
阅读全文

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

独立评测机构 Artificial Analysis 10 月 28 日发布 Intelligence Index v5,是 1 月 v4 以来最大一次改版:新增 Cognition 的 FrontierCode 2.0 和 Terminal-Bench-Science,用 HLE-Diamond 替换 Humanity's Last Exam,60% 的权重来自私有或答案保留的测试集。榜首为 Claude Opus 5.5(max)58 分,GPT-6 Astra 57、GPT-6.1 Sol 55;开源权重最高的 Kimi K3.1 Pro(权重尚未发布)46 分,与榜首差距从 v4.3 的 3 分扩大到 12 分。同时推出跨年代对比的 Progress Index v1。

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

核心要点速览

  • 总榜(官方口径):Claude Opus 5.5(max)58、GPT-6 Astra(max)57、GPT-6.1 Sol(max)55,前五名都来自 Anthropic 和 OpenAI,Gemini 4 Argon(high)50 分排第六档
  • 开源差距从 3 分扩大到 12 分:Kimi K3.1 Pro 46 分;已发布权重的 DeepSeek V4.1 Flash 1017 和 GLM-5.3(max)都是 32 分,低于 Claude Haiku 5.5(max)的 36 分
  • 成本差距超过 13 倍:前十名中 GPT-6.1 Terra(max)每任务 0.96 美元最便宜,Claude Fable 5.1(max)13.04 美元最贵;GPT-6.1 Sol 以约八分之一成本(1.27 对 10.04 美元)落后 Opus 5.5 仅 4 分
  • 四大类各占 25%:知识工作、编程(FrontierCode 2.0 占 15%、Terminal-Bench 4.0 占 10%)、科学、通用;移除 GDPval-AA v2.1、SciCode 和 AA-LCR
  • 任务更重:每任务输出 token 中位数从 35k 升到 59k;推理强度影响更大,Opus 5.5 低档 35 分、最高档 58 分,成本差 10 倍
阅读全文

Cursor 上线 DeepSeek V4.1 Flash:CursorBench 4.0 四档推理全部落在成本前沿,Max 档 47.7%、每任务 $0.98

Cursor 官方 10 月 27 日(SGT)宣布 DeepSeek V4.1 Flash 已在 Cursor 中可用,在 Cursor Settings > Models 打开即可。Cursor 称该模型每一档推理强度都落在 CursorBench 成本前沿上:每任务 $0.60 到 $0.98,在这个价位没有模型得分更高。官方 CursorBench 4.0 榜单显示,DeepSeek V4.1 Flash 1017 Max 档 47.7%($0.98/任务),Medium 46.3%($0.80),High 45.6%($0.77),Low 44.9%($0.60);同榜最高分 Opus 5.5 Max 为 57.8%,但每任务 $13.43。

Cursor 上线 DeepSeek V4.1 Flash:CursorBench 4.0 四档推理全部落在成本前沿,Max 档 47.7%、每任务 $0.98

核心要点速览

  • 四档跑分(CursorBench 4.0 官方榜):Max 47.7%/$0.98、Medium 46.3%/$0.80、High 45.6%/$0.77、Low 44.9%/$0.60,Max 档在全榜排第 17
  • 性价比对比:Max 档 47.7% 与 Sonnet 5.5 High(47.8%,$1.20)几乎持平但便宜约 18%;Opus 5.5 Max 高约 10 个百分点,但每任务 $13.43,约是它的 13.7 倍
  • 同价位对手:Haiku 5.5 Max 48.4%/$1.12、Haiku 5.5 Extra High 44.3%/$0.56,DeepSeek 正好卡在两者之间的价格段
  • 代价是 token 和步数:Max 档平均每任务约 53.7 万 token、187 步,Sonnet 5.5 High 只用约 3.7 万 token、41 步,长任务时延要有心理预期
  • 开启方式:Cursor Settings > Models 里打开;有个反直觉细节,Medium 档(46.3%)比 High 档(45.6%)分数略高、价格只贵 $0.03
阅读全文
AD赞助内容

OpenAI 发布 GPT-6.1 Terra:主打快速低价的电脑操作,API 每百万 token $1/$5,比 GPT-5.6 Terra 和 GPT-6.1 Sol 便宜一半

OpenAI 10 月 26 日发布 GPT-6.1 Terra,定位是兼顾视觉推理、精确电脑操作和自然写作的高效模型,今天起向 ChatGPT Work 和 Codex 的 Plus、Pro、Enterprise、Edu 用户开放,API 模型名 gpt-6.1-terra。标准 API 价格为输入 $1、缓存输入 $0.05、输出 $5(每百万 token),官方称比 GPT-5.6 Terra 和 GPT-6.1 Sol 低 50%;上下文 1,050,000 token。官方口径下,它在 Agents' Last Exam 上中等推理强度比 GPT-5.6 Terra 高 15 个百分点、成本约三分之一,Terminal-Bench 4.0 最高强度 50.3%。

OpenAI 发布 GPT-6.1 Terra:主打快速低价的电脑操作,API 每百万 token $1/$5,比 GPT-5.6 Terra 和 GPT-6.1 Sol 便宜一半

核心要点速览

  • 价格(官方文档):输入 $1、缓存输入 $0.05、30 分钟缓存写入 $1.25、输出 $5 每百万 token;单次输入超过 272K token 时整单输入按 2 倍、输出按 1.5 倍计费;Batch/Flex 半价,Fast 模式 2 倍
  • 规格:上下文 1,050,000 token,最大输入 922,000、最大输出 128,000,知识截止 2026-06-01;reasoning.effort 支持 none 到 max 六档,工具调用需走 Responses API
  • 电脑操作(官方口径):Agents' Last Exam 中等强度比 GPT-5.6 Terra 高 15 个百分点、成本约 1/3,与 GPT-6 Astra 持平但每 token 价格只有其 1/10;完成速度比 GPT-6 Astra 和 GPT-6.1 Sol 快 3 倍以上
  • 编程与事实性(官方口径):Terminal-Bench 4.0 最高强度 50.3%,是 GPT-5.6 Terra 公布成绩 21.5% 的两倍多;内部易错题集低强度错误率从 53.6% 降到 16.7%
  • 安全:官方称在 Preparedness Framework 网络安全项达到 Critical 阈值,沿用 GPT-6 Astra 的防护措施
阅读全文

Block 发布 Dessa:只用人类对话语音从零训练的全双工语音模型,可在 MacBook Pro M4 Max 本地实时运行

2026-10-23(UTC 16:53,SGT 10-24 00:53),Block 官方账号 @blocks 发布 Dessa,Jack Dorsey 随后转发称其为「迄今最真实的全双工语音模型」。官方页面 block.xyz/dessa 介绍:Dessa 是真正的语音到语音模型,训练数据只有人类对话录音,不用文本、不用任何预训练模型;全双工,能边听边说,会自然插话和附和(“yeah!”“got it!”),推理快于实时,可在 MacBook Pro M4 Max 或更高配置上本地运行。官方称只用一套 NVIDIA GB200 NVL72 完成训练,学习语言所需的词量比 LLM 少数百倍。目前没有公开 API 或权重,只向一小批 AI 安全研究者开放早期访问。

Block 发布 Dessa:只用人类对话语音从零训练的全双工语音模型,可在 MacBook Pro M4 Max 本地实时运行

核心要点速览

  • 训练数据只有人类对话语音:无文本、无预训练模型,从零训练(官方页面)
  • 全双工语音到语音:边听边说,会插话、附和,能直接听出并表达情绪、讽刺、笑声
  • 推理快于实时,可在 MacBook Pro M4 Max 或更高配置上本地运行
  • 官方称训练只用了一套 NVIDIA GB200 NVL72,学语言所需词量比 LLM 少数百倍
  • 暂无公开 API、权重或第三方跑分;目前只向少量 AI 安全研究者开放早期访问
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Dessa🌐 Block

Artificial Analysis 发布 Coding Agent Index v2.0:用 Cognition 的 FrontierCode 替换 DeepSWE,Claude Code + Opus 5.5 以 61.7 分居首

Artificial Analysis 于 2026-10-23 发布 Coding Agent Index v2.0,评测对象是「模型 + Agent 外壳」的组合,覆盖 290 道任务,三项基准等权:Cognition 的 FrontierCode v1.1(100 道真实开源仓库任务,按维护者是否会合并打分)取代 DeepSWE v1.1,SWE-Atlas-QnA 改为评分更严格的 SWE-Atlas-QnA-AA,Terminal-Bench 4.0 不变。Claude Code + Claude Opus 5.5(max)以 61.7 分居首,Sonnet 5.5 59.3、Muse Wonder Full 58.9 紧随。新版整体分数下降:21 个两版都测过的配置平均分从 54.8 降到 47.4。

Artificial Analysis 发布 Coding Agent Index v2.0:用 Cognition 的 FrontierCode 替换 DeepSWE,Claude Code + Opus 5.5 以 61.7 分居首

核心要点速览

  • 榜首:Claude Code + Claude Opus 5.5(max)61.7,Claude Sonnet 5.5(max)59.3,Muse Code + Muse Wonder Full(max)58.9,Claude Fable 5.1(max with fallback)57.6(Artificial Analysis 口径)
  • FrontierCode v1.1 上 Opus 5.5 拿到 56.0%,领先 Codex + DeepSeek V4.1 Flash 的 52.6%;24 个配置中有 15 个挤在 43%–49%
  • 新旧版对比:21 个配置平均分 54.8 → 47.4,其中 20 个下降;同一批配置 FrontierCode 平均 45.1%,DeepSWE 为 65.6%
  • 成本前沿四个点:DeepSeek V4.1 Flash 47.3 分 $0.39/任务、GPT-6.1 Sol 54.1 分 $1.50、GPT-6 Astra 54.7 分 $7.04、Opus 5.5 61.7 分 $11.42(按 API 按量计费,不是订阅价)
  • SWE-Atlas-QnA-AA 改写了 1,306 条评分细则中的 127 条,裁判换成 GPT-6 Luna(xhigh)每条 5 票,数据集和裁判配置已在 Hugging Face 公开
阅读全文

Artificial Analysis 发布权威医疗基准 HealthBench 与 MLCR-AA:首曝长回复偏差(Verbosity Bias)对模型排名的严重失真

国际权威模型独立评测机构 Artificial Analysis 正式发布针对医疗专业领域的权威评测基准 HealthBench Professional 与消除长度偏差的全新指数 MLCR-AA。评测揭示了一个震撼业界的普遍现象:传统基于 LLM-as-a-Judge 的评估机制存在严重的“长回复字数偏好(Verbosity Bias)”——模型回答越长越容易被判定为优秀。在原始 HealthBench 中,Anthropic 模型的回答平均比竞品长 4 到 6 倍,Claude Opus 5.5 以 71.4% 斩获第一;然而在通过长度归一化严密矫正的 MLCR-AA 榜单中,GPT-6 Astra(Max)与 Claude Sonnet 5.5 并列全球第一,而 Claude Opus 5.5 的真实排名则直接从第 1 位暴跌至第 6 位,为全球大模型评测的公正性敲响了警钟。

Artificial Analysis 发布权威医疗基准 HealthBench 与 MLCR-AA:首曝长回复偏差(Verbosity Bias)对模型排名的严重失真

核心要点速览

  • Artificial Analysis 发布 HealthBench Professional 与长度校准评测集 MLCR-AA
  • 深度揭示评测盲区:大模型裁判(LLM-as-a-Judge)严重倾向冗长回复,Anthropic 回答平均较竞品长 4~6 倍
  • 在原始 HealthBench 中 Claude Opus 5.5 凭字数优势以 71.4% 暂列第一(Sonnet 70.8%, GPT-6 Astra 69.7%)
  • 在去除字数偏见的 MLCR-AA 权威修正榜中,GPT-6 Astra 与 Sonnet 5.5 并列榜首,Opus 5.5 真实位次直降至第 6
阅读全文

SolarRenderer 突破结构化视频生成:4 步去噪极速渲染灰模与深度图,768p 实时流式合成高保真世界

来自新加坡国立大学(NUS)、香港中文大学(深圳)等机构的研究团队在 arXiv:2610.28630 正式发布视频生成渲染框架 SolarRenderer。针对当前 3D 游戏引擎灰模、姿态骨骼、深度图与点云难以极速转化为高保真视觉视频的难题,SolarRenderer 基于冻结的 MiniMax-H3 33B 基础视频模型,引入轻量化控制 LoRA 与 4 步生成 LoRA。利用结构引导分布匹配算法,仅需 4 步去噪即可完成高质量渲染(比传统 50 步采样提速 12.3 倍),并提出块因果(Block-Causal)变体,成功实现 768p 高清视频的毫秒级实时流式生成,为下一代神经游戏引擎与虚拟制片树立了全新标杆。

SolarRenderer 突破结构化视频生成:4 步去噪极速渲染灰模与深度图,768p 实时流式合成高保真世界

核心要点速览

  • SolarRenderer(arXiv:2610.28630)发布,实现基于粗糙 3D 几何(灰模、骨骼、深度、网格)的高保真视频极速渲染
  • 冻结 MiniMax-H3 33B 视频底座,仅微调轻量 Control LoRA 与 4-step LoRA,保持基座生成能力的同时强化几何控制
  • 仅需 4 步去噪采样即可完成高保真视频渲染,生成速度较传统 50 步扩散采样提速惊人的 12.3 倍
  • 研发块因果(Block-Causal)注意力流式架构,在工业级 GPU 上实现 768p 分辨率视频实时连续生成
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MiniMax-H3⚡ SolarRenderer