AI 编程实时动态与要闻

Artificial Analysis 发布 Endpoint Accuracy Index v1.1:100+ 无服务器端点近 1/4 低于参考权重部署

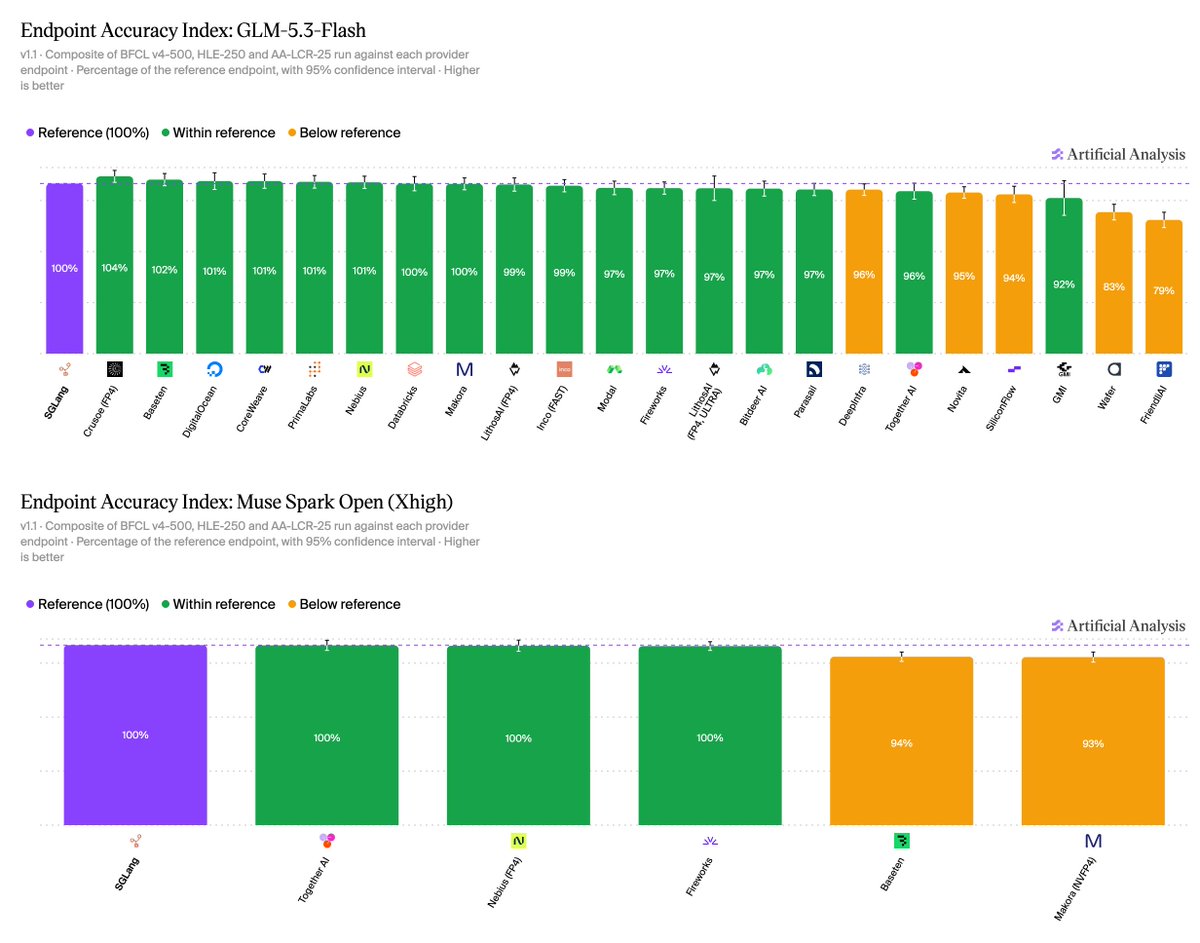
2026-11-06,Artificial Analysis 发布 Endpoint Accuracy Index v1.1:以自建官方权重部署为 100% 参考,用 BFCL-500、HLE-250、AA-LCR-25(等权)衡量各厂商 serverless 端点保住了多少精度。官方口径:已测 100+ 端点中近四分之一低于参考;AA-LCR-25 升至 v1.1 且重复从 10 提到 25(平均 95% CI 约 ±4.7→±2.6);覆盖扩至六款开源权重模型,新增 GLM-5.3 Flash 与 Muse Spark Open。
Artificial Analysis 发布 Endpoint Accuracy Index v1.1:100+ 无服务器端点近 1/4 低于参考权重部署

核心要点速览

  • 官方:@ArtificialAnlys 2026-11-06 02:44 UTC;changelog 05 Nov 2026;方法论页 Endpoint Accuracy Index v1.1
  • 厂商口径:100+ serverless 端点中近 1/4 低于自建参考;服务商常为速度/成本做量化、自定义 kernel、调栈或限输出
  • 套件等权:BFCL v4-500(3 次)、HLE-250(10 次)、AA-LCR-25(25 次);相对参考给 95% 置信区间并标注是否显著偏低
  • GLM-5.3 Flash:22 端点中 16 个与参考统计一致、1 个约 104.2;约 32K 输出上限端点 HLE-250 约 22%/29% vs 参考 55%
  • Muse Spark Open:5 端点中 3 个约 99.5–99.9(含 FP4);另 2 个主要在工具调用掉分(BFCL-500 约 50%/51% vs 59%)
阅读全文
C
CMU Infini-AI LabInfini-AI-Lab·
👀4
🔥87

CMU Infini-AI 连发 CompressionBench / ServerBench:编码 Agent 自主压模型与设计推理服务;Sonnet 5.5 达 vLLM 约 4.87×「美元/美元」

卡内基梅隆 Infini-AI Lab 于 arXiv(2026-11-04)发布孪生基准:CompressionBench 考编码 Agent 在存储限额内交付可验证压缩权重与推理代码(36 次提交 29 次通过,最优设计较 BF16 平均 PPL 仅高约 3.4%);ServerBench 考完整 LLM 服务系统设计,目标为延迟达标 token 价值 / GPU 美元。11 模型×3 部署中 Claude Sonnet 5.5 在 Gemma E4B 上达 2.97「美元/美元」,约为 vLLM 基线 4.87 倍;33 次运行 22 次通过验证。

核心要点速览

  • 官方:arXiv:2611.06858 CompressionBench + arXiv:2611.06841 ServerBench(CMU Infini-AI Lab)
  • CompressionBench:6 Agent × 6 设定,36 提交中 29 通过独立验证;最优设计平均 PPL 较 BF16 高约 3.4%
  • ServerBench:目标「美元/美元」= 延迟达标 token 价值 / GPU 成本;状态化回放真实编码会话
  • 厂商表口径:Claude Sonnet 5.5 在 Gemma E4B 达 2.97,约 vLLM 基线 4.87×;33 跑 22 验证通过
  • 代码:github.com/Infini-AI-Lab/Compression-Bench 与 Server-Bench
阅读全文
关联模型 / 智能体 / 厂商:

FrontierPhysics 发布:42 位物理学家贡献 56 项端到端研究任务,Claude Opus 5.5 通过率约 27.4%,主要卡在严谨推理与专家直觉

BenchFlow 团队于 11 月 5 日公开 FrontierPhysics(arXiv:2611.06910):由 42 位物理学家基于本人研究贡献 56 项任务,覆盖 9 个领域;智能体需完成文献、计划、实验与可验证产出及论文。22 个模型、26 种配置下,没有任何配置在 168 次 rollout 中通过超过 46 次;最高约 27.4%(Claude Opus 5.5 + Claude Code)。人工复盘显示主要短板是严谨推理与专家直觉,而非缺物理知识。Artificial Analysis 表示将合作托管评测。

FrontierPhysics 发布:42 位物理学家贡献 56 项端到端研究任务,Claude Opus 5.5 通过率约 27.4%,主要卡在严谨推理与专家直觉

核心要点速览

  • 规模:56 项任务、42 位作者、26 所机构、9 个物理领域;182 份投稿中录用 56;18 项基于已发表论文(含 4 篇 Nature)
  • 评测:确定性 verifier + 专家 rubric(blocker/非 blocker);通过需全部 verifier 与 blocker 通过
  • 结果:22 模型 / 26 配置;没有任何配置在 168 次 rollout 中通过超过 46 次;最高约 27.4%(Opus 5.5 + Claude Code,论文口径)
  • 失败模式:严谨推理约 48%、专家直觉约 34%、文献综合约 27%;物理知识缺口不是主因(GPT-6 Astra 人工复盘)
  • 生态:可用 BenchFlow 跑评测;Artificial Analysis 将合作托管;论文 arXiv:2611.06910
阅读全文

Gemini API 的 Computer Use 工具正式 GA:浏览器、移动端、桌面三类智能体可上生产,接口与预览版无破坏性变更

Gemini API 更新日志显示,Computer Use 工具已于 10 月 30 日在 Interactions 与 GenerateContent 两套 API 上正式 GA;@GoogleAIStudio 11 月 4 日官宣称与预览版相比没有破坏性变更,可用于生产级浏览器、移动端与桌面控制智能体。官方文档列出支持模型:Gemini 4 Argon、推荐的 Gemini 3.8 Flash、Gemini 3.5 Flash-Lite 及 Gemini 3 Flash Preview;动作附带 intent 推理说明,并提供 safety_decision 确认机制和可选的截图提示注入检测。

核心要点速览

  • 10 月 30 日起 Computer Use 在 Interactions 与 GenerateContent API 同时 GA
  • 官方称与预览版无破坏性变更,已有代码可直接沿用
  • 支持浏览器、移动端、桌面三种环境;推荐模型为 Gemini 3.8 Flash
  • 每个动作带 intent 字段;safety_decision 可要求用户确认或直接拦截
  • 可选开启截图提示注入检测(Gemini 3.5 Flash-Lite 及以上,默认关闭)
阅读全文
AD赞助内容

Notion:用 MCP 给 ChatGPT / Claude / Muse / Bot 一套共享记忆与 Skills,官方推送 Agent 安装引导

11 月 4 日 Notion 官方账号宣布:通过 Notion MCP,ChatGPT、Claude、Muse、Bot 等可读写同一套 Memories 与 Skills,形成跨 Agent 的「共享大脑」。配套开发者安装引导(setup prompt v0.0.6,10 月 30 日)与帮助文档,帮助页与案例博客均可核验。

Notion:用 MCP 给 ChatGPT / Claude / Muse / Bot 一套共享记忆与 Skills,官方推送 Agent 安装引导

核心要点速览

  • NotionHQ 原帖(11-04 19:14 UTC)约 3,271 赞、225 转发、4,560 收藏、约 58.9 万浏览(抓取时数据)
  • 产品主张:ChatGPT / Claude / Muse / Bot 共用 Notion 里的 Memories 与 Skills,换 Agent 不必从零解释
  • 官方 setup prompt v0.0.6(2026-10-30):可引导创建 Agent Operating Guide,并把自定义指令写入 ChatGPT / Claude 设置
  • 帮助中心:Notion MCP 支持 Claude、Cursor、ChatGPT Pro 等;Enterprise 可审批白名单并治理连接
  • 厂商案例博客(11-03):五家团队用 MCP 把工作流沉淀为可复用 SOP;Skills via MCP 官方称「即将推出」
阅读全文

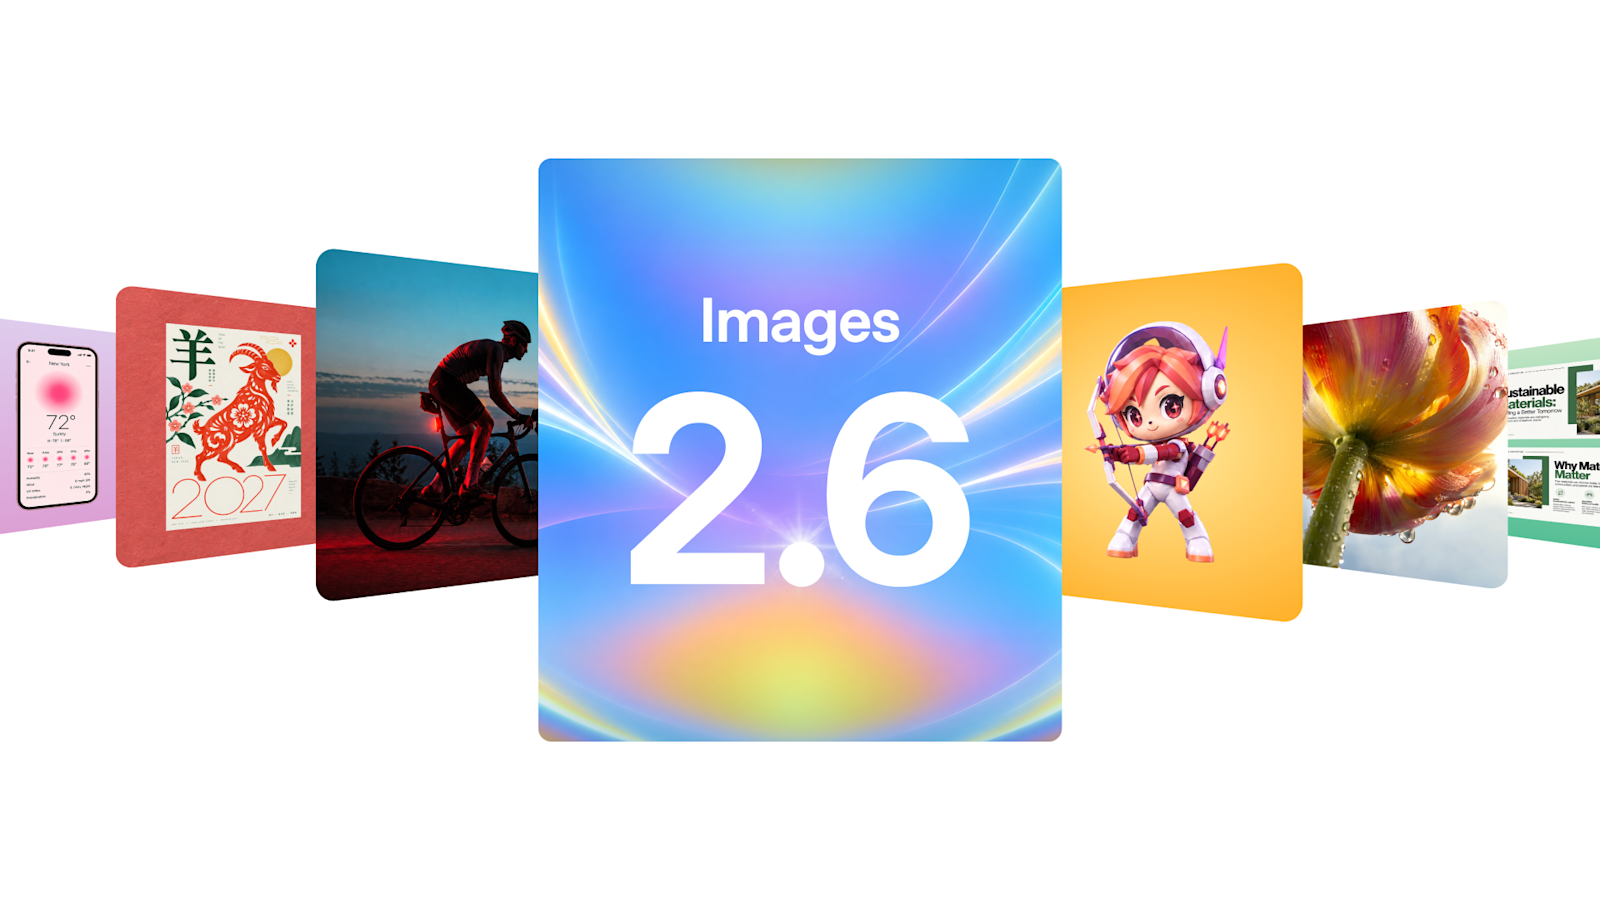
OpenAI 发布 Images 2.6:ChatGPT 支持生成 GIF 与保存参考图,API 上线 GPT-Image-2.6 Flare 与 Sunburst,出图快 50%

OpenAI 11 月 4 日发布 Images 2.6,即日起在 ChatGPT 与 Codex 全部订阅档位上线:可把提示词或图片做成可循环 GIF、保存参考图反复使用;API 新增 GPT-Image-2.6 Flare 与 Sunburst 两款模型,出图速度比此前快 50%,Flare 低画质最快约 6 秒出图,并新增图片标注编辑、SVG 导出和 complexity 参数。

OpenAI 发布 Images 2.6:ChatGPT 支持生成 GIF 与保存参考图,API 上线 GPT-Image-2.6 Flare 与 Sunburst,出图快 50%

核心要点速览

  • ChatGPT 与 Codex 全部订阅档位(网页、桌面、移动端)即日可用
  • 新增 GIF:可调速度、逐帧编辑,可从简单草图生成动画角色
  • API 新模型 GPT-Image-2.6 Flare(低画质最快约 6 秒)与 Sunburst(中高画质下多轮编辑一致性更好)
  • API 新增图片标注编辑、SVG 导出与控制规划力度的 complexity 参数
  • 官方称 ChatGPT、Codex 与 API 每周共生成约 40 亿张图
阅读全文
关联模型 / 智能体 / 厂商:
⚡ GPT-Image-2.6 Flare⚡ GPT-Image-2.6 Sunburst🤖 Codex🌐 OpenAI

RoboColosseum 开放真机机器人评测:100+ 台机器人、124 个站点,Claude Opus 5.5 和 GPT-6 Astra 零样本操控不输专用 VLA

Hugging Face、BitRobot、新加坡具身智能中心和 NUS 等 11 月 4 日推出 RoboColosseum,一个分布式真机评测框架,覆盖 SO-101、Franka、双臂 YAM 和 Unitree G1 四种机器人。首轮在 124 个站点做了 5,699 次盲测对比,测了 5 个 VLA 策略和 3 个前沿大模型:Claude Opus 5.5 和 GPT-6 Astra 的平均任务进度分别比 VLA 高 12.1 和 11.0 个百分点,Grok 4.7 落后 7.5 个点。所有 rollout 数据公开在 Hugging Face,并向学术界提供 10,000 小时免费评测。

RoboColosseum 开放真机机器人评测:100+ 台机器人、124 个站点,Claude Opus 5.5 和 GPT-6 Astra 零样本操控不输专用 VLA

核心要点速览

  • 两个赛道:Open Track 零样本盲测成对比较,Fine-tune Track 让 VLA 每个任务用同样的 100 条示范微调后在 20 个任务上比。
  • 被测 VLA 为 GR00T N1.7、π0.5、MolmoAct2、G0.5、LingBot-VLA v2;前沿模型为 GPT-6 Astra、Claude Opus 5.5、Grok 4.7。
  • 微调后 GR00T N1.7 在 SO-101 领先,π0.5 在 Franka 和双臂 YAM 领先;G1 人形上没有任何策略完成任务,平均进度 13.3%–23.2%。
  • 不同机器人上的排名一致性很弱(Kendall W = 0.24),零样本排名也很难预测微调后的排名。
阅读全文

Anthropic 更新 IPO 招股书:第三季度营收 170 亿美元,算力成本占营收 58%,已签约算力与基础设施支出约 8954 亿美元

Anthropic 11 月 2 日向 SEC 提交的 S-1 第一号修订稿首次披露了 2026 年第三季度财务数据:季度营收 169.56 亿美元,同比增长 1127%,环比第二季度的 115.55 亿美元增长约 47%;算力与基础设施支出 98.63 亿美元,占营收 58%(二季度为 48%),其中包含 50 亿美元价格更高的短期算力。三季度经营亏损 5.67 亿美元(二季度为经营盈利 9.74 亿美元),可转债等公允价值变动带来 219 亿美元账面损失,净亏损 232.9 亿美元。公司还披露已签约的采购与租赁承诺约 8954 亿美元,几乎全部用于算力和基础设施。

核心要点速览

  • 三季度营收 169.56 亿美元,同比 +1127%,环比二季度 115.55 亿美元约 +47%;前九个月营收 332 亿美元
  • 算力与基础设施支出 98.63 亿美元,占营收比例从二季度的 48% 回升到 58%,其中 50 亿美元来自比长约贵得多的短期算力
  • 三季度经营亏损 5.67 亿美元(二季度经营盈利 9.74 亿美元);净亏损 232.9 亿美元主要来自 219 亿美元可转债等公允价值变动
  • 已签约算力与基础设施承诺约 8954 亿美元:约 4475 亿美元预计在 2030 年底前发生,约 698 亿美元在未来 12 个月内到期
  • 公司明确表示不预期营收继续以相近速度增长;员工约 5300 人,年付 100 万美元以上客户超过 1900 家
阅读全文
关联模型 / 智能体 / 厂商:

商汤发布日日新 SenseNova 6.8 Flash 正式版:主打长期记忆与主动交互的办公智能体,可生成动态 PPT、动态海报和可编辑 Blender 3D 工程

商汤 11 月 2 日晚发布多模态智能体模型日日新 SenseNova 6.8 Flash 正式版,重点升级两块:一是长期记忆和主动交互,能跨任务、跨会话记住用户目标与约束,在信息变化时主动提醒;二是设计生成,覆盖 Web、SVG、Three.js、Blender、动态 PPT 和动态海报,并可接入 Figma。模型已上线 SenseNova Studio、商汤小浣熊和 SenseNova Token Plan;官方 X 账号称 Token Plan 可免费试用,每 5 小时 1500 次 API 请求。官方称其在智能体协作、数据分析和演示生成上超过部分国际前沿模型,但未在公告中列出具体分数。

商汤发布日日新 SenseNova 6.8 Flash 正式版:主打长期记忆与主动交互的办公智能体,可生成动态 PPT、动态海报和可编辑 Blender 3D 工程

核心要点速览

  • 正式版于 11 月 2 日晚发布,定位为多模态智能体模型,主攻办公协作和设计交付
  • 长期记忆加主动交互:跨会话记住目标、约束和偏好,相关信息变化时主动提出调整建议(官方演示基于小浣熊内部研发版)
  • 设计能力覆盖 Web、SVG、Three.js、Blender、动态 PPT、动态海报,输出可继续编辑的 PPTX 和 Blender 工程,并可接入 Figma
  • 渠道:SenseNova Studio、商汤小浣熊、SenseNova Token Plan;官方 X 称 Token Plan 每 5 小时 1500 次免费 API 请求
  • 官方只称在智能体协作、数据分析、演示生成上超过部分国际前沿模型,公告未给具体分数,暂无独立评测
阅读全文
关联模型 / 智能体 / 厂商:
⚡ SenseNova 6.8 Flash⚡ SenseNova Loop-9B-Preview🤖 Raccoon🌐 SenseTime

LiberAI 发布机器人世界动作模型 Liber-0:用 220 万小时人类经验预训练,60 项零样本操作任务总成功率 36%

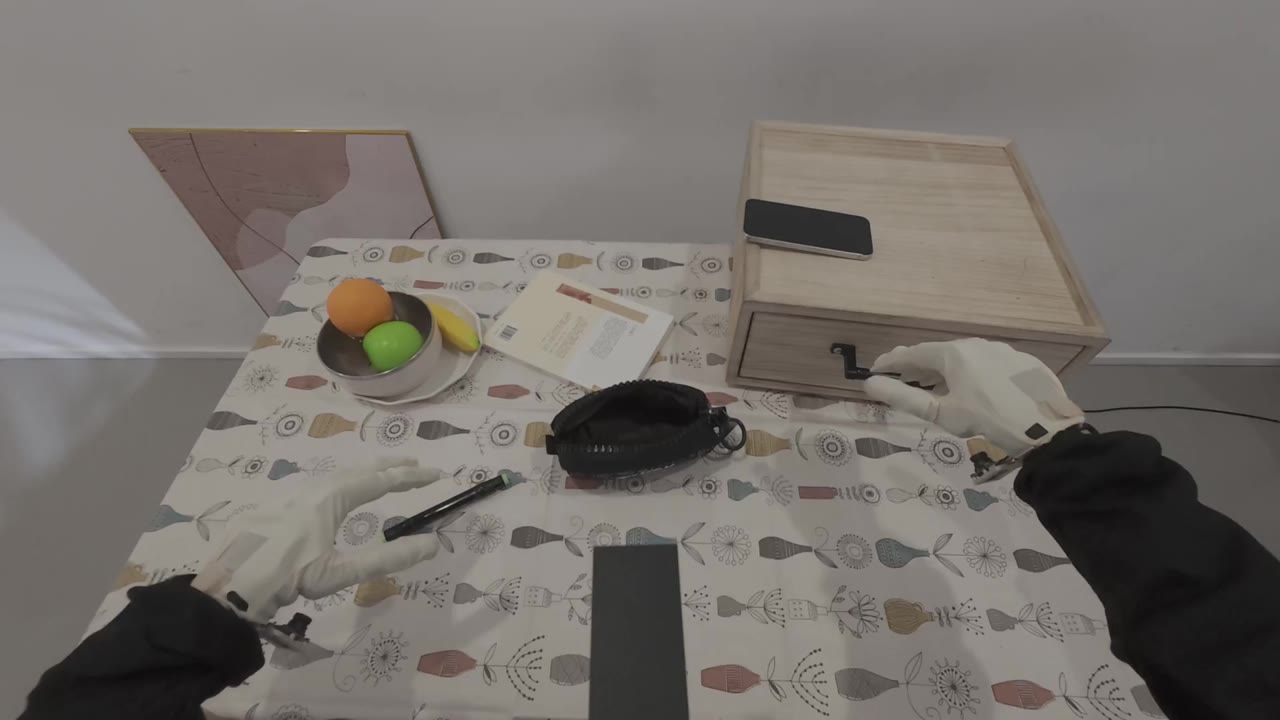
机器人公司 LiberAI 在官方 X 账号和技术博客发布 Liber-0,一个同时预测未来画面和动作的世界动作模型(World Action Model),用超过 220 万小时人类经验预训练,并用自研 LiberSense 手套采集的精确手部动作数据做“动作锚点”。在 GPT-6 随机提出的 60 项任务、600 次试验中,Liber-0 在没有针对这些任务采集机器人示范的情况下总成功率 36.0%,其中复杂多步任务仅 10.5%。官方未公布开源权重或 API。

LiberAI 发布机器人世界动作模型 Liber-0:用 220 万小时人类经验预训练,60 项零样本操作任务总成功率 36%

核心要点速览

  • 零样本成绩:抓取放置 63.5%、短程非抓取操作 34.0%、复杂多步任务 10.5%,总计 36.0%(60 项任务 × 10 次)
  • 对照:把 GPT-6 Astra 单独当机器人策略,同一套任务三类成功率只有 8.3%、5.0%、1.7%,平均每步推理 87.3 秒
  • 手套数据 10k 小时的效果超过 200 倍时长(2,000k 小时)的网络人类视频,说明“有精确动作标注”比单纯堆视频更关键
  • 手套数据配合 25% 机器人示范,进度分 75.6,超过用全部机器人示范的 72.8,即少用 75% 机器人数据
  • 所有数字均为 LiberAI 自报的内部评测;官方未公布开源权重、API 或商用时间
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

腾讯混元发布 Hy4 正式版:首次加入视觉理解与电脑操作,已上线腾讯云和 OpenRouter,权重“近期开源”

腾讯混元 11 月 4 日在官网发布 Hy4 正式版。相比 8 月的 Hy4 preview,官方称扩大了预训练和后训练规模,首次加入视觉理解,首次支持电脑操作(命令行+图形界面),并专项训练了 Blender、CAD、Unreal/Unity/Godot 等场景。Hy4 已上线腾讯云和 OpenRouter(tencent/hy4,1M 上下文),API 价格与 preview 相同;模型权重和系统卡片将在近期开源发布,更便宜的 Hy4 flash 也在路上。

核心要点速览

  • 官方博客:Introducing Hy4,发布日 2026-11-04;透明度中心同步列出 V1.0 Hy4
  • 两个“首次”:视觉理解(细粒度看图、复杂图表、数学视觉推理)和电脑操作(CLI+GUI 结合,针对 Blender、CAD 和跨应用长程任务专项训练)
  • 官方自测:579 项真实金融任务(213 位金融从业者评估)Hy4 得 3.04,开放权重模型中第一(DeepSeek-V4.1-Flash-1017 2.97、Kimi K3.1 Pro 2.68、GLM-5.3 2.68);GameDev +19.1%、GameLogic +9.8%;内部搜索评测幻觉率 15.76%→5.45%
  • API 价格与 preview 相同:每百万 token 缓存输入 $0.042、输入 $0.834、输出 $2.501;OpenRouter 页面目前标注 5 折($0.417/$1.251),1,048,576 上下文、最多 65,536 输出
  • 权重尚未公开:官方称将开源权重并发布完整系统卡片,已与 vLLM、SGLang 合作;Hy4 flash 近期发布
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Hy4⚡ Hy4 preview⚡ Hy4 flash🤖 CodeBuddy🤖 WorkBuddy🌐 Tencent

生成式媒体推理平台 fal 宣布 Series E 和 F 合计融资 16.5 亿美元:Sequoia、Bessemer 领投,NVIDIA 继续跟投

托管图像、视频、音频模型推理的 fal 于 11 月 3 日在官方 X 账号和博客宣布,Series E 与 Series F 两轮合计融资 16.5 亿美元:Series E 由 Sequoia Capital 领投(今年早些时候完成),Series F 由 Bessemer Venture Partners 领投,NVIDIA 继续投资。fal 官方未公布估值和各轮金额;据 Bloomberg 报道,Series F 为 13 亿美元、估值 160 亿美元,较 4 月的 80 亿美元翻倍。官方称资金将用于扩充推理算力和团队,支持 2027 年的研究与平台建设。

生成式媒体推理平台 fal 宣布 Series E 和 F 合计融资 16.5 亿美元:Sequoia、Bessemer 领投,NVIDIA 继续跟投

核心要点速览

  • 官方确认:Series E + F 合计 16.5 亿美元,Sequoia 领投 E 轮,Bessemer 领投 F 轮,NVIDIA 继续投资(fal 博客)
  • 官方未公布估值;据 Bloomberg 报道 Series F 为 13 亿美元、估值 160 亿美元,Series E 为 3.5 亿美元、估值 80 亿美元
  • 据 Bloomberg,CEO Burkay Gur 称夏天需求暴涨到不得不对客户限流,这是大额融资的直接原因
  • 资金用于推理算力和团队扩张,以及 2027 年的新研究;fal 平台托管 Seedance、Kling、Veo、FLUX 等大量第三方媒体模型
阅读全文

Artificial Analysis 把六大职业能力指数升级到 v2.0:加重“不幻觉”和 Agent 工具调用权重,Claude Opus 5.5 六项全部第一

独立评测机构 Artificial Analysis 11 月 4 日在 X 上宣布,把金融会计、战略运营、法律、医疗、工程、经济六个 Capability Indexes 升级到 v2.0,与 Intelligence Index v5.0 的评测对齐,并更重视 Non-Hallucination(不编造)和 Agentic Tool Use。各指数统一把 HLE 换成 HLE-Diamond、AA-Omniscience 升到 v1.1,并移除 GDPval-AA;工程指数新增 Science 能力项。官方结果:Claude Opus 5.5 (max) 六项全部领先,GPT-6 Astra (max) 在金融会计、法律、工程排第二;开放权重阵营中 Kimi K3.1 Pro(权重尚未发布)六项都领先,排在第 5 到第 8 名。

Artificial Analysis 把六大职业能力指数升级到 v2.0:加重“不幻觉”和 Agent 工具调用权重,Claude Opus 5.5 六项全部第一

核心要点速览

  • 六个指数把 O*NET 职业任务映射到对应 benchmark,按能力在该职业中出现的频率加权(方法论页)
  • 通用改动:HLE 升为 HLE-Diamond,AA-Omniscience 升为 v1.1,各指数的 Agentic Knowledge Work 都去掉 GDPval-AA(改由 AA-Briefcase v1.1 承担)
  • 金融会计与法律指数中 Non-Hallucination 权重升到 15%;战略运营指数 Agentic Tool Use(AutomationBench-AA)升到 35%,为单项最高
  • 工程指数新增 Science(20%,CritPt v2 Hard Subset + Terminal-Bench-Science 0.1),Agentic Coding 加入 FrontierCode 2.0;经济指数用 GDP.pdf 取代 AA-LCR
  • 官方结果:Claude Opus 5.5 (max) 六项第一;开放权重中 Kimi K3.1 Pro 六项领先,MiniMax-M3.1-Flash 在战略运营(#10)、DeepSeek V4.1 Flash 1017 (max) 在医疗(#12)领先
阅读全文

OpenAI 公布 ChatGPT 与 Codex 用于硬件工程的进展:GPT-6 Astra 一周内设计出 Codex 设备,携手 Mazda 做空气动力学研究

11 月 3 日,OpenAI 发布《Accelerating engineering for the physical world》,介绍其模型在机械设计、电子设计和仿真上的进展。两名员工用 GPT-6 Astra 在不到一周内设计出一台用来和 Codex 对话的设备(外壳、PCB、固件和软件),合同制造商不到一个月做出小批量原型,但量产前仍需多轮人工评审。OpenAI 硬件团队的模型 token 用量自 2 月以来增长 23 倍;在 BenchCAD 2.0 上,一个更新的内部模型平均得分 0.875,GPT-6 Astra 最高推理档为 0.594(官方口径)。OpenAI 还扩大与 Chip Ganassi Racing 的合作,并宣布与 Mazda 开展新的研究合作。

OpenAI 公布 ChatGPT 与 Codex 用于硬件工程的进展:GPT-6 Astra 一周内设计出 Codex 设备,携手 Mazda 做空气动力学研究

核心要点速览

  • GPT-6 Astra 在「无人工直接编辑」的测试里完成外观、外壳结构、元器件选型与 PCB 布局、UI 和固件;两名员工业余时间不到一周完成设计,原型不到一个月做出,见 OpenAI 博客。
  • 官方承认短板:Astra 没有稳定考虑制造商的产能限制、公差和装配细节,量产前仍需多轮评审迭代。
  • OpenAI 硬件与基础设施团队用 Codex/ChatGPT 做 CAD 建模、2D 工程图、仿真与 FEA、设计评审,token 用量自 2 月起增长 23 倍(官方口径)。
  • BenchCAD 2.0(重建 3D 零件与装配体、识别电路板连接):更新的内部模型 0.875,GPT-6 Astra 最高推理档 0.594(官方口径,内部模型未命名、未发布)。
  • 合作方:Chip Ganassi Racing 测试把 3D 扫描转成可编辑 CAD 和 2D 图纸;Mazda 与 OpenAI 研究团队用气流和结构仿真探索车型设计,结果「未来几个月」公布。
阅读全文

Sarvam 发布开源决策模型 Prism:基于 Sarvam 105B,单次前向只输出选项概率,中位响应 44 毫秒,Apache 2.0

印度 AI 公司 Sarvam 于 11 月 3 日发布 Sarvam Prism,一款面向企业工作流的「System One」决策模型:给定上下文和若干带固定选项的问题,它在一次前向计算里直接返回每个选项的概率,不生成文本。官方称在其测试的 25 个决策模型中,Prism 三项指数平均 71.8 分、在单张 B200 上中位响应 44 毫秒,是 100 毫秒内得分最高的模型;印度语言基准 82.5。权重以 Apache 2.0 发布在 Hugging Face,同时提供托管 API。以上分数均为 Sarvam 自测。

Sarvam 发布开源决策模型 Prism:基于 Sarvam 105B,单次前向只输出选项概率,中位响应 44 毫秒,Apache 2.0

核心要点速览

  • 基于 Sarvam 105B(105B-10B MoE 基座)训练,只输出选项概率,答案一定落在给定选项内。
  • 官方口径三项指数:Jev Decision Index 67.0、自建的 Artificial Analysis 决策指数复刻版 65.9、内部印度语言基准 82.5,平均 71.8;Perplexity Decider v1.2 平均 68.0 但响应约 117 毫秒。
  • 校准:英文 90% 以上置信度回答,预期错误 3.3%、实际 2.2%;印度语言预期 5.4%、实际 4.4%,对比模型低估错误 1.5 到 4.8 倍。
  • 先把选项排成固定顺序再打分,2,000 道题四次打乱选项顺序后 0 道答案改变。
  • 评测 700 条 Agent 运行记录,整体判断准确率 78.5%,Claude Haiku 5.5 为 70.7%。
  • 本地部署需一张支持 FP8、约 120GB 空闲显存的 GPU(如 B200/H200),权重约 106GB。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Sarvam Prism⚡ Sarvam 105B⚡ Perplexity Decider v1.2⚡ Jev 1.14⚡ Microsoft-Decision-1⚡ Claude Haiku 5.5🌐 Sarvam