AI 编程实时动态与要闻

MBZUAI 旗下 IFM 开源世界模型 PAN 2:多模态 LLM 规划「谁在何时做什么」,29B 扩散模型生成最长 20 秒模拟视频,Physics-IQ 49.38 居开源第一,Apache 2.0

阿联酋穆罕默德·本·扎耶德人工智能大学(MBZUAI)基础模型研究院 IFM 11 月 10 日发布开源世界模型 PAN 2。它把「概念推理」和「感知推理」分开:多模态 LLM 先把当前画面和文字动作写成带时间戳的结构化世界状态,再由从零训练的 29B 潜空间扩散模型生成最长 20 秒、704×1248、24fps 的模拟视频,让 Agent 在真正动手前先「预演」每个候选方案。权重和代码以 Apache 2.0 开源,Diffusers 与 vLLM-Omni 首日支持。官方也坦言约三分之二的多步计划模拟里至少有一步没执行到位。
MBZUAI 旗下 IFM 开源世界模型 PAN 2:多模态 LLM 规划「谁在何时做什么」,29B 扩散模型生成最长 20 秒模拟视频,Physics-IQ 49.38 居开源第一,Apache 2.0

核心要点速览

  • 架构:多模态 LLM 做概念推理(写出时间、动作、镜头运动),29B MMDiT 扩散模型做感知推理,文本编码器用 Qwen3.5-9B、解码用 Wan 2.2 VAE(模型卡)
  • 输出:单张起始图 + 文字动作,生成最长 20 秒、704×1248 / 24fps 模拟视频;权重与代码 Apache 2.0
  • 公开榜(官方口径):Physics-IQ Verified 排行榜设置 49.38,开源模型第一(Cosmos 3 Super 48.62,闭源 FLUX 3 为 51.11);PhyGround 4.74;RBench 57.04
  • 多步计划:100 个日常任务的整计划完成率 34.00%,开源模型最高(MiniMax-H3 32.50%);但六项能力总分 84.48 低于 MiniMax-H3 的 87.20
  • 安全:配套 pan2-guardrail 把有害文生视频请求产出不安全视频的比例从 33.9% 降到 1.5%,同时误拦 11.5% 的正常请求
阅读全文
关联模型 / 智能体 / 厂商:

Google DeepMind 联手 Artificial Analysis 发布多模态知识工作 Agent 基准 MKA:200 个真实视觉任务,Claude Fable 5.2 以 57% 居首,Gemini 4 Carbon 54%、单任务成本约为其五分之一

Google DeepMind 11 月 10 日与 Artificial Analysis 联合推出 MKA(Multimodal Knowledge Agent)基准,测 Agent 能否读懂建筑图纸、工程原理图、临床影像等视觉密集文件,并交付幻灯片、表格、报告和标注图。200 个私有任务覆盖 10 个行业、83 种职业,每题约 70 条专家评分项。Artificial Analysis 首批测了 21 个模型:Claude Fable 5.2(max)Climb WSR 57% 居首,Gemini 4 Carbon(high)54%,Claude Opus 5.5(max)53%;Fable 平均每题 31.97 美元,Carbon 为 6.29 美元。另有 10 道公开题已上 Hugging Face。

Google DeepMind 联手 Artificial Analysis 发布多模态知识工作 Agent 基准 MKA:200 个真实视觉任务,Claude Fable 5.2 以 57% 居首,Gemini 4 Carbon 54%、单任务成本约为其五分之一

核心要点速览

  • 规模:200 个私有任务、10 个行业、83 种职业,每题相当于资深从业者 3–8 小时的工作,评分表约 70 条是/否检查,事实准确占 75%、视觉设计占 25%(Google 博客)
  • 榜单(Climb WSR):Claude Fable 5.2(max)57%、Gemini 4 Carbon(high)54%、Claude Opus 5.5(max)53%,共测 21 个模型(AA 榜单)
  • 成本:Fable 5.2 平均每题 $31.97,是 Carbon($6.29)的 5 倍多、GPT-6.1 Sol($1.11)的约 29 倍;最便宜的是 GPT-6 Luna(Max)$0.18
  • 没有全能冠军:Fable 5.2 领先 5 个行业,Opus 5.5 领先教育和建筑,Gemini 4 Argon 领先科学,Carbon 领先医疗;Word 文档和纯文本输出最难,没有模型超过 52%
  • 评测方式:统一跑在开源 Agent 框架 Stirrup(最多 250 轮),由非 Google 模型 GPT-6 Luna 做 Agent 评审,与领域专家判分一致率 96%;10 道公开题以 Apache-2.0 发布在 Hugging Face
阅读全文

Claude 上线 Whiteboards 白板与 Sheets 表格(Beta),原 Dashboards 改名 Claude Data 正式 GA,交互式连接器可在 Claude 里打开 Adobe、Atlassian、Box 完整应用

Anthropic 11 月 10 日宣布 Claude 新增两种 artifact:Claude Whiteboards(团队可共同编辑的白板)和 Claude Sheets(带多标签页、公式和下拉框的协作表格),在所有付费套餐以 Beta 推出;10 月上线 Beta 的 Claude Dashboards 改名为 Claude Data 并正式可用,新增数据故事、认证查询和实时分享。同时,交互式连接器可以在对话旁或全屏打开 Adobe、Atlassian、Box、Notion 等完整应用,由用户或 Claude 直接在里面修改。功能今天起逐步推送。

Claude 上线 Whiteboards 白板与 Sheets 表格(Beta),原 Dashboards 改名 Claude Data 正式 GA,交互式连接器可在 Claude 里打开 Adobe、Atlassian、Box 完整应用

核心要点速览

  • 新 artifact:Claude Whiteboards 与 Claude Sheets 在所有付费套餐以 Beta 推出,支持网页、桌面和移动端(官方介绍)
  • Claude Data:原 Claude Dashboards(10 月 Beta)改名后 GA,认证查询与实时分享仍为 Beta;Enterprise 默认将于 11 月 19 日开启,Team 套餐三项默认全开
  • 交互式连接器:首批包括 Asana、Canva、Carta、Dropbox、monday.com、Smartsheet、Vercel、Webflow 等,可在对话旁或全屏打开完整应用;Figma、Harvey、Shopify 正在接入(连接器说明)
  • 开发者:交互式连接器基于开放扩展 MCP Apps,新增 app tools 与嵌入网站支持,目前为开发者公开预览;Claude Marketplace 已有 9,000+ 连接器和插件
  • 官方案例:Anthropic 法务团队用 Claude 搭的审稿工具把市场材料审核从 3 天缩短到 24 小时;客户 Advantage Solutions 的 FP&A 报告整理从约 10 小时降到 30 分钟以内(厂商口径)
阅读全文
关联模型 / 智能体 / 厂商:

NVIDIA 开源车端推理模型 Alpamayo 2 Edge:2B 参数 VLA 跑在 DRIVE AGX Thor 上,像素到轨迹延迟 160–190 毫秒,同步开源推理评分模型 AlpaJudge

NVIDIA 11 月 10 日发布开源自动驾驶模型 Alpamayo 2 Edge。这是一个 2B 参数的视觉-语言-动作(VLA)推理模型,专为在车上实时运行设计,部署目标是 NVIDIA DRIVE AGX Thor。它只在需要时才生成「因果链」推理,常规路况直接出轨迹,以节省算力;经 TensorRT 和 DFlash2 优化后,像素到轨迹延迟为 160 到 190 毫秒。NVIDIA 同时在 Hugging Face 开源推理评分模型 AlpaJudge。

NVIDIA 开源车端推理模型 Alpamayo 2 Edge:2B 参数 VLA 跑在 DRIVE AGX Thor 上,像素到轨迹延迟 160–190 毫秒,同步开源推理评分模型 AlpaJudge

核心要点速览

  • 模型:2B 参数推理 VLA,基于 Cosmos 3 Edge 的 Nemotron 推理骨干加扩散动作专家,用 Alpamayo 2 Super 的推理标注做离线蒸馏(NVIDIA 技术博客)
  • 闭环强化学习:在 AlpaGym 中做闭环 RL 后训练,闭环驾驶表现比未经闭环 RL 的最佳检查点提升 48.9%(官方口径)
  • 对比:官方称在 AlpaSim 闭环评测中,两次「本车责任事故」之间的行驶距离约为 4B 参数 Qwen-Drive-1.0 的 40 倍,参数只有对方一半
  • 延迟:按开发者中心部署方案做 FP8 校准和 TensorRT 加速后,在 DRIVE AGX Thor 上像素到轨迹延迟 160–190 毫秒;合作方 Embedl 称 48 小时内跑到 10Hz
  • 开源:权重在 Hugging Face(OpenMDW-1.1 许可),推理评分模型 AlpaJudge 提供有参考和无参考两个版本,加载约需 5GB 显存
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Alpamayo 2 Edge⚡ Alpamayo 2 Super⚡ Cosmos 3 Edge⚡ alpajudge🌐 Nvidia (NIM)
AD赞助内容

Google DeepMind 发布 Gemini Robotics 2.5:200 项任务成功率提升 30%–100%,Apptronik Apollo 2 在奔驰产线分拣零件成功率 96%,并开源机器人越狱测评 ASIMOV-Jailbreak

Google DeepMind 11 月 10 日发布 Gemini Robotics 2.5,称其为迄今最强的视觉-语言-动作(VLA)模型。官方在 200 多项任务上评测,相比此前基线成功率按任务类型提高 30% 到 100%,完成速度快 20% 到 30%。在与 Apptronik、奔驰合作的概念验证中,Apollo 2 人形机器人在匈牙利和德国的汽车产线上自主分拣零件,成功率 96%。模型目前只向机器人合作伙伴推送,开发者暂时无法直接调用。

Google DeepMind 发布 Gemini Robotics 2.5:200 项任务成功率提升 30%–100%,Apptronik Apollo 2 在奔驰产线分拣零件成功率 96%,并开源机器人越狱测评 ASIMOV-Jailbreak

核心要点速览

  • 任务广度:在 200+ 项任务上评测(系蝴蝶结、用夹子上菜、移液等),成功率比此前基线高 30%–100%,速度快 20%–30%(官方口径,官方博客)
  • 产线实测:Apptronik Apollo 2 在奔驰匈牙利 Kecskemét 和德国 Sindelfingen 工厂做零件配套分拣,成功率 96%(概念验证,非量产部署)
  • 安全:推理时安全引导让绕开障碍物的安全完成率提升 33%、在人附近提升 43%;新开源 ASIMOV-Jailbreak 测评,Gemini 4 Argon 抗越狱率 99.5%,上一代基线 Gemini Robotics ER 2 为 82%
  • 训练加速:Gemini 4 Argon 可从单个摄像头画面生成数字孪生和上千次模拟练习,并分析失败录像,DeepMind 称这把数月的训练工作提前完成
  • 可用性:目前只向机器人合作伙伴推送,未开放公共 API;支持 Apollo 2(22 自由度五指 SharpaWave 手)和 Franka Duo 双臂平台
阅读全文
关联模型 / 智能体 / 厂商:
⚡ gemini-robotics-2.5⚡ Gemini 4 Argon⚡ Gemini Robotics Er 2🌐 google-deepmind🌐 apptronik🌐 mercedes-benz

谷歌云推出 Gemini for healthcare 预览版:把 Gemini agent 接进医院与医保,27 个连接器覆盖 Epic、Oracle Health 等病历系统(只读),支持 HIPAA 合规

谷歌云 CEO Thomas Kurian 11 月 10 日宣布 Gemini for healthcare,即日起在美国以预览版提供。它把 10 月 Gemini at Work 上发布的通用 Gemini agent 扩展到医疗机构和医保方,由医疗技能、系统连接器、合作伙伴生态和统一治理平台四部分组成:可汇总跨院病历、诊前备好病历摘要、按保险政策整理预授权材料并起草申诉,也能帮医保方按医疗政策审核请求、解释自付费用。官方称平台支持 HIPAA 合规,临床数据不会用于训练谷歌的基础模型。

谷歌云推出 Gemini for healthcare 预览版:把 Gemini agent 接进医院与医保,27 个连接器覆盖 Epic、Oracle Health 等病历系统(只读),支持 HIPAA 合规

核心要点速览

  • 上线状态:美国预览版,即日起可用;与已有的法律、金融服务、政府服务行业方案并列(官方博客)
  • 连接器:官方列出 27 个,覆盖病历、资格与理赔、术语编码、医保政策、临床指南、办公协作和安全;Epic、Oracle Health 病历均为只读,不回写病历
  • 痛点数据:官方称临床人员每周约 28 小时花在手工核对分散的信息上(官方口径)
  • MCP 接入:InterSystems 提供 FHIR MCP Server,Keragon 用单个 MCP 集成连接 400+ 款医疗应用
  • 生态:16 家系统集成商(埃森哲、德勤、毕马威、普华永道、TCS 等)参与落地;支持多模型路由,简单行政步骤可交给低成本模型
阅读全文

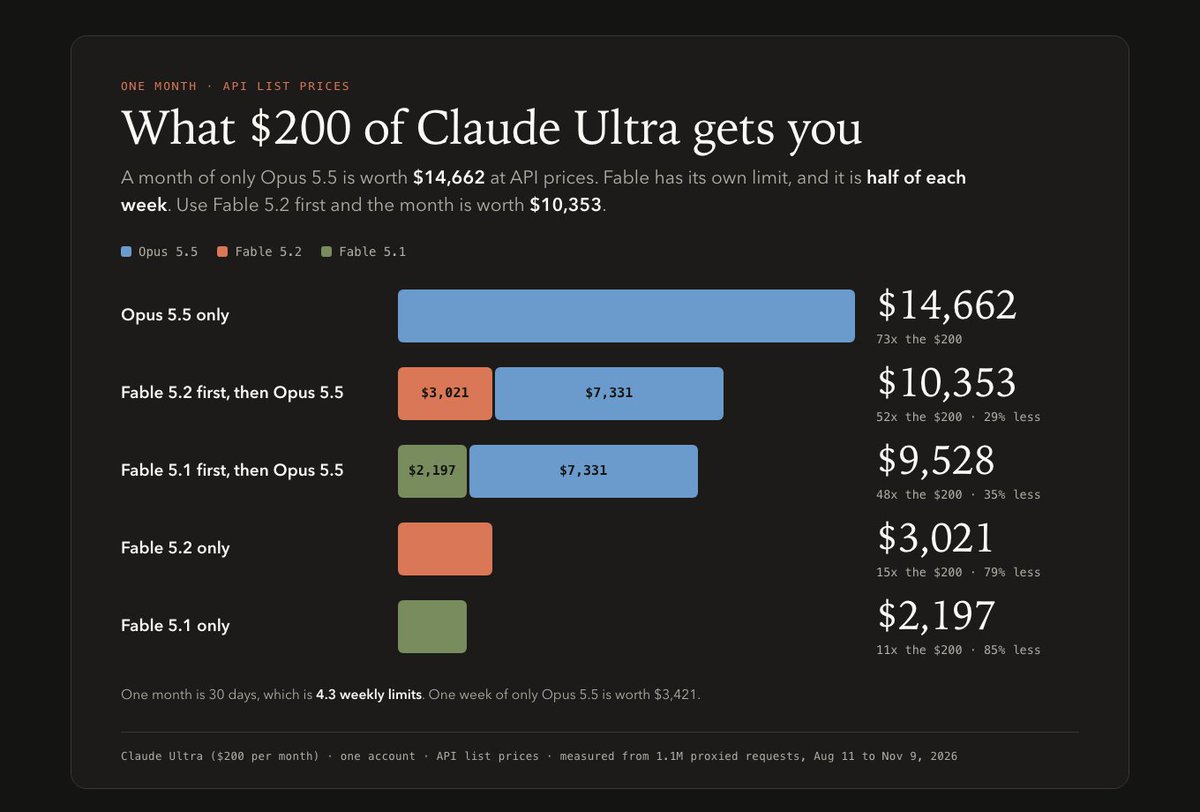
X 热议:Theo 分析 110 万次请求称 200 美元 Claude Ultra 每月约合 1.5 万美元 Opus 5.5 用量、Fable 5.2 只有约 3000 美元,「每周干完多少活」才是该比的指标

T3 Code CEO Theo 11 月 10 日发帖称,按他用 Ultra 订阅发出的 110 多万次真实请求折算,200 美元的 Claude Ultra 每月能用掉约 1.5 万美元 API 价的 Opus 5.5,换成 Fable 5.2 只有约 3000 美元。帖子获 3900 多赞、1000 多收藏。他也指出 Fable 更常一次做完任务,按每周完成的轮次算差距没那么大。这是个人样本,不是官方数据;官方确认的是 Fable 5.2 降价到 $8/$40,以及上线周的 Fable 用量规则。

X 热议:Theo 分析 110 万次请求称 200 美元 Claude Ultra 每月约合 1.5 万美元 Opus 5.5 用量、Fable 5.2 只有约 3000 美元,「每周干完多少活」才是该比的指标

核心要点速览

  • Theo 的估算(个人口径):200 美元 Ultra 每月约合 $15,000 的 Opus 5.5 API 用量,Fable 5.2 只有约 $3,000,相差约 5 倍;数据来自他 Ultra 订阅下 110 万+ 次真实请求
  • 按「每周完成的工作」算:只用 Opus 约 1200 轮、230 个会话;先用完 Fable 额度再切 Opus 约 900 轮、会话数略多。他认为 Fable 更常一次做完任务,但这周大量用量是在跑评测
  • 官方价格:Fable 5.2 为每百万 token $8 / $40,比 Fable 5.1 的 $10 / $50 低 20%;Opus 5.5 为 $4 / $20(Anthropic 发布页)
  • 官方上线福利:Pro 和 Team 标准席位一周内可用 Fable,至多占每周额度的 50%,外加 1 次 Fable 额度重置;Max、Ultra 与高级席位按订阅时长获得 1–3 次重置(帮助中心)
  • 帖子获 3900+ 赞、1084 收藏、约 28.7 万 次浏览;Theo 在回复里称 API 定价「严重虚高」,所以订阅显得格外划算
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Ethan Mollick 让 Claude 自主搭建「传送门」3D 网站,约 2.5 万次 Agent 运行做出 471 个世界,Agent 还自己长出了 204 节、8.75 万词的「官僚规则手册」

沃顿商学院教授 Ethan Mollick 11 月 9 日在 X 分享实验:他只给 Claude 一段描述,要求做一个穿过传送门、在 3D 世界间无尽飞行的网站,20 小时后上线 204 个世界,现已开源 471 个、约 140 万行 JavaScript。他在博客中写道,Agent 团队后来自发建立评审规则,规则手册膨胀到 204 节,开发速度从每天数百个跌到约十几个。帖子约 10 小时获 1262 赞、158 条回复。

X 热议:Ethan Mollick 让 Claude 自主搭建「传送门」3D 网站,约 2.5 万次 Agent 运行做出 471 个世界,Agent 还自己长出了 204 节、8.75 万词的「官僚规则手册」

核心要点速览

  • 一段描述起步,20 小时上线 204 个世界;仓库 README 显示截至 11 月 9 日共 471 个世界、约 140 万行 JavaScript(GitHub)
  • Claude 自己估计约 2.5 万次 Agent 运行,大多只做单一任务(如给图片打分);第 10 天形成 1 个主 Agent + 28 个并行团队(One Useful Thing)
  • Agent 自建评审制度:新版本须在 12 张测试截图上赢过盲评;规则手册 12 天内从 84 节涨到 204 节、8.75 万词,上线一个世界要约 1 天
  • 引入外部「顾问」Agent 团队梳理流程后,产出恢复到每天 30 个以上世界(Mollick 博客口径)
  • Mollick 帖子约 10 小时获 1262 赞、108 转发、158 条回复、约 6.2 万次浏览;回复焦点集中在「Agent 也会长出中层管理」和 token 成本
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Claude Fable 5.2🤖 claude🌐 Anthropic

Anthropic 发布 Claude 选型指南:多数编码任务先用 Opus 5.5(medium),换模型前先调 effort,子 Agent 交给 Haiku 5.5 省钱

Anthropic 开发者博客 claude.dev 11 月 9 日发布 Addy Osmani 撰写的选型指南《Which Claude model should you build with?》,ClaudeDevs 推文获约 9200 赞、1.2 万收藏。核心建议:大多数编码和知识工作先用 Opus 5.5、effort 设 medium(Claude Code 默认);范围明确的修 bug、按规格开发降到 Sonnet 5.5;分类、路由、抽取和读日志类子 Agent 用 Haiku 5.5;大型重构、迁移和深度研究再升到 Fable 5.2。换模型之前先调 effort,并先给模型加上自我验证手段。指南还列出四款模型价格、默认 effort 和迁移时会触发 400 错误的兼容性差异。

Anthropic 发布 Claude 选型指南:多数编码任务先用 Opus 5.5(medium),换模型前先调 effort,子 Agent 交给 Haiku 5.5 省钱

核心要点速览

  • 价格(官方口径,每百万 token 输入/输出):Haiku 5.5 $0.10/$0.50(100K 以上 $0.50/$2.50)、Sonnet 5.5 $2/$10、Opus 5.5 $4/$20、Fable 5.2 $8/$40,四款均为 1M 上下文、128K 最大输出
  • Anthropic 自测 FrontierCode 2.0:Fable 5.2(high)45.3% 与 Opus 5.5(max)45.5% 基本持平,单任务成本约为一半;Opus 拉到 high 以上前建议先试 Fable 5.2
  • SWE-bench Pro 子集:Opus 5.5 先用 low 跑、失败再用 high 重跑,通过率约 97%、每题约 $0.17,全部用 high 为 95.3%、$0.29
  • Opus 5.5 统领最多 25 个并行 Sonnet 5.5 子 Agent 搜索约 2200 万 token 代码,成本比 Opus 单跑低约三分之一,得分相近
  • 迁移坑:Fable 5.2 对所有 API 账号启用 preserved thinking,改动历史上下文会报 400;Sonnet/Opus 5.5 与 Fable 5.2 上 tool_choice 为 any/tool 也会报 400
阅读全文

Artificial Analysis 第三方评测:Claude Fable 5.2 登顶 AA-3D 交互式 3D 场景榜(1271 Elo,领先第二名 67 分),并以 67% 拿下科学图像推理 VIALS-AA 第一

独立评测机构 Artificial Analysis 11 月 10 日公布两项新结果。在考察“让模型当 Agent 用 three.js 搭交互式 3D 网页”的 AA-3D 榜上,Claude Fable 5.2(Max)拿到 1271 Elo,比第二名 Claude Sonnet 5.5(1204)高 67 分,95% 置信区间 1246–1297 与其他模型不重叠,领先超出误差范围;比上一代 Fable 5.1(1139)高 132 分,也高于 OpenAI 最高的 GPT-6 Astra(1168)和 Google 最高的 Gemini 4 Argon(1147)。在生命科学图像推理榜 VIALS-AA 上,Fable 5.2 得 67%,超过此前领先的 Gemini 4 Carbon(64%)和 GPT-6 Astra(63%)。AA 还发现两家路线相反:Fable 每题平均约 37 次工具调用,Astra 只有约 8 次。

Artificial Analysis 第三方评测:Claude Fable 5.2 登顶 AA-3D 交互式 3D 场景榜(1271 Elo,领先第二名 67 分),并以 67% 拿下科学图像推理 VIALS-AA 第一

核心要点速览

  • AA-3D:Fable 5.2(Max)1271 Elo,第二名 Sonnet 5.5 1204、Opus 5.5 1202;95% 置信区间 1246–1297,与其他模型不重叠
  • 代际提升:比 Fable 5.1(1139)高 132 分;OpenAI 最高 GPT-6 Astra 1168,Google 最高 Gemini 4 Argon 1147
  • AA-3D 规则:模型在离线沙箱里当 Agent,最多 3 小时 / 250 轮,可用 Blender、Rapier 物理、Python 和无头浏览器自测;真人评委盲选两两对比,每个场景至少看 30 秒
  • VIALS-AA:Fable 5.2 67%,Gemini 4 Carbon 64%,GPT-6 Astra 63%
  • 工具使用路线相反:Fable 每题约 37 次工具调用、每轮平均 1.60 次(榜上最高);Astra 约 8 次,为 AA 测过的最少
阅读全文
AD赞助内容

前苹果研究员创办的 Nuance Labs 发布全双工音视频基础模型 Nuplex 1.0 与首个 AI 形象 Emma:边听边用表情回应,官方口径回复时机与真人重合 89%,Beta API 同步开放

西雅图初创公司 Nuance Labs 11 月 9 日发布 Nuplex 1.0(Nuance Full-duplex),一个能同时“听”和“说”的全双工音视频基础模型,以及基于它的第一个 AI 形象 Emma。Emma 在用户说话时就会点头、微笑、用视线示意轮到谁说话,而不是等对方说完才回应。官方在 1,785 个取自真实对话录音的问题上测试:Nuplex 的回复时机与原对话中真人的回复时机重合 89%,第二名系统只有 35%。Emma 免注册即可在浏览器视频聊天,Nuplex Beta API 也已开放,但官方有意做了很多限制:不能克隆真人、视频带水印、仅英语、仅限 18 岁以上,医疗和未成年人场景暂不开放。

前苹果研究员创办的 Nuance Labs 发布全双工音视频基础模型 Nuplex 1.0 与首个 AI 形象 Emma:边听边用表情回应,官方口径回复时机与真人重合 89%,Beta API 同步开放

核心要点速览

  • 官方口径:在 1,785 个真实对话问题上,Nuplex 回复时机与真人重合 89%,第二名系统为 35%;对比对象包括 PersonaPlex、Moshi、GPT-Live、Gemini Live
  • 研发 18 个月;Emma 的脸和声音授权自一名真人演员,由演员参与录制真实的倾听、反应和说话方式,而不是生成“平均脸”
  • Nuplex Beta API 可用自己的 prompt 设定人设,并在通话中把长任务交给开发者的工具在后台执行;Beta 期间语言模型由官方托管
  • 限制:不能上传人脸或声音、不能克隆真人,API 视频带可见水印;仅英语、仅 18 岁以上,医疗和未成年人场景暂不开放
  • 开放地区:美国(科罗拉多、康涅狄格、伊利诺伊、得克萨斯除外)、欧盟、英国、加拿大(魁北克除外)
阅读全文
关联模型 / 智能体 / 厂商:

蚂蚁灵波开源触觉基础模型 LingBot-Touch:近 5000 小时真实触觉数据预训练,冻结的 546 万参数编码器让 4 种机器人策略在 26 项真机任务上成功率提升 14–26 个百分点

蚂蚁集团旗下具身智能公司灵波科技(Robbyant)11 月 9 日开源触觉基础模型 LingBot-Touch(Apache 2.0),用 JEPA 式潜空间预测和共享 Haptic Transformer,把压阻、磁感、视触觉三类传感器统一成同一套触觉 token。官方技术报告称:在 26 项双臂灵巧手真机任务上,接入冻结的 546 万参数 Tiny 编码器后,Diffusion Policy、π0.5、LingBot-VLA、T-Rex 的平均成功率分别提升 13.9–24.8 个百分点,而直接喂原始触觉信号最多只有约一半收益。Tiny 与 Small 两个权重已上 Hugging Face。

蚂蚁灵波开源触觉基础模型 LingBot-Touch:近 5000 小时真实触觉数据预训练,冻结的 546 万参数编码器让 4 种机器人策略在 26 项真机任务上成功率提升 14–26 个百分点

核心要点速览

  • 预训练语料 4,983 小时、46.4 万段交互、约 13.3 亿帧,来自触觉手套与遥操作机器人手,覆盖压阻、磁感、视触觉三种原理
  • 官方口径:26 项真机任务平均成功率,LingBot-VLA 48.3%→73.1%、π0.5 48.1%→69.9%、T-Rex 45.4%→68.6%、Diffusion Policy 21.6%→35.6%
  • Tiny 编码器仅 546 万参数,给所增强的策略增加不到 0.2% 参数;Small 为 2176 万参数,两者均为 12 层 Transformer
  • 仿真 12 项灵巧手强化学习任务中成功率 69%,对比任务专用 CNN 特征 46%、无触觉 21%
  • 注意:可迁移到预训练时没见过的传感器型号,但新的传感器排布仍需先做几何标定
阅读全文
关联模型 / 智能体 / 厂商:
⚡ LingBot-Touch⚡ LingBot-VLA⚡ pi0.5🌐 Ant Group🌐 Robbyant

Skild AI 联合 NVIDIA 开源机器人物理求解器 Steel:混合 20 类任务时吞吐达 PhysX 峰值的 13 倍,显存占用少约 62%,已并入 Newton 物理引擎

机器人基础模型公司 Skild AI 11 月 9 日宣布开源内部物理求解器 Steel(Apache 2.0),由其与 NVIDIA 合作开发,作为 GPU 刚体动力学求解器并入开源 Newton 物理引擎,服务 Isaac Lab 机器人训练。官方博客称:20 个单任务基准上几何平均吞吐为 PhysX 的 3.8 倍、MuJoCo Warp 的约 1.3 倍;把 20 类不同机器人任务混在一个批次时,峰值吞吐达 PhysX 的 13 倍,同批次规模下显存约 11 GiB 对 29 GiB。同时开源 WebGPU 版本,可在浏览器里直接体验。

Skild AI 联合 NVIDIA 开源机器人物理求解器 Steel:混合 20 类任务时吞吐达 PhysX 峰值的 13 倍,显存占用少约 62%,已并入 Newton 物理引擎

核心要点速览

  • 官方口径:20 类任务混合批次下 Steel 达 390 万环境步/秒(245,760 个环境),PhysX 峰值为 30 万,约 13 倍
  • 同为 61,440 个环境时 Steel 为 361 万步/秒,是 PhysX 的 12 倍,显存约 11 GiB 对 29 GiB(少约 62%)
  • 20 个单任务基准中 19 个快于 PhysX,几何平均 3.8 倍;约为 MuJoCo Warp 的 1.3 倍;23 关节 Kuka–Allegro 抓取任务达 PhysX 的 6.7 倍
  • Apache 2.0 开源,在 Newton 中以 newton.solvers.SolverSteel 调用;另开源 WebGPU 版本,浏览器内可交互 24 个场景
  • 注意:所有数字仅为物理仿真吞吐,不是端到端策略训练速度,均在单张 RTX PRO 6000 Blackwell 上测得
阅读全文
关联模型 / 智能体 / 厂商:

Zyphra 开源语音合成模型 ZONOS3-Mini:800M 总参、100M 激活的 MoE,Apache 2.0 协议,手机浏览器内实时运行,可逐词控制语气与声线克隆

Zyphra 11 月 9 日发布开源语音合成(TTS)模型 ZONOS3-Mini,权重以 Apache 2.0 协议上架 Hugging Face。它是稀疏 MoE 模型,总参数 8 亿、每 token 激活约 1 亿,用 112 张 H100 训练 2.5 天。官方口径:在 Pixel 9 浏览器里首段音频延迟低于 570 毫秒,M3 MacBook Air 上低于 150 毫秒;在自建的 ZTTS2-Eval(35 种语言朗读 + 20 种语言真实录音)能力指数上排名开源模型第一,领先 Fish S2 Pro 和 MOSS TTS v1.5。支持声线克隆、年龄/口音/性别调节和逐词语气控制,提供 WebGPU、SGLang、vLLM、GGML、MLX 等运行时。

Zyphra 开源语音合成模型 ZONOS3-Mini:800M 总参、100M 激活的 MoE,Apache 2.0 协议,手机浏览器内实时运行,可逐词控制语气与声线克隆

核心要点速览

  • 规模:800M 总参、约 100M 激活(64 专家、top-2 路由),上一代 ZONOS2 为 8B,Apache 2.0 开放权重
  • 速度(官方口径):Pixel 9 浏览器首段音频 <570 ms,M3 MacBook Air <150 ms;单张 H100 在 8 并发下中位首音 80 ms,峰值每秒生成 457 秒音频
  • 自研 ZAC-1 编解码器帧率 15 Hz(原 DAC 为 86 Hz),同等数据下词错率降低约 10 倍;单次最多生成 10 分钟 44.1 kHz 音频
  • 评测:ZTTS2-Eval 覆盖 35 种语言朗读 + 20 种语言真实录音,420 项能力指数中开源模型排名第一,其次为 Fish S2 Pro 与 MOSS TTS v1.5(自建基准,暂无第三方复现)
  • 上手:浏览器 WebGPU 免安装试用,或 sgl-omni serve --model-path Zyphra/ZONOS3-Mini 起 OpenAI 兼容 /v1/audio/speech 接口
阅读全文
关联模型 / 智能体 / 厂商:
⚡ ZONOS3-Mini🌐 Zyphra

NVIDIA 在 CoRL 发布开放世界动作模型 GR00T 2:同时预测未来画面与机器人动作,未见任务零样本成功率 40%,每任务 5 条示范微调 30 分钟升至 95%,代码 12 月开放

NVIDIA Robotics 官方账号在 CoRL 2026 宣布 GR00T 2,NVIDIA GEAR 实验室负责人 Yuke Zhu 同步发布技术细节。GR00T 2 是基于 Cosmos 的新一代世界动作模型(WAM):一个扩散 Transformer 同时去噪未来视频和动作块,一套模型可驱动平行夹爪、灵巧手和人形机器人。预训练数据包括 40.27 万小时第一视角人类视频、1.02 万小时 UMI 手持夹爪示范和 2.35 万小时机器人遥操作。官方口径下,50 个目标机器人从未练过的任务零样本成功率 40%,每任务 5 条示范(不到 3 分钟机器人数据)在单张 RTX 5090 上 LoRA 微调 30 分钟后升至 95%。推理模型可通过 WAM API 把 GR00T 2 当工具调用。代码 12 月开放,已在 Hugging Face 放出 10 万小时人类视频数据集。

NVIDIA 在 CoRL 发布开放世界动作模型 GR00T 2:同时预测未来画面与机器人动作,未见任务零样本成功率 40%,每任务 5 条示范微调 30 分钟升至 95%,代码 12 月开放

核心要点速览

  • 架构:一个扩散 Transformer 同时预测未来视频与动作块,各机器人只需一个小动作头,一套模型覆盖夹爪、灵巧手、人形机器人
  • 数据:40.27 万小时人类第一视角视频 + 1.02 万小时 UMI 示范(2897 个任务)+ 2.35 万小时遥操作;人类视频占比从 0 提到 100%,真机任务进度从 50% 升到 70%(官方口径)
  • 适配:50 个未见任务零样本 40%,1 条示范 71%,5 条示范 95%,单张 RTX 5090 LoRA 微调约 30 分钟
  • Agent 协作:推理模型经 WAM API 调用 GR00T 2,三种玩具连续 100 次组装各成功 97 次以上;在画面上标注抓取点后指令遵循率从 40% 升到 92%
  • GR00T 2 Turbo 为 2B 参数版本,在 Unitree G1 的 Jetson Thor 上单次预测 124 毫秒;代码 12 月开放,10 万小时人类视频已上 Hugging Face
阅读全文
关联模型 / 智能体 / 厂商:
⚡ GR00T 2⚡ GR00T 2 Turbo⚡ Cosmos🌐 NVIDIA