AI 编程实时动态与要闻

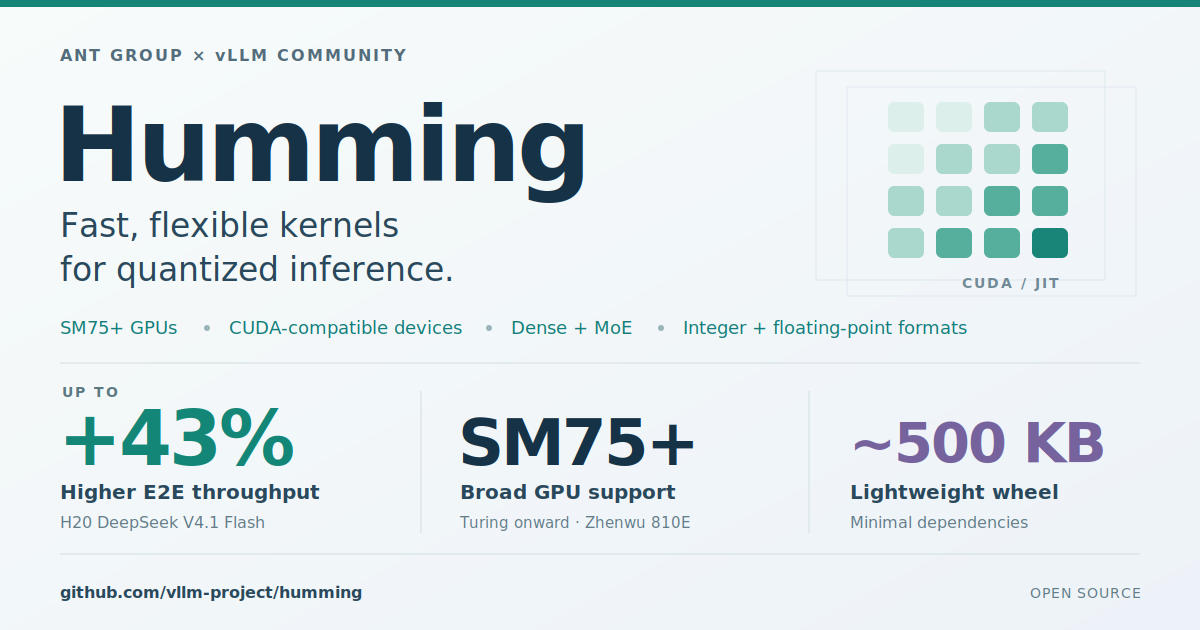
vLLM 联合蚂蚁集团开源 Humming 算子库:最高 5 倍算子加速,MoE 端到端吞吐提升 43.3%

vLLM 官方联合蚂蚁集团正式开源底层高性能量化推理算子库 Humming(humming-kernels)。该算子库专为大规模混合专家(MoE)与低精度密集模型的高并发服务而设计,全面覆盖 WnA16、W8A8、W4A8 与 W4A4 多种量化精度,横跨 INT1~INT8 与 FP4~FP8 数据格式,并原生适配从 NVIDIA Turing 到 Blackwell 架构及平头哥真武 810E 芯片。实测显示,Humming 算子在小 Batch 下比 cuBLAS 快 3~4 倍,在大 Batch 下比 Marlin 快 2 倍;在 8 张 H20 GPU 上运行 DeepSeek-V4.1-Flash,64 并发下整机端到端吞吐暴增 43.3%,首字时延(TTFT)大幅降低 32%,现已作为默认引擎整合至 vLLM v0.29.0+ 中。

vLLM 联合蚂蚁集团开源 Humming 算子库:最高 5 倍算子加速,MoE 端到端吞吐提升 43.3%

核心要点速览

  • vLLM 与蚂蚁集团联合开源 Humming 高性能算子库(Apache 2.0),现已原生内置于 vLLM 0.29.0+ 核心代码中
  • 全方位打通 WnA16、W8A8、W4A8 与 W4A4 低比特精度,算子即时编译耗时仅需 1.82 秒(相比 CUTLASS 的 23.35 秒提速 12 倍)
  • 在 8 卡 H20 集群部署 DeepSeek-V4.1-Flash 实测:64 并发下吞吐从 442 提升至 634 tokens/s(净增 +43.3%)
  • 首字生成时延(TTFT)缩减 25%~32%,在下一代 B300 架构上 MoE 核心算子实现最高 5 倍极限加速
阅读全文

vLLM 与蚂蚁集团开源量化推理内核库 Humming:一套内核覆盖多种量化格式和 Turing 以来全部 NVIDIA GPU,DeepSeek-V4.1-Flash 端到端吞吐提升 14%–43%

10 月 21 日,vLLM 社区与蚂蚁集团开源 Humming(Apache 2.0),一个用 JIT 编译按需生成 GEMM 内核的量化推理库,支持 Turing 起所有 NVIDIA 架构及平头哥真武 810E,覆盖 INT1–INT8、FP4–FP8 等权重/激活组合和稠密、MoE 两类负载。官方微基准中部分场景比 vLLM Marlin、FlashInfer、DeepGEMM 快 2–5 倍;在 8 张 H20 上跑 DeepSeek-V4.1-Flash,MoE 从 Marlin W4A16 换成 Humming W4A8 后吞吐提升 14%–43%。vLLM 0.29.0 起已内置。

vLLM 与蚂蚁集团开源量化推理内核库 Humming:一套内核覆盖多种量化格式和 Turing 以来全部 NVIDIA GPU,DeepSeek-V4.1-Flash 端到端吞吐提升 14%–43%

核心要点速览

  • 一套 JIT 内核框架替代按格式各写一个内核:支持 WNA16、W8A8、W4A8、W4A4,INT1–INT8 与 FP4–FP8 权重,稠密与 MoE
  • 硬件:Turing(SM75)起全部 NVIDIA GPU,含 Blackwell SM100/103/120/121,以及平头哥真武 810E
  • 端到端:8×H20、TP=8 跑 DeepSeek-V4.1-Flash,Humming W4A8 比 Marlin W4A16 吞吐高 14%–43%,平均 TTFT 降 25%–32%;并发 64 时输出 442→634 tok/s
  • 微基准(vLLM 社区测):H200 W4A8-MXFP4 约为 DeepGEMM W8A8 的 4.5 倍,B300 MoE Grouped 路径约为 Marlin 的 5 倍;单个 W4A16 内核编译 1.82 秒,CUTLASS 为 23.35 秒
  • 使用:pip install humming-kernels(wheel 约 500 KB);vLLM 0.29.0 起内置,用 --linear-backend humming --moe-backend humming 启用
阅读全文
关联模型 / 智能体 / 厂商:

vLLM 官方实测追平 DeepInfer:GB200 上吞吐差距缩小至 6%,GB300 单卡达百万 Token/秒

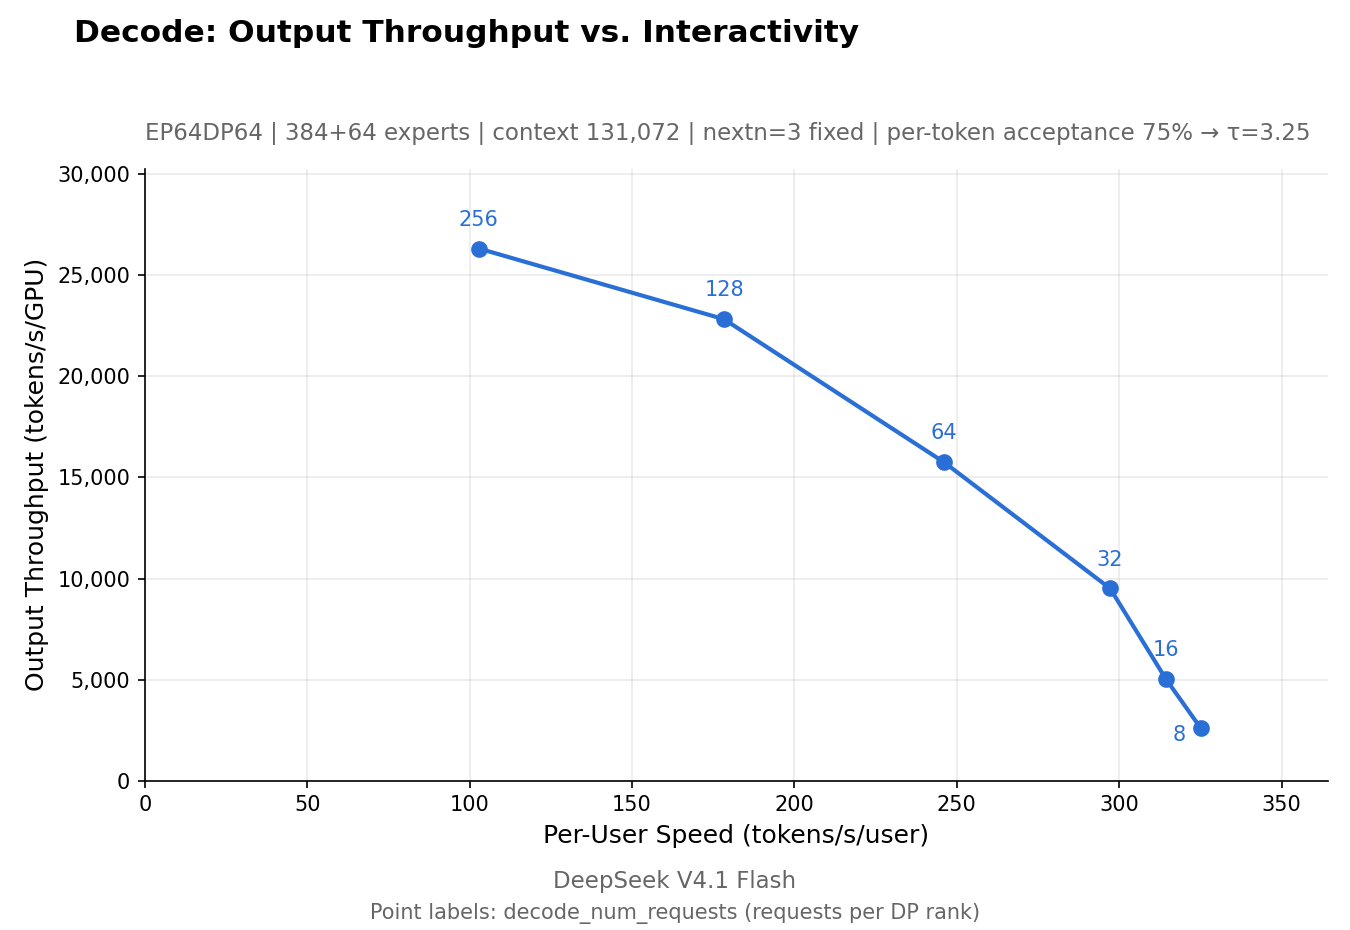
在 DeepSeek 宣布开源其生产级推理引擎 DeepInfer 数小时后,vLLM 官方项目团队正式公布了针对 DeepSeek-V4.1-Flash 的实测重磅性能对标数据。采用 DeepSeek 官方完全相同的测试拓扑(131K 超长上下文、nextn=3 投机采样),vLLM 在 NVIDIA GB200 NVL 架构上针对 Batch Size 8~256 的全并发区间,将与 DeepInfer 的端到端吞吐差距压缩至 6% 以内;在下一代 GB300 架构上,单 GPU 吞吐量突破 1,000,000 Token/秒,单用户峰值输出达 826 Token/秒,折合单 GPU 每小时营收达 38.96 美元。同时宣布 FastH3-Omni 与 Spark-X2.6-4B 首发支持。

vLLM 官方实测追平 DeepInfer:GB200 上吞吐差距缩小至 6%,GB300 单卡达百万 Token/秒

核心要点速览

  • vLLM 团队迅速公布实测对标数据,在 NVIDIA GB200 上运行 DeepSeek-V4.1-Flash 吞吐已追平至仅落后 DeepInfer 6%
  • 在下一代 NVIDIA GB300 硬件架构上,vLLM 实现单张 GPU 吞吐达 100 万 Token/秒,单用户峰值输出 826 Token/秒
  • 按 DeepSeek 线上非高峰期官方定价测算,单台 GPU 每小时可产生高达 38.96 美元的云端推理收益,经济效益惊人
  • 同步宣布对多模态视频大模型 FastH3-Omni 与拥有 100 万上下文的 4B 模型 Spark-X2.6-4B(Apache 2.0)提供 Day-0 首日原生支持
阅读全文
关联模型 / 智能体 / 厂商:

DeepSeek 正式开源 DeepInfer 推理引擎:全面支撑 V4.1-Flash 大规模生产服务,兼顾 NVIDIA SM100 与华为昇腾 950

DeepSeek 官方正式开源其生产级高性能推理引擎 DeepInfer(基于 Apache 2.0 协议发布)。DeepInfer 汲取了 vLLM、SGLang 与 TensorRT-LLM 架构精华,专为大规模部署 DeepSeek-V4.1-Flash 设计。引擎支持 NVIDIA SM100 架构与华为昇腾 Ascend 950 NPU,原生集成 FlashMLA、DeepGEMM、DeepEP 与 TileKernels。引入 DSpark 置信度投机采样(默认 5 个 Draft Token)、SWA 有界重放(140 Token 窗口)与 MoE 专家并行动态负载均衡。同时开源生产级分词与编解码组件 deepseek-recipe,构建从模型、算子到推理服务的全栈开源生态。

DeepSeek 正式开源 DeepInfer 推理引擎:全面支撑 V4.1-Flash 大规模生产服务,兼顾 NVIDIA SM100 与华为昇腾 950

核心要点速览

  • DeepSeek 官方正式开源 DeepInfer 推理引擎(Apache 2.0),完整公开支撑 DeepSeek-V4.1-Flash 线上高吞吐与低延迟调度的底层代码
  • 跨异构硬件深度调优,同时全面适配 NVIDIA SM100 GPU 与华为昇腾 Ascend 950 NPU,提供硬件级确定性输出保证
  • 深度融合 FlashMLA、DeepGEMM、DeepEP 与 TileKernels 原生算子,并搭载基于 DSpark 的 5-Token 置信度投机解码与 140-Token 滑动窗口重放
  • 同步开源生产级 token 编解码套件 deepseek-recipe,彻底消除开源社区本地部署与官方 API 之间的对齐鸿沟
阅读全文
AD赞助内容

DeepSeek 开源生产推理框架 DeepInfer:支撑 V4.1-Flash 线上服务,含投机解码、批次不变推理与结构化输出,同步开源 deepseek-recipe

DeepSeek 于 10 月 20 日(UTC)开源内部推理框架 DeepInfer(Apache 2.0),即支撑 DeepSeek-V4.1-Flash 大规模线上服务的推理栈。本次开源版本提供离线推理,支持 Attention DP/CP、MoE EP+EPLB 并行、DSpark 投机解码、SWA bounded replay、批次不变推理、确定性采样和结构化输出,硬件为 NVIDIA SM100 与华为昇腾 950。KV cache 系统、PD 分离和负载均衡未包含在内。同时开源的 deepseek-recipe(MIT)负责把 Chat Completions、Messages、Responses 等格式请求统一转换并编码,对齐官方 API 行为。

DeepSeek 开源生产推理框架 DeepInfer:支撑 V4.1-Flash 线上服务,含投机解码、批次不变推理与结构化输出,同步开源 deepseek-recipe

核心要点速览

  • DeepInfer 以 Apache 2.0 开源,官方称即支撑 DeepSeek-V4.1-Flash 线上服务的推理框架,目前只支持这一个模型
  • 硬件仅支持 NVIDIA SM100(Blackwell)GPU 和华为昇腾 950 NPU;官方性能曲线测于 4 卡 prefill、64 卡 decode
  • 开源版缺 KV cache 系统、VE/Prefill/Decode 分离和多副本负载均衡三块,离完整线上服务还有距离
  • 官方给出的 V4.1 参考成绩(Pass@1,厂商口径):AIME 2026 99.9%、GPQA Diamond 93.4%、HLE-Full 42.6%,用于校验部署是否配置正确
  • 同步开源 deepseek-recipe(MIT,Rust+Python 绑定),统一处理 Chat Completions/Messages/Responses 请求转换与 token 编解码
阅读全文
关联模型 / 智能体 / 厂商:
⚡ DeepSeek-V4.1-Flash-1017🌐 DeepSeek🌐 NVIDIA🌐 Huawei

Unsloth 发布 DeepSeek-V4.1-Flash-1017 动态 GGUF:1-bit 版 250GB、128GB+ 内存可本地跑,Engram 表可放 SSD

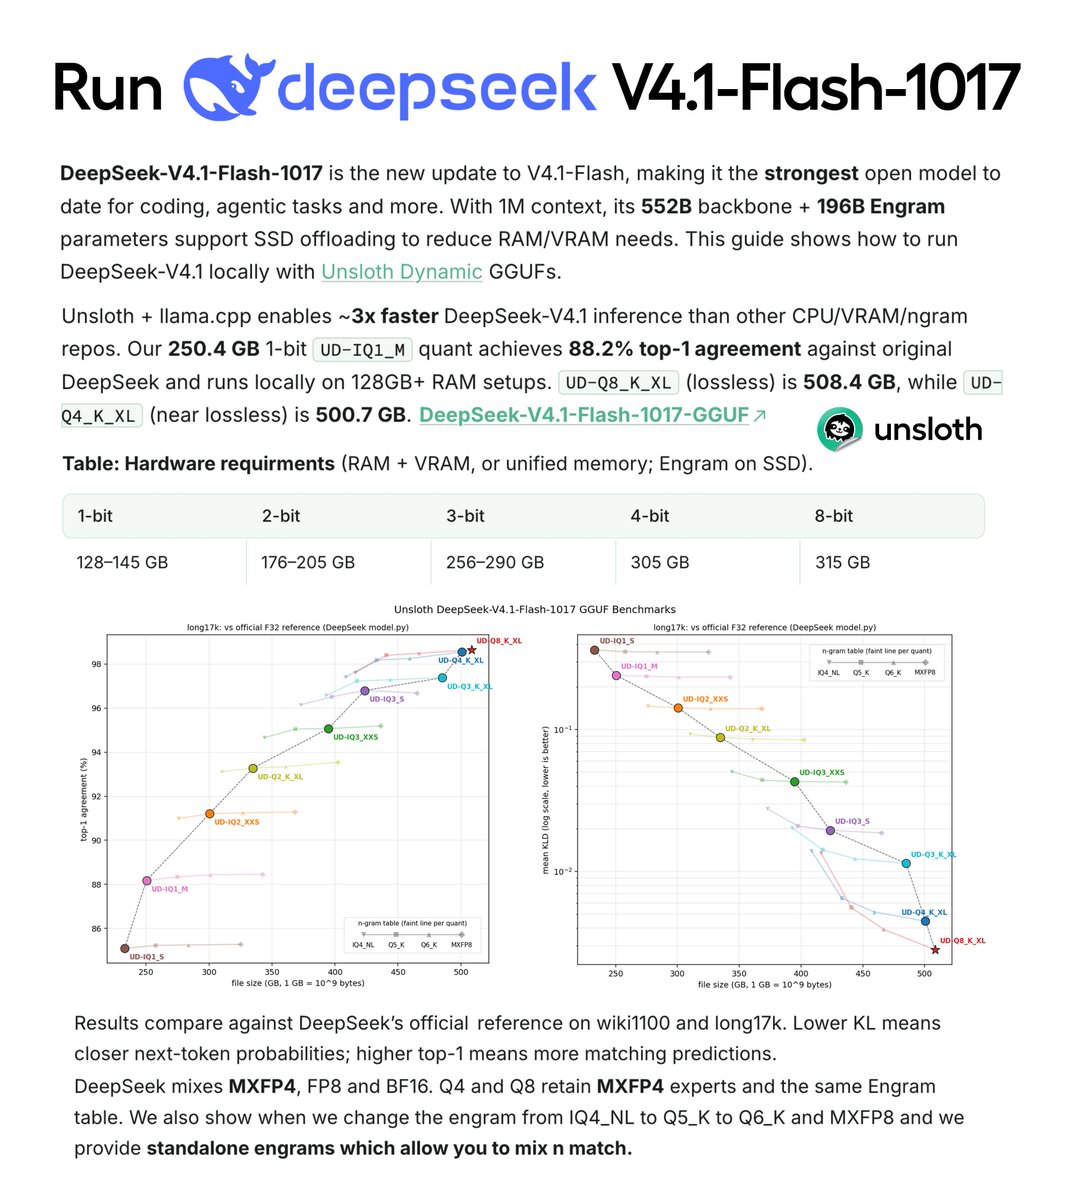
Unsloth 于 10 月 19 日(UTC)发布 DeepSeek-V4.1-Flash-1017 的动态 GGUF 量化与本地运行指南。按 Unsloth 口径,1-bit UD-IQ1_M 体积 250.4GB(无损 Q8 为 508.4GB),在 long17k 上与官方权重 top-1 一致率 88.2%,可在 128GB+ 内存设备上运行;模型的 Engram n-gram 表(110.6–202.8GB)可通过 mmap 留在 SSD 按需读取。目前需用 Unsloth 的 llama.cpp 分支或 Unsloth Desktop 运行。

Unsloth 发布 DeepSeek-V4.1-Flash-1017 动态 GGUF:1-bit 版 250GB、128GB+ 内存可本地跑,Engram 表可放 SSD

核心要点速览

  • 1-bit UD-IQ1_M 250.4GB,较无损 UD-Q8_K_XL(508.4GB)缩小约 51%;long17k top-1 一致率 88.2%、wiki1100 为 87.1%(Unsloth 指南,厂商口径)
  • 最小的 UD-IQ1_S 为 233.0GB,适配 128GB 内存设备(如 Mac、DGX Spark),top-1 一致率 82.8%–85.1%;3-bit UD-IQ3_XXS 需约 256GB(如 Mac Studio),一致率 94.6%–95.1%
  • 模型由 552B 主干加 196B Engram 参数组成,Engram n-gram 表 110.6–202.8GB 可经 mmap 留在 SSD 按需加载,省内存但不省磁盘
  • Unsloth 称其基于 llama.cpp 的实现比其他 CPU/显存/ngram 方案推理快约 3 倍(厂商口径,未见第三方复测)
  • HF 仓库 为 MIT 许可,提供 IQ1_S 到 Q8_K_XL 共 9 档量化,另附可单独替换精度的 Engram 文件
阅读全文
关联模型 / 智能体 / 厂商:

真实世界 3D 资产生成大考:BlenderWorld 首发 223 项工业基准,GPT-6 Astra 斩获 79.9 分领跑

多所顶尖研究机构在 arXiv:2610.23986 中正式发布首个面向真实世界参考的视觉智能体 3D 创作评测基准 BlenderWorld。基准涵盖程序化建模、着色材质编写、空间布局与灯光模拟等 223 项真实工业级任务,接入 Blender 软件全自动沙盒环境。实测显示 GPT-6 Astra 以 79.9 分综合得分问鼎全球榜首(完美完成率达 42.2%),Opus-5 斩获 73.0 分,而开源模型 DeepSeek-V4.1-Flash 斩获 65.7 分超越众多大尺寸基线。

真实世界 3D 资产生成大考:BlenderWorld 首发 223 项工业基准,GPT-6 Astra 斩获 79.9 分领跑

核心要点速览

  • 多所顶尖机构发布首个面向真实世界 3D 资产创作的工业评测基准 BlenderWorld(arXiv:2610.23986),涵盖 223 项全自动 Blender 任务
  • GPT-6-Astra 以 79.9 分与 42.2% 完美率强势领跑全球榜首,Opus-5 斩获 73.0 分位居第二
  • 开源旗舰 DeepSeek-V4.1-Flash 斩获 65.7 分登顶开源第一,并在多模态子任务中以 65.5 分追平商业旗舰 GPT-5.6-Sol
  • 揭示截然不同的 Agent 求解流派:GPT 倾向于前瞻性规划(39.9K Token),而 DeepSeek 依靠高频工具迭代检查(单任务 168 次工具调用)
阅读全文
关联模型 / 智能体 / 厂商:

Arena Code Arena: WebDev 官方更新:DeepSeek-V4.1-Flash 登顶开源榜首,1670 分逼近 GPT-6 Sol 并击败 Claude Opus 5

Arena 官方正式发布 Code Arena: WebDev 最新榜单:深度求索最新推出的 DeepSeek-V4.1-Flash-20261017 (Max) 以 1670 分登顶开源模型第一,全面超越 Kimi K3 (Max) 且推理成本降低近 10 倍。该模型位列全榜总榜第 12,超越 Claude Opus 5 (High) 并与顶尖闭源旗舰 GPT-6 Sol (Max) 差距缩小至约 10 分以内,以百万 Token 输入 $0.3 / 输出 $1.2 的极低资费大幅改写 Pareto 前沿。

Arena Code Arena: WebDev 官方更新:DeepSeek-V4.1-Flash 登顶开源榜首,1670 分逼近 GPT-6 Sol 并击败 Claude Opus 5

核心要点速览

  • DeepSeek-V4.1-Flash-20261017 (Max) 以 1670 分斩获 Arena Code Arena: WebDev 开源模型第一名,超越 Kimi K3 (Max)
  • 位居全榜第 12 名,越级战胜顶尖商业模型 Claude Opus 5 (High),与商业旗舰 GPT-6 Sol (Max) 差距缩小至约 10 分
  • 以百万 Token 输入 $0.3 / 输出 $1.2 的极致费率颠覆性重构 Web 代码生成的 Pareto 效率前沿,成本仅为同等闭源模型的 1/10
  • 相较一个月前的 20260910 版本单月实现 +52 分的性能狂飙
阅读全文
关联模型 / 智能体 / 厂商:

2.8 万亿参数 Kimi K3 单请求飙至 842 tok/s!NVIDIA 联合 vLLM 开源 1.2 万行 CuTe DSL 巨型融合内核,GB300 NVL72 交互吞吐暴涨 1.8 倍

vLLM 联合 NVIDIA 正式发布面向月之暗面旗舰模型 Kimi K3(SemiAnalysis 披露达 2.8 万亿参数)的底层解码巨型内核(Megakernel):由 NVIDIA CentML 工程师采用 CuTe DSL 编写的 1.2 万行代码将注意力、MoE 路由与跨卡通信深度融合,将单层内核启动数从 23 个砍至 13 个、单层耗时从 130 µs 压至 69 µs。在 16 卡 NVIDIA GB300 NVL72 上配合 DSpark 投机解码实现 Batch=1 高达 842 tok/s 的极速输出(提速 1.73 倍),并在 SemiAnalysis AgentX 负载上实现最高 1.8 倍的 P90 单用户交互吞吐提升(突破 403.2~423 tok/s/user),下一步将适配 DeepSeek-V4.1-Flash 与 GLM-5.3。

2.8 万亿参数 Kimi K3 单请求飙至 842 tok/s!NVIDIA 联合 vLLM 开源 1.2 万行 CuTe DSL 巨型融合内核,GB300 NVL72 交互吞吐暴涨 1.8 倍

核心要点速览

  • NVIDIA CentML 联合 vLLM 为 2.8 万亿参数 Kimi K3 打造 1.2 万行 CuTe DSL 解码巨型内核,将单层内核数从 23 个减至 13 个、单层耗时从 130 µs 压至 69 µs
  • 在 16 卡 NVIDIA GB300 NVL72 上配合 DSpark 投机解码实现 Batch=1 高达 842 tok/s 输出(提速 1.73 倍),无投机 Batch=1 达 256.4 tok/s(提速 1.88 倍)
  • 在 SemiAnalysis AgentX 基准上将 P90 单用户交互吞吐提升至最高 403.2~423 tok/s/user(最高 1.8 倍提升),DeepSeek-V4.1-Flash(PR #61868)与 GLM-5.3 支持即将合入
阅读全文
关联模型 / 智能体 / 厂商:

Ollama Cloud 上线美欧本土零数据留存集群并一键接入 Claude Code,SemiAnalysis 揭秘 GLM-5.3 纯靠后训练实现网安能力质变

Ollama 官方宣布在美国与欧盟本土服务器正式上线严格“零数据留存、零训练”的 Ollama Cloud 托管服务,同步接入 DeepSeek-V4.1-Flash-1017 并支持通过 ollama launch 一键拉起 Claude Code 与 OpenCode;同日,SemiAnalysis 披露重磅内幕:智谱旗舰模型 GLM-5.3 未重新预训练,而是 100% 基于前代模型通过高 GPU 效率的后训练(Post-Training)打造,在网络安全与攻防推理上较 GLM-5.2 实现跨代质变。

Ollama Cloud 上线美欧本土零数据留存集群并一键接入 Claude Code,SemiAnalysis 揭秘 GLM-5.3 纯靠后训练实现网安能力质变

核心要点速览

  • Ollama Cloud 正式上线美国与欧盟本土零数据留存(Zero Data Retention)托管集群,支持通过 ollama launch 一键驱动 Claude Code 与 OpenCode 运行 DeepSeek-V4.1-Flash-1017
  • Ollama v0.40.6 同步发布,新增 GGUF q2_0 量化张量类型支持,并彻底修复 Windows 平台孤儿 Runner 进程残留问题
  • SemiAnalysis 披露 GLM-5.3 完全基于前代模型通过高 GPU 效率的后训练(Post-Training)构建而成,在网络安全能力上较 GLM-5.2 实现“昼夜之别”的跨代跃升
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

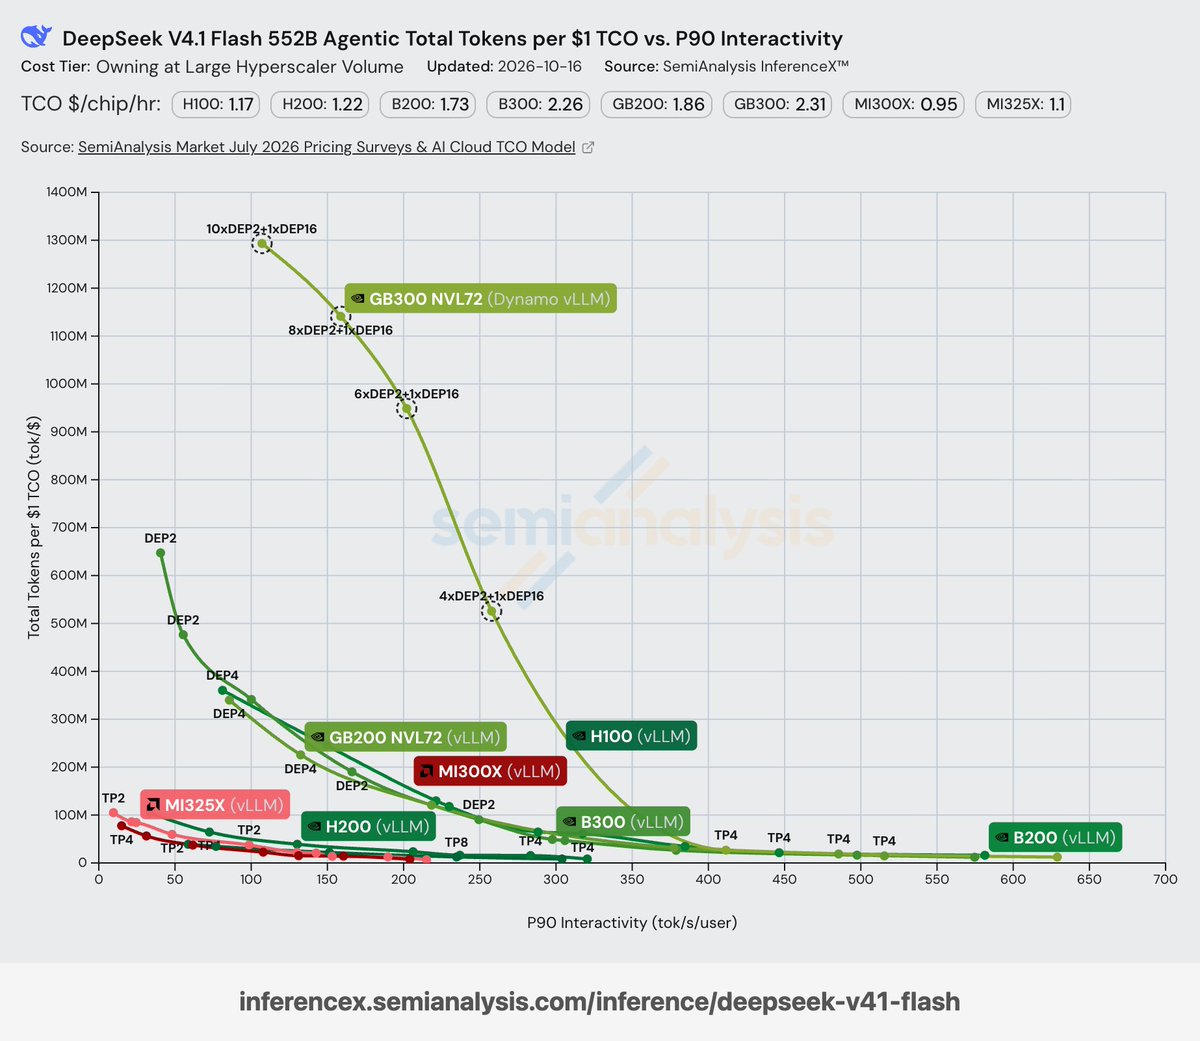
SemiAnalysis 拆解 AgentX 13 亿 Token/$ 纪录:vLLM 联合 Inferact 分离式架构较 B300 聚合模式飙升 4 倍,Cline 揭秘多 Harness 强化学习红利

权威半导体与 AI 算力研究机构 SemiAnalysis 披露了 AgentX 基准实现每美元 TCO 产出 13 亿 Token 的底层架构细节:vLLM 联合 Inferact 采用预填充/解码分离式推理(Disaggregated Serving),在超大规模云商批量计价下单位成本性能达到 NVIDIA B300 聚合式(Aggregated)部署的 4 倍;与此同时,开源编程智能体 Cline 公布实测,指出 DeepSeek-V4.1-Flash-1017 仅靠在多套异构 Coding Agent Harness 上扩展强化学习,便以低 17 倍的成本在 Terminal-Bench 上击败 GPT-5.6-Sol、较前代提分 35%。

SemiAnalysis 拆解 AgentX 13 亿 Token/$ 纪录:vLLM 联合 Inferact 分离式架构较 B300 聚合模式飙升 4 倍,Cline 揭秘多 Harness 强化学习红利

核心要点速览

  • SemiAnalysis 实测确认:vLLM 联合 Inferact 采用预填充/解码分离式架构,在 AgentX 上实现每美元 TCO 产出 13 亿 Token,性价比达 NVIDIA B300 聚合式配置的 4 倍
  • Cline 官方实测指出 DeepSeek-V4.1-Flash-1017 在 Terminal-Bench 上较前代跃升 35%,以低约 17 倍的成本击败 GPT-5.6-Sol
  • 这一 35% 的性能跃升在“零算法创新”下完成,核心归功于在多套真实 Coding Agent Harness 上直接进行强化学习后训练
阅读全文
关联模型 / 智能体 / 厂商:

vLLM 与 OpenRouter 同步上线 DeepSeek-V4.1-Flash-1017 Day-0 极速推理:AgentX 单卡吞吐飙至 830K tok/s,每美元狂吞 13 亿 Token

紧随 DeepSeek-V4.1-Flash-1017 开源发布,vLLM 官宣 Day-0 深度适配,在 SemiAnalysis AgentX 评测中创下每美元 TCO 产出 13 亿 Token、单 GPU 吞吐高达 830K tok/s(保障单用户 100 tok/s 交互速率)的纪录,较初代提速 5 倍;OpenRouter 亦同步上线,第三方供应商最低仅需 $0.10/M 输入与 $0.50/M 输出。

vLLM 与 OpenRouter 同步上线 DeepSeek-V4.1-Flash-1017 Day-0 极速推理:AgentX 单卡吞吐飙至 830K tok/s,每美元狂吞 13 亿 Token

核心要点速览

  • vLLM 在 SemiAnalysis AgentX 基准上为 DeepSeek-V4.1-Flash-1017 实现单 GPU 830K tok/s 吞吐(保障单用户 100 tok/s 速率),每美元 TCO 产出高达 13 亿 Token,较初代提速 5 倍
  • 模型在 DeepSWE v1.1 上斩获 77.0%(超越 Claude Opus 5 的 74.0%),NL2Repo-Bench 达 68.2%,Apex Bench 达 72.1%,且输出更加精炼
  • OpenRouter 同步上线 deepseek/deepseek-v4.1-flash-1017,最低仅 $0.10/M 输入与 $0.50/M 输出;官方 API(deepseek-flash)维持 $0.15/$0.60 不变
阅读全文
关联模型 / 智能体 / 厂商:

DeepSeek 发布 V4.1-Flash-1017:MIT 开源权重同步上线网页、App 与 API,DeepSWE 官方报 77.0,API 价格不变并开放自研 Search/Fetch 接口

DeepSeek 于 10 月 17 日把 V4.1 Flash 升级为 V4.1-Flash-1017,网页、App 与 API 同步切换(deepseek-flash 调用方式和价格不变),权重以 MIT 协议上架 Hugging Face 与 ModelScope。官方口径下 DeepSWE v1.1 从 74.2 升至 77.0、Terminal-Bench 4.0 从 31.2 升至 42.3,同时任务耗时与输出长度下降;同步开放自研搜索引擎驱动的 Search/Fetch API($0.75/千次)。

DeepSeek 发布 V4.1-Flash-1017:MIT 开源权重同步上线网页、App 与 API,DeepSWE 官方报 77.0,API 价格不变并开放自研 Search/Fetch 接口

核心要点速览

  • 官方口径 DeepSWE v1.1 77.0(上一版 74.2),表中高于 Claude Opus 5 的 74.0 与 GPT-5.6 Sol 的 73.0
  • Terminal-Bench 4.0 由 31.2 升至 42.3、ProgramBench 由 20.3 升至 29.1,但仍低于 Opus 5 的 51.8 / 37.0;HLE(无工具)42.6 对 Opus 5 的 56.3
  • API 定价不变:deepseek-flash 高峰期输入(未命中缓存)$0.3、输出 $1.2 每百万 token,非高峰减半;上下文 1M、最大输出 384K
  • Search / Fetch API 各 $0.75/千次;经 DeepSeek Harness、Claude Code、Codex 服务端工具调用的部分免费至北京时间 11 月 1 日 00:00
  • 权重 MIT 开源,Hugging Face 为 FP8 存储(专家权重 FP4),不附 Jinja 模板,需用官方 encoding.py 或 deepseek-recipe
阅读全文

CrowdStrike 披露:攻击者用开源 AI 渗透 Agent ARTEX + Claude Code 攻破多家韩国金融机构

CrowdStrike 情报团队在攻击者暴露的开放目录里找到了 Claude Code 会话记录、ARTEX 配置和 CLAUDE.md:一名疑似中文使用者、以牟利为目的的攻击者,9 月底到 10 月初用中国开发的开源智能体渗透框架 ARTEX(主力模型 DeepSeek v4.1-flash,辅以 GLM-5.3、Grok 4.6)攻击韩国多家金融机构的贷款查询与员工移动办公系统并窃取数据。

核心要点速览

  • 攻击窗口:2026 年 9 月下旬至 10 月初;CrowdStrike 归因置信度为“中等”,未关联到已命名团伙(CrowdStrike 报告)
  • 模型栈:ARTEX 主力后端 DeepSeek v4.1-flash,经疑似 API 转售站 xcai[.]pro 调用;另用 GLM-5.3 与 Grok 4.6 跑 Claude Code 会话
  • IOC:1 个攻击者控制 IP(38.244.50[.]120)+ 9 个代理 IP,报告附 MITRE ATT&CK 映射
  • 受害规模(媒体口径):新韩银行称 25,729 名客户信息被盗,Hana 银行 89 人,Yegaram 储蓄银行约 4 万人(GovInfoSecurity)
  • ARTEX 原 GitHub 仓库 Autumn-27/ARTEX 目前已返回 404
阅读全文
v
vLLMvllm-project·
👀137
🔥90

vLLM v0.31.0:717 提交上线 vllm preload 秒级重启,DeepSeek-V4.1-Flash 默认 FlashMLA,多项安全与破坏性变更

vLLM 于 10 月 5 日发布 v0.31.0(717 提交、307 位贡献者,其中 96 位新人)。新增 vllm preload 权重缓存守护进程让量化后权重跨引擎重启常驻显存,实验性 CRIU 快照可恢复已初始化引擎;DeepSeek-V4.1-Flash 在 SM100 上默认启用 FlashMLA mega attention + NVFP4 压缩 KV;Model Runner V2 支持草稿模型推测解码;安全上默认拒绝请求级多模态 kwargs,并修复 LoRA 名与 cache_salt 的前缀缓存碰撞。升级前需注意多项破坏性变更。

核心要点速览

  • 规模:717 次提交、307 位贡献者(96 位新人),见 Release 说明。
  • 秒级重启:vllm preload 让量化后权重跨重启常驻 GPU,已支持 DP、MTP 草稿模型与 /health 就绪探针;vllm snapshot create/restore 用 CRIU 恢复 TP1 引擎(实验)。
  • 安全默认收紧:请求级 mm_processor_kwargs / media_io_kwargs 默认拒绝,需显式 --trust-request-mm-kwargs;LoRA 路径纳入块哈希,防止前缀缓存串数据。
  • 破坏性变更:移除 tokenizer_mode="slow",quantization="fp8" 在线量化改为 fp8_per_tensor,--enforce-eager 还会关闭 JIT 预热。
  • 模型热路径:GLM-5.3-Flash 元数据操作快 1.6–4.8 倍、索引器省 3 GiB;KimiViT QK RoPE 融合最高 29 倍;Qwen3.8-Flash-Next 在 DGX Spark 上加载省约 25 秒。
阅读全文
关联模型 / 智能体 / 厂商: