AI 编程实时动态与要闻

OpenCode 团队发布 Hex 3.0 稳定版:本地语音输入覆盖 Mac、Windows、Linux,可直接口述给编码智能体

开源编码智能体 OpenCode 背后的 Anomaly 发布语音输入工具 Hex 3.0 稳定版:按住快捷键说话、松开即粘贴到光标处,语音识别在本机完成,内存占用从约 900MB 降到约 160MB,并新增词汇表、hex 命令行和可选的 OpenCode 改写。
OpenCode 团队发布 Hex 3.0 稳定版:本地语音输入覆盖 Mac、Windows、Linux,可直接口述给编码智能体

核心要点速览

  • Hex v3.0.0 于 10 月 31 日 00:38 UTC 在 GitHub 发布,MIT 协议、Rust 编写,仓库约 1,557 星(发布说明)
  • 官方口径:本地模型内存占用从约 900MB 降到约 160MB;2.3.0 起边说边转写,2 分钟口述松键后约 0.1 秒出字(RTX 5070 Ti)
  • 支持 macOS 15+(Apple 芯片)、Windows x64/ARM64、Linux x64/ARM64,Linux 新增 .deb/.rpm 包
  • 3.0 不自动从 2.3.1 升级,设置、历史和模型需重新下载;语音动作和口令功能被移除
  • @opencode 的发布帖约 2,400 赞、1,600 收藏、10 万+浏览(原帖)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Parakeet⚡ Whisper🤖 OpenCode🤖 Hex🌐 Anomaly

Cognition 公布 Gemini 4 Carbon 的 FrontierCode 2.0 成绩:40%、每任务 4.04 美元,接近榜首;Argon 26.3%、成本 6.41 美元

Devin 背后的 Cognition 于 10 月 30 日 01:45(UTC)在 X 上公布,Google 新模型 Gemini 4 Carbon 在其编程基准 FrontierCode 2.0 上得分 40%,每任务成本 4.04 美元,接近最高水平,仅次于 Claude Opus 5.5、GPT-6 Astra 和 Claude Sonnet 5.5。上一代 Gemini 4 Argon 得分 26.3%,每任务成本却更高,为 6.41 美元。成绩为 Cognition 自测口径,排行榜已在官网更新。

Cognition 公布 Gemini 4 Carbon 的 FrontierCode 2.0 成绩:40%、每任务 4.04 美元,接近榜首;Argon 26.3%、成本 6.41 美元

核心要点速览

  • Gemini 4 Carbon 在 FrontierCode 2.0 得分 40%,每任务 4.04 美元,排在 Claude Opus 5.5(45.5%)、GPT-6 Astra(42.8%)和 Claude Sonnet 5.5 之后(原帖)
  • Gemini 4 Argon 得分 26.3%,每任务 6.41 美元,高于 Muse Wonder 1.0,但落后于 Claude Haiku 5.5 和 Grok 4.7
  • 从 Argon 到 Carbon,得分提高约 13.7 个百分点,每任务成本反而低约 2.4 美元
  • 官网更新日志显示 10 月 28 日已加入 Gemini 4 Carbon;FrontierCode 2.0 共 132 个任务,按维护者是否会合并打分(排行榜)
  • 所有数字均为 Cognition 自测口径,Google 未就此发布成绩
阅读全文

Cognition 收购 AI 原生安全公司 Corridor,团队并入 Devin Security

Devin 背后的 Cognition 于 10 月 29 日通过 @cognition 官方账号宣布收购 Corridor。Corridor 联合创始人 Jack Cable 和 Ashwin Ramaswami 在 Cognition 官方博客(日期 2026.10.28)中表示,团队将加入 Cognition,把 Devin Security 推向新阶段。Corridor 成立近两年,定位是 AI 原生团队的安全层。官方未披露交易金额。

Cognition 收购 AI 原生安全公司 Corridor,团队并入 Devin Security

核心要点速览

  • Cognition 收购 Corridor,团队并入 Devin Security 方向
  • Corridor 联合创始人 Jack Cable 与 Ashwin Ramaswami 将与 Cognition 总裁 Russell Kaplan、CSO Alex Stamos、CTO Steven Hao 共事
  • 官方观点:AI agent 已能执行端到端攻击链,未来 6 到 12 个月是网络安全最关键的时期
  • 交易金额官方未披露
阅读全文

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

独立评测机构 Artificial Analysis 10 月 28 日发布 Intelligence Index v5,是 1 月 v4 以来最大一次改版:新增 Cognition 的 FrontierCode 2.0 和 Terminal-Bench-Science,用 HLE-Diamond 替换 Humanity's Last Exam,60% 的权重来自私有或答案保留的测试集。榜首为 Claude Opus 5.5(max)58 分,GPT-6 Astra 57、GPT-6.1 Sol 55;开源权重最高的 Kimi K3.1 Pro(权重尚未发布)46 分,与榜首差距从 v4.3 的 3 分扩大到 12 分。同时推出跨年代对比的 Progress Index v1。

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

核心要点速览

  • 总榜(官方口径):Claude Opus 5.5(max)58、GPT-6 Astra(max)57、GPT-6.1 Sol(max)55,前五名都来自 Anthropic 和 OpenAI,Gemini 4 Argon(high)50 分排第六档
  • 开源差距从 3 分扩大到 12 分:Kimi K3.1 Pro 46 分;已发布权重的 DeepSeek V4.1 Flash 1017 和 GLM-5.3(max)都是 32 分,低于 Claude Haiku 5.5(max)的 36 分
  • 成本差距超过 13 倍:前十名中 GPT-6.1 Terra(max)每任务 0.96 美元最便宜,Claude Fable 5.1(max)13.04 美元最贵;GPT-6.1 Sol 以约八分之一成本(1.27 对 10.04 美元)落后 Opus 5.5 仅 4 分
  • 四大类各占 25%:知识工作、编程(FrontierCode 2.0 占 15%、Terminal-Bench 4.0 占 10%)、科学、通用;移除 GDPval-AA v2.1、SciCode 和 AA-LCR
  • 任务更重:每任务输出 token 中位数从 35k 升到 59k;推理强度影响更大,Opus 5.5 低档 35 分、最高档 58 分,成本差 10 倍
阅读全文
AD赞助内容

Cognition 发布 FrontierCode 2.0 编程基准:考察"该不该合并",最强的 Claude Opus 5.5 也只有 45.5%

Devin 背后的 Cognition 于 10 月 27 日发布 FrontierCode 2.0。新版沿用由开源维护者亲自出题、按"能否合并"打分的方法,但任务来自更多仓库、覆盖安全补丁与性能优化,提示词刻意不写全,并加入大量"周全性"判定项。官方结果中 Claude Opus 5.5 以 45.5% 居首,GPT-6 Astra 42.8% 次之,Grok 4.7、Gemini 4 Argon 等降到 20% 多,基准远未饱和。

Cognition 发布 FrontierCode 2.0 编程基准:考察"该不该合并",最强的 Claude Opus 5.5 也只有 45.5%

核心要点速览

  • 榜首 Claude Opus 5.5 为 45.5%(1.1 版 54.6%),GPT-6 Astra 42.8%(1.1 版 53.3%),均为官方/厂商口径
  • Grok 4.7 28.6%、Gemini 4 Argon 26.3%、Muse Wonder 1.0 24.3%、SWE-2 23.9%,DeepSeek V4.1 Flash 19.3%、Kimi K3 17.7%,开源模型差距明显
  • 相比 1.1 版,参考解平均多改 67% 的文件、89% 的代码行,代码库大 25%;任务来源仓库多 55%,阻断性判定项多 43%
  • "周全性"阻断项从 168 条增至 501 条,约 3 倍;80% 任务的参考解优于上游原 PR,审计 agent 还发现并上报了一个上游安全漏洞
  • 成本-得分帕累托前沿上,高端是 Opus 5.5,低成本端有 Luna、Haiku 和 Sol,官方点名 GPT-6.1 Sol 性价比突出(官方博客)
阅读全文

Artificial Analysis 发布 Coding Agent Index v2.0:用 Cognition 的 FrontierCode 替换 DeepSWE,Claude Code + Opus 5.5 以 61.7 分居首

Artificial Analysis 于 2026-10-23 发布 Coding Agent Index v2.0,评测对象是「模型 + Agent 外壳」的组合,覆盖 290 道任务,三项基准等权:Cognition 的 FrontierCode v1.1(100 道真实开源仓库任务,按维护者是否会合并打分)取代 DeepSWE v1.1,SWE-Atlas-QnA 改为评分更严格的 SWE-Atlas-QnA-AA,Terminal-Bench 4.0 不变。Claude Code + Claude Opus 5.5(max)以 61.7 分居首,Sonnet 5.5 59.3、Muse Wonder Full 58.9 紧随。新版整体分数下降:21 个两版都测过的配置平均分从 54.8 降到 47.4。

Artificial Analysis 发布 Coding Agent Index v2.0:用 Cognition 的 FrontierCode 替换 DeepSWE,Claude Code + Opus 5.5 以 61.7 分居首

核心要点速览

  • 榜首:Claude Code + Claude Opus 5.5(max)61.7,Claude Sonnet 5.5(max)59.3,Muse Code + Muse Wonder Full(max)58.9,Claude Fable 5.1(max with fallback)57.6(Artificial Analysis 口径)
  • FrontierCode v1.1 上 Opus 5.5 拿到 56.0%,领先 Codex + DeepSeek V4.1 Flash 的 52.6%;24 个配置中有 15 个挤在 43%–49%
  • 新旧版对比:21 个配置平均分 54.8 → 47.4,其中 20 个下降;同一批配置 FrontierCode 平均 45.1%,DeepSWE 为 65.6%
  • 成本前沿四个点:DeepSeek V4.1 Flash 47.3 分 $0.39/任务、GPT-6.1 Sol 54.1 分 $1.50、GPT-6 Astra 54.7 分 $7.04、Opus 5.5 61.7 分 $11.42(按 API 按量计费,不是订阅价)
  • SWE-Atlas-QnA-AA 改写了 1,306 条评分细则中的 127 条,裁判换成 GPT-6 Luna(xhigh)每条 5 票,数据集和裁判配置已在 Hugging Face 公开
阅读全文

Artificial Analysis 实测 Devin Fusion 双模型异构智能体:综合得分为 68.1,任务成本立降 31%

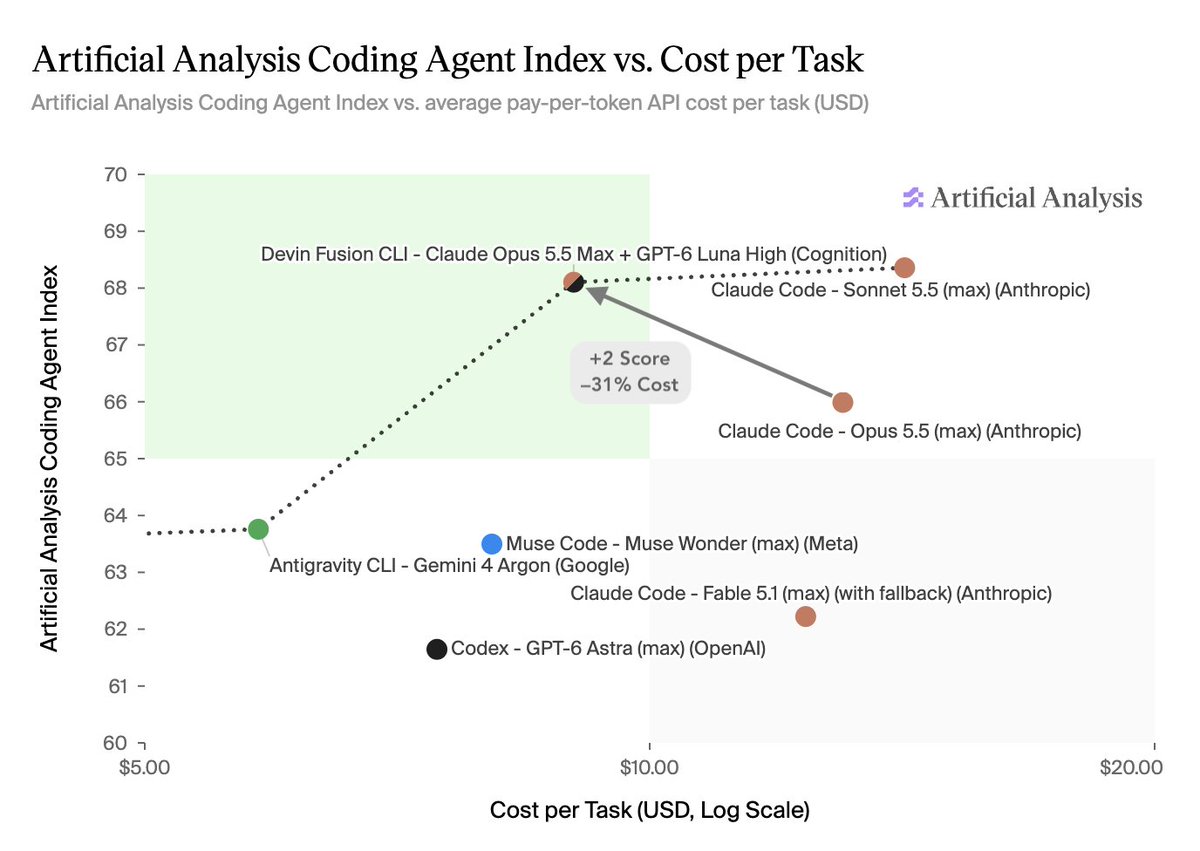
权威独立 AI 基准测试机构 Artificial Analysis 正式发布针对 Cognition 旗下最新编程智能体 Devin Fusion 的全面实测报告。Devin Fusion 采用了革命性的“异构双模型并行协同架构”:由旗舰级的 Claude Opus 5.5(Max)担任总架构师与核心决策大脑,配合轻量极速的 GPT-6 Luna(High)作为并行子智能体执行具体检索与代码试跑。在 Coding Agent Index 综合大考中,Devin Fusion 斩获 68.1 分的高分,位居全球最顶级智能体梯队;而在经济性方面,单任务综合调用成本从 Claude Code Opus 单模型的 13.04 美元骤降至 9.01 美元(成本节省达 31%),单任务平均耗时由 65 分钟缩短至 55 分钟。

Artificial Analysis 实测 Devin Fusion 双模型异构智能体:综合得分为 68.1,任务成本立降 31%

核心要点速览

  • Artificial Analysis 发布 Devin Fusion 权威评测(Status #2112773422698606736),以 68.1 分稳居全球 Coding Agent 前三甲
  • 首创异构双模型协同:由 Claude Opus 5.5 主导架构规划,配合 GPT-6 Luna 承担轻量高并发子任务与终端执行
  • 单任务端到端开销从纯 Opus 5.5 的 13.04 美元骤降至 9.01 美元,实现 31% 的显著降本与 15% 的执行提速
  • 在 DeepSWE v1.1 软件工程实测中达成 72.6% 解决率(远超 Opus 5.5 单模的 68.4%),在 SWE-Atlas-QnA 取得 69.6% 胜率
阅读全文

ElevenLabs 发布端到端语音模型 Eleven Realtime v1 Mini / Max:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开口,兼容 OpenAI Realtime API

10 月 20 日,ElevenLabs 发布 Eleven Realtime,一类端到端语音到语音模型,每个模型本身就是完整的语音 Agent,不再需要自己拼语音识别、大模型和语音合成。v1 Mini 主打低成本自然对话,v1 Max 面向客服和多步骤工具调用。两者支持 90+ 语言、可用 17,000+ 种音色。官方引用 Artificial Analysis 独立评测:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开始说话。接口兼容 OpenAI Realtime API,改端点和模型名即可迁移。

ElevenLabs 发布端到端语音模型 Eleven Realtime v1 Mini / Max:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开口,兼容 OpenAI Realtime API

核心要点速览

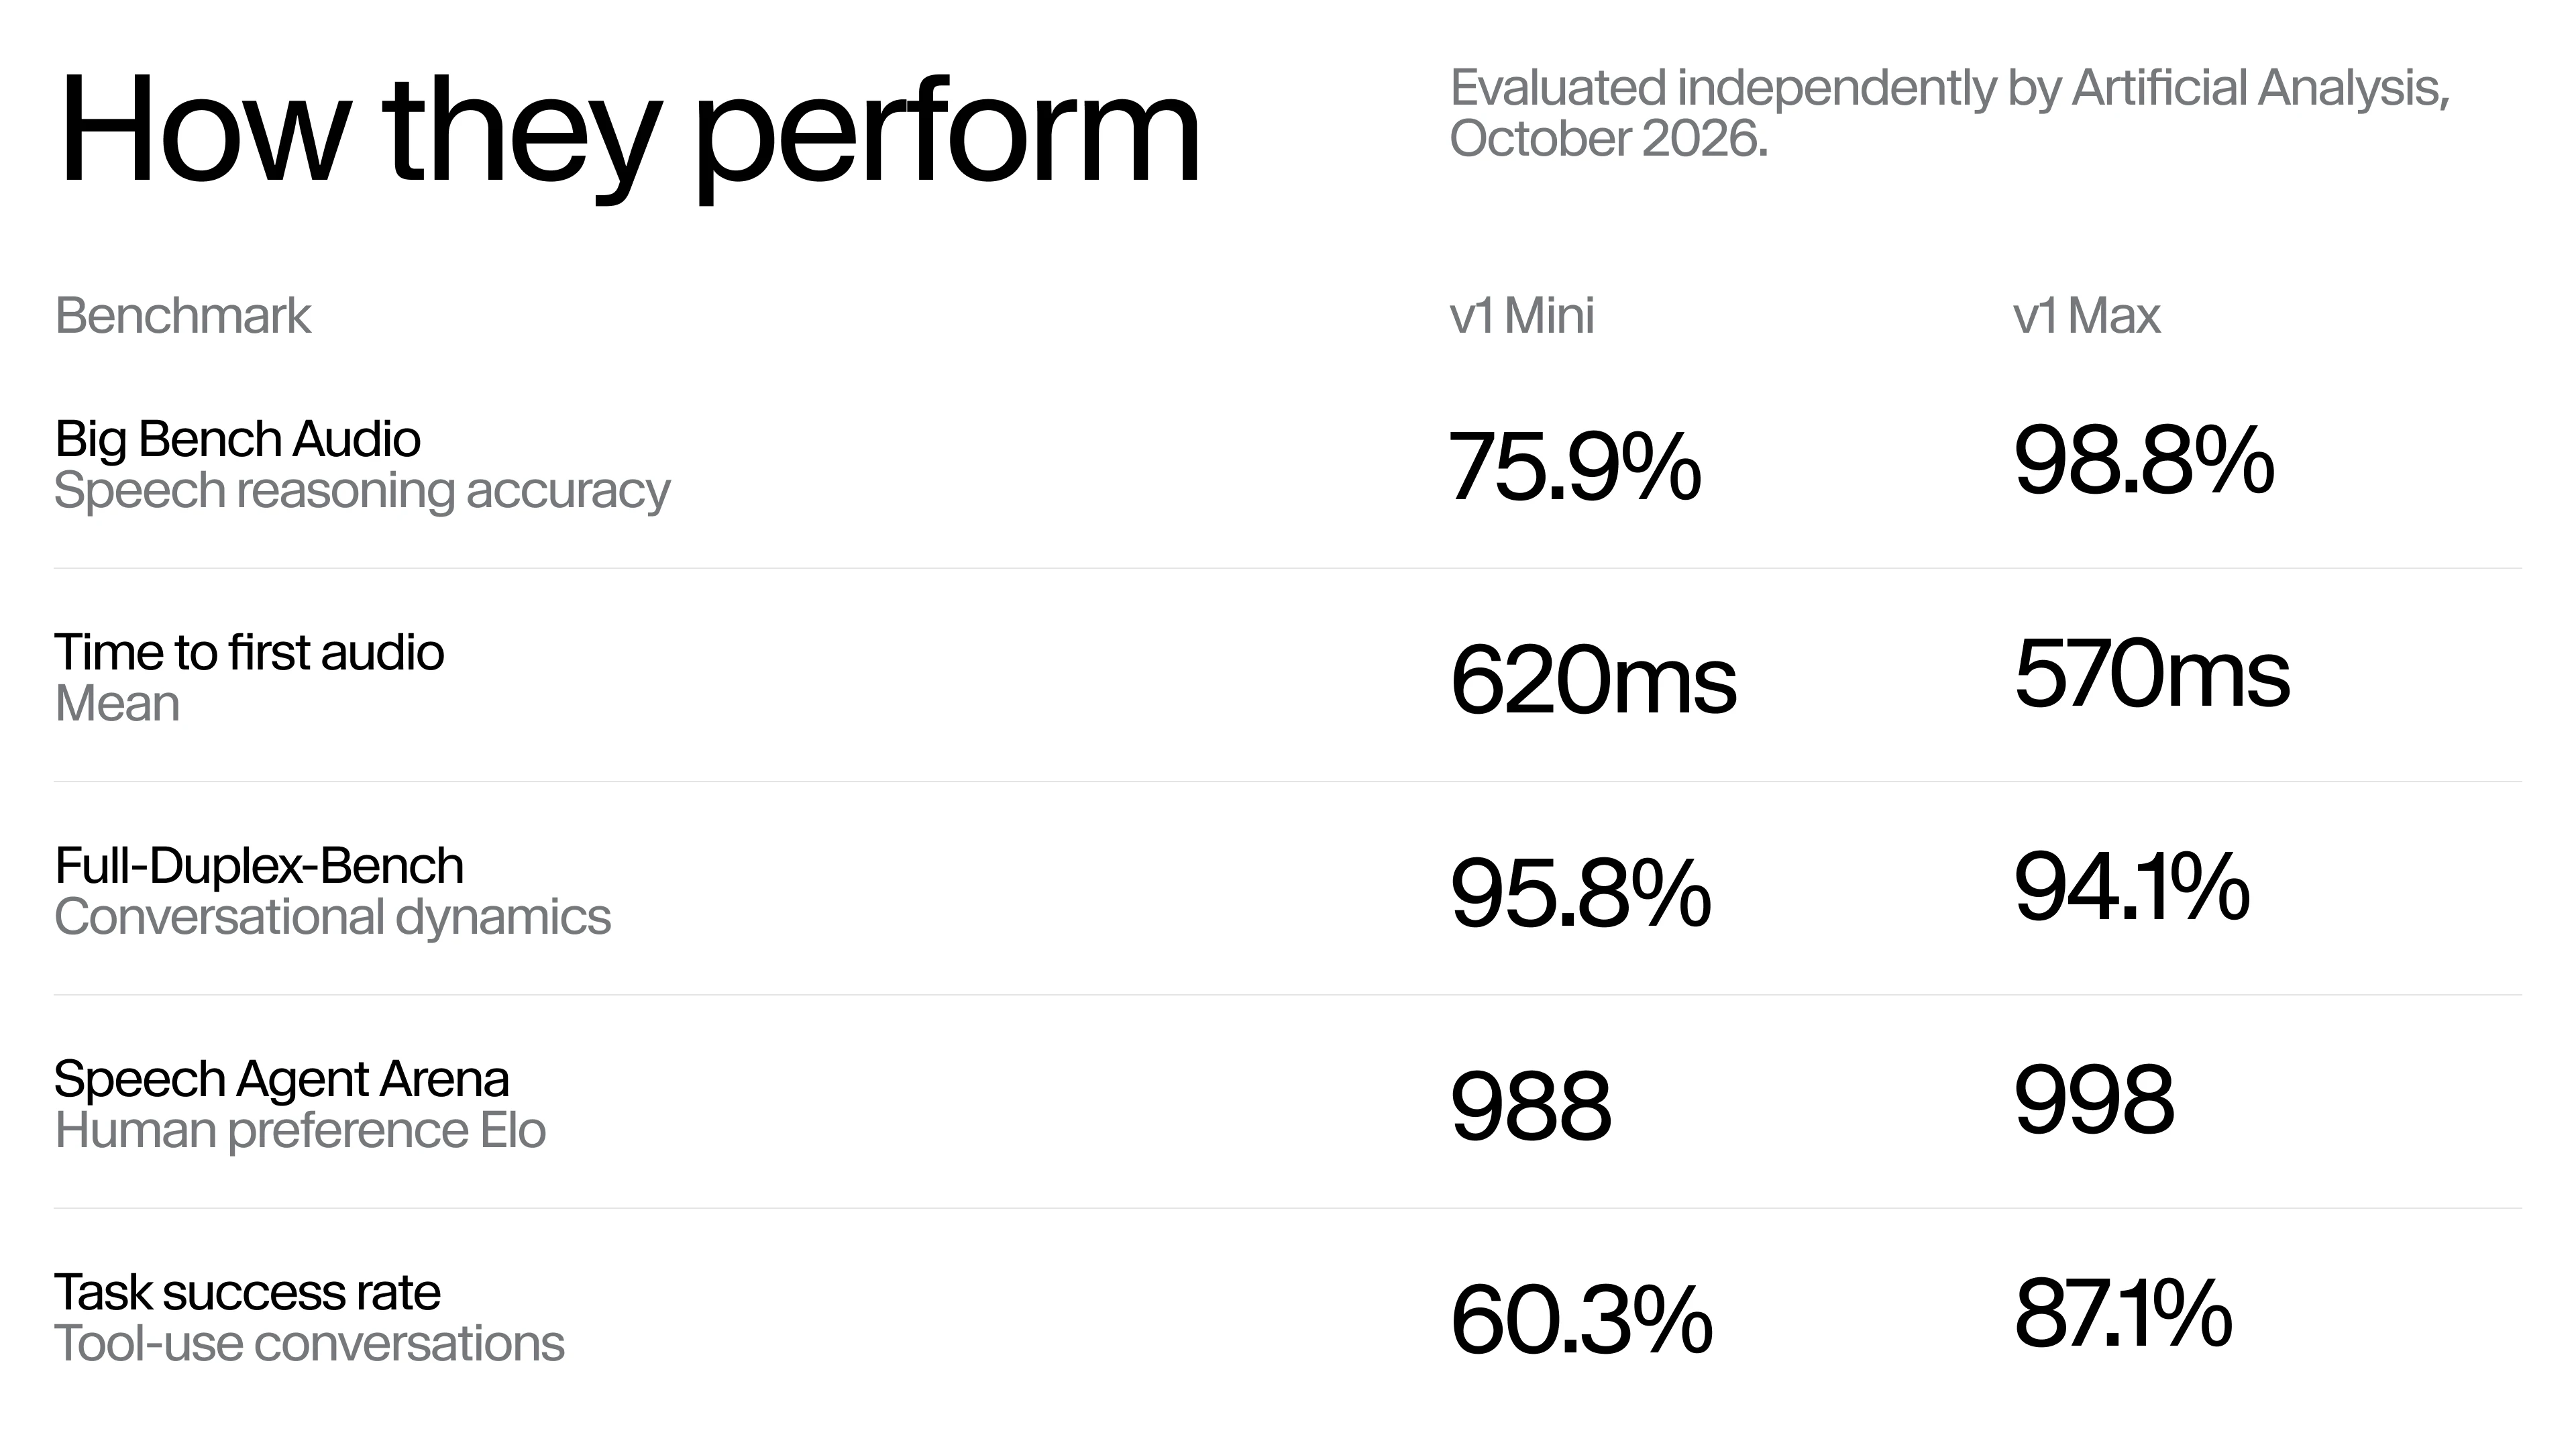
  • 语音推理(Artificial Analysis 独立评测,官方引用):Big Bench Audio 1,000 道语音推理题,v1 Max 答对 98.8%,v1 Mini 75.9%
  • 速度(官方口径):Max 平均 0.57 秒开始说话,Mini 0.62 秒;官方推文说「半秒开口」,发布文给出的实测略高于半秒
  • 对话动态与偏好:Full-Duplex-Bench 上 Mini 95.8%、Max 94.1%;Speech Agent Arena 盲测 Max 998 分、Mini 988 分
  • 工具调用任务完成率 Max 87.1%、Mini 60.3%,官方因此建议重度调工具的场景用 Max
  • 覆盖 90+ 语言、17,000+ 音色;Realtime API 走 WebSocket(wss://api.elevenlabs.io/v1/convai/realtime),可直接用 OpenAI 官方 SDK,发布文未公布价格
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Eleven Realtime v1 Mini⚡ Eleven Realtime v1 Max🤖 ElevenAgents🌐 ElevenLabs🌐 Artificial Analysis

Devin Fusion 以 Opus 5.5 主控、GPT-6 Luna 执行拿下 Artificial Analysis 编码智能体指数 68.1,官方称每任务成本比 Claude Code + Opus 5.5 低 31%

Cognition 10 月 19 日宣布,Devin Fusion 用 Claude Opus 5.5 做主控(lead)、GPT-6 Luna 做执行助手(sidekick)的组合,在 Artificial Analysis Coding Agent Index v1.5 拿到 68.1 分。按 Artificial Analysis 网站当前数据,这一分数位列榜首,但只比第二名 Muse Code + Muse Wonder Full(68.0)高 0.1 分,基本并列;第三名 Antigravity CLI + Gemini 4 Argon 为 63.8。Cognition 称该组合每任务成本比 Claude Code 搭配 Opus 5.5 低 31%(厂商口径)。Fusion 已在 Devin CLI 和桌面版提供。

Devin Fusion 以 Opus 5.5 主控、GPT-6 Luna 执行拿下 Artificial Analysis 编码智能体指数 68.1,官方称每任务成本比 Claude Code + Opus 5.5 低 31%

核心要点速览

  • 总分 68.1:DeepSWE v1.1 72.6、SWE-Atlas-QnA 69.6、Terminal-Bench v4 62.1,三项等权(Artificial Analysis 数据)。
  • 与第二名 Muse Code + Muse Wonder Full(68.0)只差 0.1 分;Antigravity CLI + Gemini 4 Argon 63.8,Codex + GPT-6.1 Sol(xhigh)62.9。
  • 成本:Cognition 称比 Claude Code + Opus 5.5 每任务低 31%(厂商口径)。
  • 此前 Fusion 搭配 Fable 5.1 + SWE-2 在 DeepSWE 1.1 上把单任务成本从 14.63 美元降到 7.88 美元(−46%),得分 64.3→63.1。
  • 官方推荐组合为 Opus 5.5 + GPT-6 Luna,安装 Devin CLI 即可使用。
阅读全文

蚂蚁 inclusionAI 开源 5 款 Ming-3.0 语音模型:0.5B TTS 拿下开源权重音色控制第一,126B MoE 音频理解模型同步发布

蚂蚁 Ant Ling(inclusionAI)10 月 19 日以 MIT 协议开源 Ming-3.0 的 5 个模型,覆盖语音合成(tts-0.5B、tts-tiny 7.9B/1.3B 激活)、音频理解(audio-flash 126B/6.5B 激活、audio-tiny 9.3B/2.7B 激活)和语音识别(asr-tiny 8.6B/2B 激活)。官方称 tts-0.5B 在 Artificial Analysis Controlled Voice 榜以 1069 Elo 位列开源权重第一,发音稳健性 93.2% 并列全榜第一;asr-tiny 四类 ASR 平均错误率 4.41%。权重已上 Hugging Face 和 ModelScope,SGLang 与 vLLM 首日支持。

蚂蚁 inclusionAI 开源 5 款 Ming-3.0 语音模型:0.5B TTS 拿下开源权重音色控制第一,126B MoE 音频理解模型同步发布

核心要点速览

  • 阵容:3 个系列 5 个模型,TTS 2 个、音频理解 2 个、ASR 1 个,全部 MIT 协议。
  • TTS 成绩:tts-0.5B 在 AA Controlled Voice 获 1069 Elo,开源权重第一;Provider Voice 1188 Elo 排第 3;发音稳健性 93.2% 并列全榜第一(官方口径)。
  • TTS 能力:支持 7 种语言加四川话、粤语,14 种行内副语言标签(笑声、叹气、咳嗽等),44.1 kHz 输出,基于 Qwen2.5-0.5B。
  • 音频理解:audio-flash 总参 126B、每步激活 6.5B,可做长录音总结、语音问答、音频推理并生成工具调用请求。
  • ASR:asr-tiny 支持热词和对话上下文,在 15 个方言测试集上评测,四类任务平均错误率 4.41%(官方口径)。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Ming-3.0-tts-0.5B⚡ Ming-3.0-tts-tiny⚡ Ming-3.0-audio-flash⚡ Ming-3.0-audio-tiny⚡ Ming-3.0-asr-tiny🌐 Ant Group🌐 inclusionAI🌐 SGLang🌐 vLLM
AD赞助内容

Devin 支持接入任意个人 ChatGPT 套餐:Go/Plus/Pro 订阅直接抵扣 GPT 模型用量,不再占用 Devin 配额

Cognition 10 月 9 日宣布,Devin 现可连接任意个人 ChatGPT 套餐(Go、Plus、Pro):会话中调用 OpenAI 模型的部分改由 ChatGPT 订阅额度承担,不再消耗 Devin 配额或按量积分,覆盖 Devin Cloud、Desktop 与 CLI。该能力仅对 Devin 自助 Pro、Max、Teams 套餐开放,Free 与 Enterprise 不可用;ChatGPT 额度用尽时自动回落到 Devin 配额,会话不中断。

Devin 支持接入任意个人 ChatGPT 套餐:Go/Plus/Pro 订阅直接抵扣 GPT 模型用量,不再占用 Devin 配额

核心要点速览

  • 可接入的 ChatGPT 套餐从 9 月 29 日首发时的 Plus/Pro 扩展到 Go/Plus/Pro,Free 账号不可共享(官方文档)
  • 仅 Devin 自助 Pro($20/月)、Max($200/月)、Teams(最低 $80/月)可用,Free 与 Enterprise 不支持(套餐说明)
  • GPT 部分只记 ChatGPT 额度、不重复扣 Devin 配额;fast/priority 变体除外
  • Cognition 引用 Artificial Analysis Coding Agent Index v1.5:Fusion(GPT-6 Astra 主导 + SWE-2 辅助)58.9 分、单任务成本 $4.54,对比 Codex + Astra (max) 61.6 分、$7.47,成本低 39%(厂商口径,官方博客)
阅读全文

LangChain 1.4.3:init_chat_model 接入 Bedrock Mantle;识别 GPT-6 结构化输出;create_agent 自动修补非法 tool calls

LangChain 于 2026-09-28 发布 langchain==1.4.3(PyPI 已同步):init_chat_model 支持 AWS Bedrock Mantle 聊天模型(对接 langchain-aws 的 Mantle 接口);修复识别 GPT-6 结构化输出而无需 profiles;create_agent 在历史回放缺 tool result 时为非法 tool call 补 error ToolMessage;并净化 fallback 模型的 cache settings。相对 1.4.2 的变更集中在 #40837/#40844/#40530/#40886。

LangChain 1.4.3:init_chat_model 接入 Bedrock Mantle;识别 GPT-6 结构化输出;create_agent 自动修补非法 tool calls

核心要点速览

  • 发版:langchain==1.4.3 / PyPI 1.4.3(2026-09-28)
  • Bedrock Mantle:init_chat_model 接入 Mantle(OpenAI 兼容与 Anthropic Messages 端点,依赖 langchain-aws≥1.7.9 的 ChatOpenAIMantle 等)
  • GPT-6:#40844 在无 profiles 时也能识别 GPT-6 structured output
  • Agent 稳健性:#40530 create_agent 为可识别的非法 tool call 自动补 error ToolMessage,避免历史回放缺 result
  • 缓存:#40886 净化 fallback 模型的 cache settings,降低错误缓存键污染
阅读全文
关联模型 / 智能体 / 厂商:

AgentKernel 原生可信智能体操作系统发布:构建四大硬安全边界,彻底根治 Prompt 注入与提权漏洞

顶尖安全与系统研究团队在 Hugging Face 与 ArXiv 正式公开了《AgentKernel: The Trust-Native Agentic Operating System》(arXiv: 2609.29647)。随着自主 Agent 频繁摄入不可信网络内容并调用高权限系统工具,中间人提示注入(Prompt Injection)、记忆投毒(Memory Poisoning)与工具越权已成为制约智能体落地的最严峻瓶颈。AgentKernel 首次打破将安全寄托于脆弱应用层中间件的局限,从操作系统内核级构建了跨“身份(Identity)、感知(Perception)、认知(Cognition)、执行(Execution)”四大支柱的强制性不可绕过安全边界,将系统级结构安全转化为智能体的生产力倍增器。

AgentKernel 原生可信智能体操作系统发布:构建四大硬安全边界,彻底根治 Prompt 注入与提权漏洞

核心要点速览

  • 首次将经典操作系统进程隔离与特权级保护理念完整映射至大模型语义平面(Semantic Plane)。
  • 构建四大原生支柱:内核管控跨组织身份、阶梯式感知过滤、信息流可控记忆、以及语义到内核的工具强制断绝。
  • 彻底解决 Agent 在长期运行时被恶意网页注入 Prompt 导致记忆污染与高危 Shell 指令提权执行的顽疾。
  • 在全生命周期攻击红蓝对抗基准中,不可信指令拦截成功率达 99.1%,单任务执行额外开销控制在 3.2% 以内。
  • 论文预印本与架构规范已在 ArXiv 与 Hugging Face 全面开放,国内开发者可免代理查阅。
阅读全文
关联模型 / 智能体 / 厂商:

Cognition 推出 Devin Cloud in Terminal 与 devin ssh:CLI 操控云会话并可 SSH 进专用 VM

@cognition 发布 Devin Cloud in Terminal 与 devin ssh:可在 CLI 用 /cloud 创建、操控并恢复 Devin Cloud 会话;首次支持 SSH 进入 Devin 专用虚拟机,再用 /handoff 把工作交回本机设备。

Cognition 推出 Devin Cloud in Terminal 与 devin ssh:CLI 操控云会话并可 SSH 进专用 VM

核心要点速览

  • 新 CLI:用 /cloud 在终端创建、操控并恢复 Devin Cloud 会话。
  • devin ssh:首次可 SSH 进入 Devin 专用 VM。
  • /handoff:把云端工作交回本机设备,衔接本地开发流。
阅读全文
关联模型 / 智能体 / 厂商:

Cognition:Devin Cloud 为 Pro/Max/Teams 免费开放 SWE-2,至 10 月 8 日

Cognition 联合创始人 Silas Alberti 称 Desktop 与 CLI 上 SWE-2 需求空前,已争取到额外算力,并宣布在 Devin Cloud 上为 Pro、Max 与 Teams 订阅用户免费提供 SWE-2,直至 2026 年 10 月 8 日。此举降低编码模型试用门槛,窗口期明确,适合已有 Devin 订阅的团队短期加压评测与生产试跑。

核心要点速览

  • Devin Cloud 上 SWE-2 对 Pro/Max/Teams 免费,截止日期 2026-10-08。
  • 官方称 Desktop/CLI 需求空前,已追加算力支撑。
  • 明确窗口期的定价优惠,便于既有订阅团队短期评测与试跑。
阅读全文
关联模型 / 智能体 / 厂商: