AI 编程实时动态与要闻

Hugging Face 的 Joël Niklaus 发布 Harness Leaderboard:28,849 次试验比较 9 款编码 Agent Harness,厂商口径 mini-swe-agent 均值约 51.4%

2026-11-05,Hugging Face Harness Optimization 研究员 Joël Niklaus(@joelniklaus)发布 Harness Leaderboard:在固定模型/供应商/推理力度下只换 harness,跑 GLM-5.3-Flash、DeepSeek-V4.1-Flash 与 Flint,基准 Terminal-Bench 2.1 与 DeepSWE,共 28,849 次试验、推理花费约 $4,746。作者口径:三模型平均 mini-swe-agent 解决率约 51.4%,Pi 约 49.4% 且每解一题约 $0.29。本条为个人研究排行榜,非 Hugging Face 公司官方产品公告。

Hugging Face 的 Joël Niklaus 发布 Harness Leaderboard:28,849 次试验比较 9 款编码 Agent Harness,厂商口径 mini-swe-agent 均值约 51.4%

核心要点速览

  • 来源:HF 的 Joël Niklaus(Harness Optimization)个人帖 2026-11-05T16:04:08Z,非公司官宣
  • 规模(作者口径):9 款 harness × 开源模型,28,849 次试验,推理花费约 $4,746
  • 方法:固定模型/供应商/推理力度,每任务 3 次尝试;基准 Terminal-Bench 2.1 与 DeepSWE
  • 结果(作者口径):三模型平均 mini-swe-agent ~51.4%,openclaw ~27.3%;Pi ~49.4% / 约 $0.29 每解一题
  • 落地:排行榜与轨迹公开在 HF Space;对照 Harness Lens 看各 harness 提示词与工具差异
阅读全文

Perplexity 下调 Agent API 各 effort 档位价格并新增 ultra:medium 成本降近 90%,ultra WANDR 约 85.9%

Perplexity Developers(@perplexitydevs)于 11 月 5 日宣布:Agent API 所有 effort 档位每查询成本下降、研究质量持平或更高,并新增面向广覆盖长跑的 ultra。厂商口径称 medium 在 BrowseComp/DSQA 从约 55% 提到约 77% 且成本降近 90%;xhigh WANDR 约 76.5% 且约为 8 月配置成本的 25%;ultra 三 Agent 并行再汇总,WANDR 约 85.9%、约 $21.71/任务。

Perplexity 下调 Agent API 各 effort 档位价格并新增 ultra:medium 成本降近 90%,ultra WANDR 约 85.9%

核心要点速览

  • 官方(@perplexitydevs + 博客):各 effort 档位降价且质量持平或更高;新增 ultra
  • 厂商口径:medium BrowseComp/DSQA ~55%→~77%,成本降近 90%
  • 厂商口径:xhigh WANDR ~76.5%,成本约为 2026-08 配置的 ~25%
  • ultra:三研究 Agent 并行 + 第四个汇总;WANDR ~85.9%、约 $21.71/任务;底层 Claude Opus 5.5
  • 接入:effort="ultra" 或 pin [email protected];长任务可用 background
阅读全文

Thinking Machines 发布 Inkling 2 Small:594B/17B MoE、厂商口径 AA Intelligence Index 约 31,Tinker 可推理与微调,权重拟下周 Apache 2.0 开源

Thinking Machines Lab 于 11 月 5 日发布第二代首款模型 Inkling 2 Small:594B 总参 / 17B 激活 MoE,支持图像输入与可变 thinking effort。官方博客称 Artificial Analysis Intelligence Index 约 31,编码、视觉与知识工作相对上一代明显提升。现可在 Tinker 上推理与微调(闭源权重);完成外部安全测试后拟以 Apache 2.0 释出全量权重。Tinker 标价约 $0.30/$1.00 每百万 input/output token(64K)。

Thinking Machines 发布 Inkling 2 Small:594B/17B MoE、厂商口径 AA Intelligence Index 约 31,Tinker 可推理与微调,权重拟下周 Apache 2.0 开源

核心要点速览

  • 规格(官方):594B 总参 / 17B 激活 MoE;Hybrid + Vision;可变 effort;不支持音频(相对上一代)
  • 跑分(厂商口径):AA Intelligence Index 约 31;FrontierCode v2.0 约 25.4%;DeepSWE v1.1 约 72.1%;DesignArena Website Elo 约 1340
  • 供应:今日起 Tinker Playground / 微调与采样可用;闭源;拟下周安全测试后 Apache 2.0 开源权重
  • 定价(Tinker 文档):Prefill $0.30 / Sample $1.00 / Train $1.50 每百万 token(64K);缓存 Prefill $0.03
  • 训练要点(官方):统一 RL 约 1075 步、1700 万+ rollout;早期 checkpoint 曾以 Fledge-Alpha 名在 OpenCode 实测
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Inkling 2 Small⚡ Inkling-Small⚡ Inkling🤖 OpenCode🤖 Tinker🌐 Thinking Machines

Artificial Analysis 改用「单任务耗时」作为头号性能指标:GPT-6 Astra 满档约 17 分钟完成一题,快于 Opus 5.5 与 Gemini 4 Carbon

独立评测机构 Artificial Analysis 于 11 月 4 日(UTC 17:34)在 X 上宣布新版 API 性能基准:头号指标从输出速度改为 Time per Task,即完成一道 Intelligence Index 任务所需时间(每题输出 tokens ÷ 端到端输出速度)。新版覆盖约 1,000 个 serverless 端点,速度改为从发出请求算到最后一个 token,并加入多轮 Agent 编码与知识工作负载。官方数据:GPT-6 Astra 满档 51 tokens/s 但约 17 分钟完成一题,Claude Opus 5.5(max)约 26 分钟,Gemini 4 Carbon(high)约 29 分钟。

核心要点速览

  • Time per Task = 每道 Intelligence Index 任务的输出 tokens ÷ 端到端输出速度;逐 token 很快但话多的模型,可能比慢但省 token 的模型更晚完成任务。
  • 端到端输出速度从发出请求算到收到最后一个 token,包含首 token 前的等待(prefill 与隐藏推理);输出 token 改用各家 API 自报数量,不再用 o200k_base 分词器估算。
  • GPT-6 Astra(max)51 tokens/s,每题约 5 万输出 tokens、约 17 分钟;Claude Opus 5.5(max,111 tokens/s)约 26 分钟,Gemini 4 Carbon(high,71 tokens/s)约 29 分钟,后两者每题约 12–17 万 tokens。
  • 按各家 API 默认档(三者均为 medium),GPT-6 Astra、GPT-6.1 Sol、Opus 5.5 的单任务耗时降约 3–5 倍、成本降约 2–4 倍,Intelligence Index 低约 5–11 分;Opus 5.5 从约 26 分钟/10.04 美元降到约 6.8 分钟/2.45 美元。
  • 官方方法论页显示这是 3.0.0 版(10 月 30 日),测试频率改为每 6 小时一次,并新增端点错误率指标。
阅读全文
AD赞助内容

X 热议:Shopify CEO Tobi Lütke 力挺 monorepo,公司工程师称单一代码库对编程智能体「是一大利好」,反方坚持拆仓

Shopify 杰出工程师 Burke Libbey 11 月 1 日发帖称,迁到 monorepo(单一代码库)对 Shopify 内部的智能体「是一大利好」,虽然需要配套工具、也有要花力气缓解的缺点,但他「不会回头」。这条帖子回应的是 Darren Shepherd 前一天的观点:他讨厌「monorepo 适合智能体」的说法。Shopify CEO Tobi Lütke 随后引用并讲述 Mikhail Parakhin 当年的话:每个工程师都讨厌迁 monorepo,但迁完后没人愿意去不用它的公司。Tobi 的帖子约 1,115 赞、454 收藏、8.9 万浏览,引发大量讨论。这是从业者观点,不是官方技术公告。

核心要点速览

  • 原帖:@tobi 11 月 1 日,15:39 UTC 发布,约 1,115 赞、454 收藏、95 条回复、8.9 万浏览(抓取时)
  • Shopify 杰出工程师 Burke Libbey 原话:迁 monorepo 对 Shopify 的智能体是一大利好,需要用心做工具、缺点要花力气缓解,但「不会回头」
  • 反方 Darren Shepherd(Rancher / k3s 背景)10 月 31 日发帖:讨厌「monorepo 适合智能体」的说法,认为最好的扩展方式是避免扩展
  • Mikhail Parakhin 回应 Tobi 的转述:「有了智能体,这话比以往更对」
  • 引用帖中支持方的核心理由是智能体能一次看到所有调用方、做跨栈类型检查和原子改动;也有人质疑在智能体时代是否更该保留独立演化的小仓库
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:AP 报道 AI 公司借助宗教教聊天机器人分辨对错,Anthropic 已与 15 个以上宗教和跨文化群体对话

X 上正在热议的话题:美联社(AP)最新报道称,一些 AI 公司在思考如何教聊天机器人分辨对错时转向了宗教。财经资讯账号 unusual_whales 11 月 1 日转述这篇报道,称 Anthropic 表示已与来自 15 个以上宗教和跨文化群体的学者、神职人员、哲学家和伦理学者会面,以帮助塑造 Claude 处理道德问题的方式。原帖约 880 赞、16.2 万次浏览、189 条回复,X 也把它列入热门新闻话题。Anthropic 这项工作本身并不新:它在 5 月 19 日的官方文章里就已公开说明。以下为讨论整理,观点按观点写。

核心要点速览

  • 热度:unusual_whales 原帖约 879 赞、189 条回复、66 条引用、16.2 万次浏览(X 公开数据,截至 11 月 1 日 13:10 SGT),X 同时把该话题列为热门新闻
  • 报道来源:美联社(AP),导语引用 Anthropic 联合创始人 Chris Olah 在梵蒂冈教宗良十四世 AI 通谕发布会上的话:“这些不是一个实验室能回答的问题”
  • 官方背景:Anthropic 5 月 19 日发文《Widening the conversation on frontier AI》,称首轮对话对象是来自 15 个以上宗教和跨文化群体的学者、神职人员、哲学家和伦理学者,并强调不是让模型对齐某一种宗教世界观
  • 具体实验:受“导师充当外部良知”这一讨论启发,Anthropic 给 Claude 加了一个可在任务中调用、返回其伦理承诺提醒的工具,官方称在多项内部对齐评测中失准行为明显减少(官方口径,未公布具体数字)
  • 讨论分歧:有人认为借鉴多元传统有价值,也有人担心把宗教分歧带进 AI,或调侃“以后拒答都会显得真的对你很失望”
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Claude🌐 Anthropic
A
Anthropic@AICoder·
👀106
🔥80

Claude Code 2.1.314 发布:新增禁止写出工作目录的权限开关,网关支持按 IdP 分组路由,VS Code 和桌面版也有了空闲压缩

Anthropic 于 10 月 30 日 01:06(UTC)在 GitHub 发布 Claude Code v2.1.314,官方 CHANGELOG 列出 119 条变更,超过一半是修复。新功能主要面向企业:permissions.blockWritesOutsideWorkingDirectories 让 Write、Edit、NotebookEdit 在任何权限模式下都拒绝写工作目录之外的路径;Claude apps 网关的上游可以按 IdP 分组限定使用者,Bedrock 上游可记录触发的 guardrail;空闲压缩扩展到 VS Code 和 Claude Desktop 的 Code 标签页。此外修复了管理员限制 effort 时会话反复报错、claude -p 启动失败却返回 0 等问题。

核心要点速览

  • 规模:v2.1.314 官方 CHANGELOG 共 119 条变更,超过一半为修复,发布于 10 月 30 日 01:06 UTC
  • 安全:新开关 permissions.blockWritesOutsideWorkingDirectories 在所有权限模式下阻止 Write/Edit/NotebookEdit 写到工作目录之外
  • 企业网关:上游可加 groups 列表,只有指定 IdP 组的开发者会被路由过去(故障切换时同样生效);Bedrock 上游新增 guardrail_trace
  • 体验:空闲压缩扩展到 VS Code 和 Claude Desktop Code 标签页,20 万 token 以上的闲置会话会先生成摘要
  • 修复:管理员限制 effort 时 Claude Code 会自动降档重试;claude -p 启动失败现在打印错误并以 1 退出
阅读全文
关联模型 / 智能体 / 厂商:

Claude Code 负责人 Boris Cherny 回应「额度消耗过快」:逐个排查用户会话,未发现回归,几处小问题的修复正在推送

10 月 21 日起不少开发者在 X 上抱怨 Claude Code 额度消耗明显变快。Anthropic 的 Claude Code 负责人 Boris Cherny 于 10 月 28 日(UTC)在 X 上回复:团队看完了用户提交的全部会话 ID,没有找到单一根因,也没有发现 Claude Code 的回归;找到几处让部分会话多耗 token 的小问题,修复正在推送。多数「掉得快」的情况可追溯到一两个重度会话,如 xhigh effort、/goal、Workflows、Agent Teams 和长时间 SDK 任务。

核心要点速览

  • 引发讨论的原帖称额度「掉得快 5 倍」,获约 1,660 个赞、240 多条回复(用户说法,非官方数据)
  • Boris Cherny:逐一检查了用户提交的会话 ID,未发现单一根因或 Claude Code 回归,几处小问题的修复正在推送
  • 重度用法是主因:xhigh effort、/goal、Workflows、Agent Teams、长时间 SDK 任务
  • 子智能体默认继承会话的 effort 等级,容易叠加;/usage 可查看 token 去向
  • 官方文档称 Agent Teams 在 plan 模式下约比普通会话多用 7 倍 token
阅读全文
关联模型 / 智能体 / 厂商:

GitHub Universe 2026:Copilot Fusion 正式 GA,自动路由与编排多模型,Fusion Max 在 Artificial Analysis 编码智能体指数拿 60 分,成本约为 Claude Code + Opus 5.5 Max 的一半

GitHub 10 月 28 日在 Universe 2026 宣布 Copilot Fusion 正式可用(GA)。它把此前研究预览的 Project HydraFusion 多模型编排和 Copilot auto 模型选择合并:用户在模型选择器里选 Copilot Fusion 和努力档位(Standard / High / Max),由系统按任务决定用哪些模型、走 Single、Cascade 还是 Critique 流程。官方称 Fusion Max 在 Artificial Analysis 编码智能体指数得 60 分,比 Claude Code + Opus 5.5 Max 低 2 分,但每任务 API 成本约一半、token 约一半、耗时少约 40%。按所用模型标准价计费,付费用户到 11 月 30 日享 30% 折扣。

GitHub Universe 2026:Copilot Fusion 正式 GA,自动路由与编排多模型,Fusion Max 在 Artificial Analysis 编码智能体指数拿 60 分,成本约为 Claude Code + Opus 5.5 Max 的一半

核心要点速览

  • 跑分(Artificial Analysis 编码智能体指数 v2.0):Fusion Max 60 分,Claude Code + Opus 5.5 Max 62 分;每任务成本 5.59 美元对 11.42 美元,Devin Fusion 组合 62 分、8.00 美元
  • 分项:Terminal-Bench 4.0 得 71 分略领先;FrontierCode 51 分排第三(Claude Code 56、Devin Fusion 54);SWE-Atlas-QnA-AA 57 分偏弱
  • 效率:每任务约 720 万 token,约为 Claude Code + Opus 5.5 的一半,比 Devin Fusion 少 30%;GitHub 称耗时少约 40%
  • 模型池含 Claude Opus 5.5、Claude Sonnet 5.5、GPT-6 Astra、GPT-6 Sol 等;管理员可单独禁用某模型供 Fusion 使用,并把 Fusion 设为默认
  • 可用范围:所有 Copilot 套餐,VS Code、Copilot app、Copilot CLI 和 JetBrains;原 auto / HydraFusion / HydraFusion Max 设置自动迁移到对应档位
阅读全文

Mistral 推出 Responses API 公开预览:兼容 OpenAI Responses 格式,答案、推理和工具调用分项返回,专为构建智能体

Mistral AI 10 月 28 日在 X 宣布 Responses API 进入公开预览,定位为在 Mistral 上构建智能体的接口。官方文档说明它采用 OpenAI Responses 格式,每次响应的 output 数组里分别给出模型消息、推理内容和函数调用,比 Chat Completions 更容易逐步处理。预览版是无状态的,对话历史由应用自己保存并回传;支持文本、图片、文件输入,JSON Schema 结构化输出,流式事件,客户端函数调用,reasoning.effort,以及 POST /v1/responses/input_tokens 计数。服务部署在 Mistral AI Cloud Inference 的欧盟和美国区域。同一帖串还宣布在其云上提供 DeepSeek V4.1 Flash(公开预览)和 GLM 5.3 Flash(正式可用)。

核心要点速览

  • Responses API 公开预览,采用 OpenAI Responses 格式,已有 Responses 集成可以较容易迁到 Mistral
  • 每次响应把答案、推理、函数调用分成不同 output 项,便于智能体逐步处理
  • 预览版无状态:应用自己维护对话历史,并把上一轮 output 项连同 function_call_output 回传
  • 支持图片和文件输入、JSON Schema 结构化输出、流式、函数调用(含 namespace)、reasoning.effort,以及 /v1/responses/input_tokens 计数
  • 部署在 Mistral AI Cloud Inference 的欧盟和美国区域;同时新上 DeepSeek V4.1 Flash(预览)和 GLM 5.3 Flash(GA)
阅读全文
AD赞助内容

Cursor 上线 DeepSeek V4.1 Flash:CursorBench 4.0 四档推理全部落在成本前沿,Max 档 47.7%、每任务 $0.98

Cursor 官方 10 月 27 日(SGT)宣布 DeepSeek V4.1 Flash 已在 Cursor 中可用,在 Cursor Settings > Models 打开即可。Cursor 称该模型每一档推理强度都落在 CursorBench 成本前沿上:每任务 $0.60 到 $0.98,在这个价位没有模型得分更高。官方 CursorBench 4.0 榜单显示,DeepSeek V4.1 Flash 1017 Max 档 47.7%($0.98/任务),Medium 46.3%($0.80),High 45.6%($0.77),Low 44.9%($0.60);同榜最高分 Opus 5.5 Max 为 57.8%,但每任务 $13.43。

Cursor 上线 DeepSeek V4.1 Flash:CursorBench 4.0 四档推理全部落在成本前沿,Max 档 47.7%、每任务 $0.98

核心要点速览

  • 四档跑分(CursorBench 4.0 官方榜):Max 47.7%/$0.98、Medium 46.3%/$0.80、High 45.6%/$0.77、Low 44.9%/$0.60,Max 档在全榜排第 17
  • 性价比对比:Max 档 47.7% 与 Sonnet 5.5 High(47.8%,$1.20)几乎持平但便宜约 18%;Opus 5.5 Max 高约 10 个百分点,但每任务 $13.43,约是它的 13.7 倍
  • 同价位对手:Haiku 5.5 Max 48.4%/$1.12、Haiku 5.5 Extra High 44.3%/$0.56,DeepSeek 正好卡在两者之间的价格段
  • 代价是 token 和步数:Max 档平均每任务约 53.7 万 token、187 步,Sonnet 5.5 High 只用约 3.7 万 token、41 步,长任务时延要有心理预期
  • 开启方式:Cursor Settings > Models 里打开;有个反直觉细节,Medium 档(46.3%)比 High 档(45.6%)分数略高、价格只贵 $0.03
阅读全文

OpenAI 发布 GPT-6.1 Terra:主打快速低价的电脑操作,API 每百万 token $1/$5,比 GPT-5.6 Terra 和 GPT-6.1 Sol 便宜一半

OpenAI 10 月 26 日发布 GPT-6.1 Terra,定位是兼顾视觉推理、精确电脑操作和自然写作的高效模型,今天起向 ChatGPT Work 和 Codex 的 Plus、Pro、Enterprise、Edu 用户开放,API 模型名 gpt-6.1-terra。标准 API 价格为输入 $1、缓存输入 $0.05、输出 $5(每百万 token),官方称比 GPT-5.6 Terra 和 GPT-6.1 Sol 低 50%;上下文 1,050,000 token。官方口径下,它在 Agents' Last Exam 上中等推理强度比 GPT-5.6 Terra 高 15 个百分点、成本约三分之一,Terminal-Bench 4.0 最高强度 50.3%。

OpenAI 发布 GPT-6.1 Terra:主打快速低价的电脑操作,API 每百万 token $1/$5,比 GPT-5.6 Terra 和 GPT-6.1 Sol 便宜一半

核心要点速览

  • 价格(官方文档):输入 $1、缓存输入 $0.05、30 分钟缓存写入 $1.25、输出 $5 每百万 token;单次输入超过 272K token 时整单输入按 2 倍、输出按 1.5 倍计费;Batch/Flex 半价,Fast 模式 2 倍
  • 规格:上下文 1,050,000 token,最大输入 922,000、最大输出 128,000,知识截止 2026-06-01;reasoning.effort 支持 none 到 max 六档,工具调用需走 Responses API
  • 电脑操作(官方口径):Agents' Last Exam 中等强度比 GPT-5.6 Terra 高 15 个百分点、成本约 1/3,与 GPT-6 Astra 持平但每 token 价格只有其 1/10;完成速度比 GPT-6 Astra 和 GPT-6.1 Sol 快 3 倍以上
  • 编程与事实性(官方口径):Terminal-Bench 4.0 最高强度 50.3%,是 GPT-5.6 Terra 公布成绩 21.5% 的两倍多;内部易错题集低强度错误率从 53.6% 降到 16.7%
  • 安全:官方称在 Preparedness Framework 网络安全项达到 Critical 阈值,沿用 GPT-6 Astra 的防护措施
阅读全文

X 热议:Matt Pocock 发帖描绘理想的「agent 编程语言」——像 Rust 一样快、像 Go 一样少设计空间、类型校验最严格,点名 Bend,Chris Lattner 回帖推荐 Mojo

TypeScript 教育者 Matt Pocock(@mattpocockuk,Total TypeScript、AI Hero 作者)在 UTC 2026-10-25 17:23 发帖(原帖)称,下一个伟大的「agent 编程语言」应当像 Rust 一样快、像 Go 一样设计空间小、拥有有史以来最严格的类型/校验系统,并说 Bend 是「有意思的首次尝试」。抓取时约 3,130 赞、84 转发、264 回复、786 收藏、22 万浏览,进入 X 热门话题。Mojo 作者 Chris Lattner 回帖(回帖)推荐 Mojo,并建议把「能面向所有硬件」加进清单。这是观点讨论,不是已证实的结论。

核心要点速览

  • 主帖:原帖,UTC 10-25 17:23 发布,抓取时约 3,130 赞、84 转发、264 回复、786 收藏、22 万浏览
  • 三条标准:速度对标 Rust、设计空间小到像 Go(同一件事写法少)、类型/校验系统要「有史以来最严格」,思路是让编译器替人拦住 agent 写错的代码
  • Chris Lattner 回帖推荐 Mojo,称其具备线性类型、符号约束等高级类型特性,并提议加上「能面向所有硬件」(回帖,抓取时约 40 赞)
  • Bend 作者 Victor Taelin(@VictorTaelin)也在回复串中参与讨论,称 Bend 拦下了 agent 对应用的破坏性修改是「按设计工作」
  • 讨论没有给出任何跑分或对比实验,Bend、Mojo 是否适合 agent 编程目前只是个人观点
阅读全文
关联模型 / 智能体 / 厂商:

BOSS 直聘南北阁实验室开源 Nanbeige4.3-33B:33B 稠密模型、512K 上下文、Apache 2.0,官方称 Terminal-Bench 2.1 达 80.9 超过 Qwen3.8-27B

BOSS 直聘(看准科技)旗下南北阁大模型实验室 @nanbeige 在 UTC 2026-10-25 12:11 发布 Nanbeige4.3-33B(原帖),模型和 Base 版已在 Hugging Face 以 Apache 2.0 开放权重(模型卡)。这是一个 Llama 架构的 33B 稠密模型,支持 512K 上下文,定位为 Nanbeige4.3 系列的「教师模型」,后续会蒸馏出 Nanbeige4.3-3B 等小模型。官方模型卡在同一套 harness、最高思考强度下对比 Qwen3.8-27B、Muse-Glimmer-30B、Gemma4-31B:Terminal-Bench 2.1 为 80.9(Qwen3.8-27B 73.0),DeepSWE 65.5(42.5),但 SWE-Bench Pro 60.3 略低于 Qwen 的 61.7,GDPval 84.8 也低于 86.4。以上均为官方自测成绩,尚无第三方复现。

核心要点速览

  • 官方来源:@nanbeige X 原帖 与 Hugging Face 模型卡,抓取时原帖约 616 赞、79 转发、3.8 万浏览
  • 规格:33B 稠密、Llama 架构、512K 上下文、Apache 2.0,同时开放 Base 版
  • 官方自测编码:Terminal-Bench 2.1 80.9、Terminal-Bench 4.0 23.8、DeepSWE 65.5、SWE-Bench Pro 60.3(Qwen3.8-27B 分别为 73.0、6.3、42.5、61.7)
  • 官方自测协作类:Automation Bench 54.2、JobBench 44.8、GDPval 84.8(Qwen3.8-27B 为 38.3、34.5、86.4)
  • 部署:支持 Transformers、SGLang、vLLM,官方示例用 4 卡张量并行;后续将蒸馏 Nanbeige4.3-3B
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nanbeige4.3-33B⚡ Qwen3.8-27B⚡ Gemma4-31B⚡ Muse-Glimmer-30B🌐 Nanbeige🌐 BOSS Zhipin🌐 Kanzhun

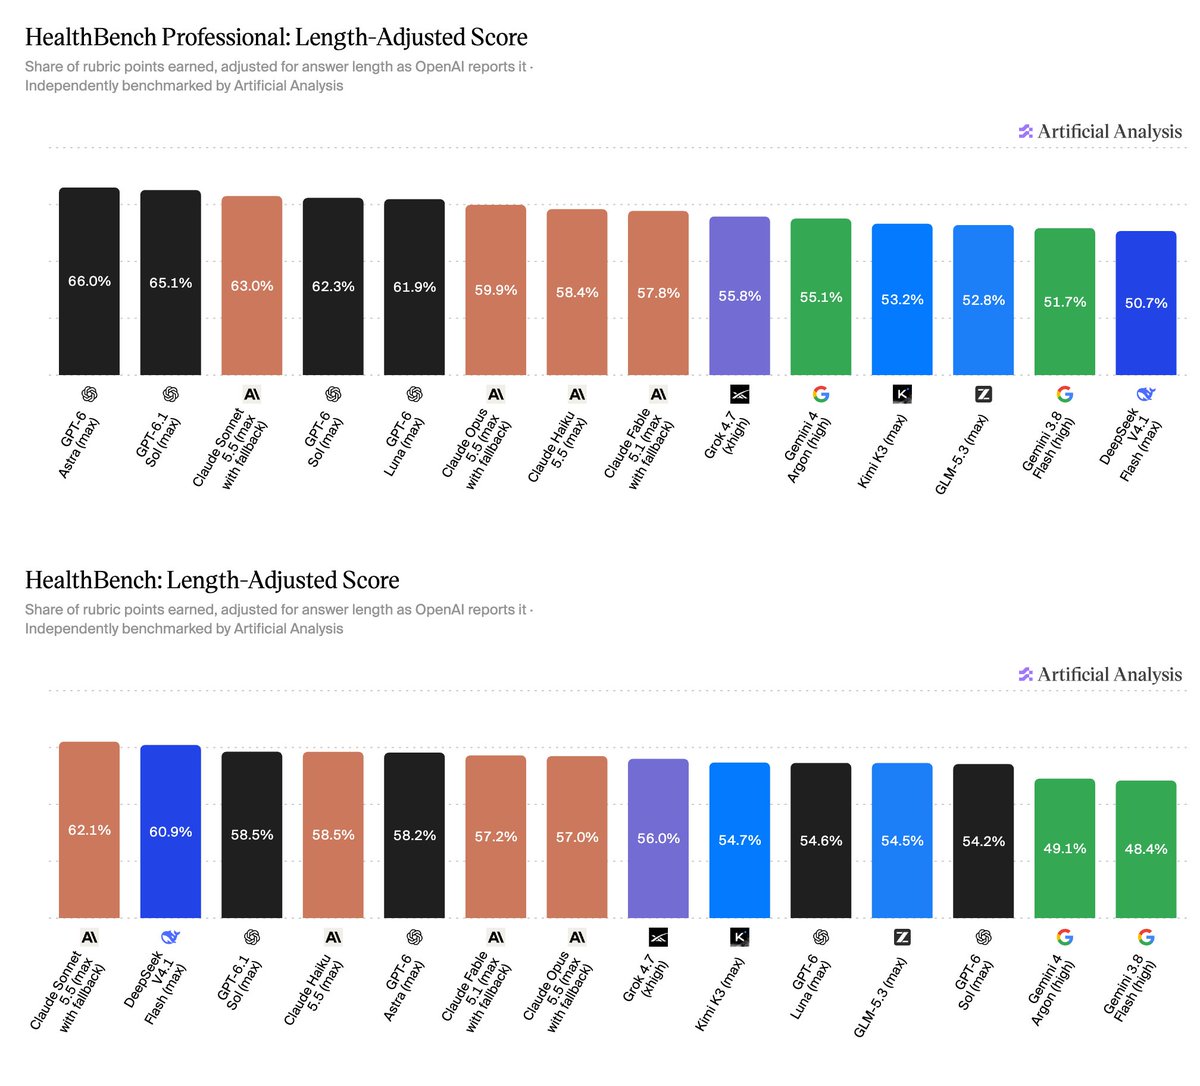
Artificial Analysis 发布 HealthBench 医疗对话基准:长文本惩罚重塑排名,GPT-6 Astra 斩获专业榜第一

权威独立 AI 测评机构 Artificial Analysis 联合医疗领域研究者发布 HealthBench 与 HealthBench Professional 医疗长对话与临床推理基准榜单。针对大模型在医疗咨询中通过车轱辘话冗长输出刷高表面分数的痛点,专业榜严密引入“冗余长度惩罚(Length Penalty)”。实测显示 GPT-6 Astra(最高算力模式)以 66.0% 斩获专业榜全球第一,GPT-6.1 Sol 获 65.1%,而原始得分高达 71.4% 的 Claude Opus 5.5 因平均输出近 6000 字符严重被扣分至 59.9%。

Artificial Analysis 发布 HealthBench 医疗对话基准:长文本惩罚重塑排名,GPT-6 Astra 斩获专业榜第一

核心要点速览

  • Artificial Analysis 推出医疗长对话基准 HealthBench,专业榜严厉引入冗余长度惩罚(Length Penalty)重塑大模型排名
  • GPT-6 Astra(最高算力)以 66.0% 斩获专业榜全球第一,GPT-6.1 Sol 获 65.1%,Claude Sonnet 5.5 以 63.0% 位列第三
  • Claude Opus 5.5 原始未惩罚分数高达 71.4%,但因单次回答平均长达近 6,000 字符严重被扣分至 59.9% 跌落至第 6 名
  • 标准榜中 DeepSeek V4.1 Flash 以 60.9% 斩获第二名,证实国产轻量级模型在医疗问诊领域的卓越泛化能力
阅读全文
关联模型 / 智能体 / 厂商: