AI 编程实时动态与要闻

Anthropic 发布 Claude 选型指南:多数编码任务先用 Opus 5.5(medium),换模型前先调 effort,子 Agent 交给 Haiku 5.5 省钱

Anthropic 开发者博客 claude.dev 11 月 9 日发布 Addy Osmani 撰写的选型指南《Which Claude model should you build with?》,ClaudeDevs 推文获约 9200 赞、1.2 万收藏。核心建议:大多数编码和知识工作先用 Opus 5.5、effort 设 medium(Claude Code 默认);范围明确的修 bug、按规格开发降到 Sonnet 5.5;分类、路由、抽取和读日志类子 Agent 用 Haiku 5.5;大型重构、迁移和深度研究再升到 Fable 5.2。换模型之前先调 effort,并先给模型加上自我验证手段。指南还列出四款模型价格、默认 effort 和迁移时会触发 400 错误的兼容性差异。
Anthropic 发布 Claude 选型指南:多数编码任务先用 Opus 5.5(medium),换模型前先调 effort,子 Agent 交给 Haiku 5.5 省钱

核心要点速览

  • 价格(官方口径,每百万 token 输入/输出):Haiku 5.5 $0.10/$0.50(100K 以上 $0.50/$2.50)、Sonnet 5.5 $2/$10、Opus 5.5 $4/$20、Fable 5.2 $8/$40,四款均为 1M 上下文、128K 最大输出
  • Anthropic 自测 FrontierCode 2.0:Fable 5.2(high)45.3% 与 Opus 5.5(max)45.5% 基本持平,单任务成本约为一半;Opus 拉到 high 以上前建议先试 Fable 5.2
  • SWE-bench Pro 子集:Opus 5.5 先用 low 跑、失败再用 high 重跑,通过率约 97%、每题约 $0.17,全部用 high 为 95.3%、$0.29
  • Opus 5.5 统领最多 25 个并行 Sonnet 5.5 子 Agent 搜索约 2200 万 token 代码,成本比 Opus 单跑低约三分之一,得分相近
  • 迁移坑:Fable 5.2 对所有 API 账号启用 preserved thinking,改动历史上下文会报 400;Sonnet/Opus 5.5 与 Fable 5.2 上 tool_choice 为 any/tool 也会报 400
阅读全文

Meta 发布最小最省的 Muse Ember:每百万 token 输入 0.10 美元、输出 0.50 美元,1M 上下文,AA 智能指数 36 分追平 Claude Haiku 5.5,单任务成本约为其三分之一

北京时间 11 月 10 日凌晨,AI at Meta 官方账号发布 Muse Ember,称其是 Meta 目前最小、最高效的模型,面向 Agent 每天反复执行的工作:工具调用、编码子任务、路由、信息抽取和长文档解析。Muse Ember 支持 1M token 上下文、最多 512K 输出,原生理解文本、图像、音频和视频。定价为每百万 token 输入 0.10 美元、缓存输入 0.004 美元、输出 0.50 美元,已在 Meta Model API(模型名 muse-ember-1.0)和 Muse Code 上线。Artificial Analysis 测得其智能指数 36 分,与 Claude Haiku 5.5(max)持平,但单任务成本约 0.14 美元,只有后者的约三分之一。它是第一个用 Muse Wonder Full 训练出来的模型,权重不开放。

Meta 发布最小最省的 Muse Ember:每百万 token 输入 0.10 美元、输出 0.50 美元,1M 上下文,AA 智能指数 36 分追平 Claude Haiku 5.5,单任务成本约为其三分之一

核心要点速览

  • 定位:Meta 最小、最高效的模型,专做 Agent 的高频小任务(工具调用、编码子任务、路由、抽取、长文档解析);官方建议「Muse Wonder 负责规划,Muse Ember 负责跑量」
  • 规格:1M 上下文、最多 512K 输出,原生支持 文本/图像/音频/视频 输入,支持 Responses API
  • 定价:输入 $0.10、缓存输入 $0.004、输出 $0.50 / 百万 token;输入价约为 Muse Spark 1.3($1.25)的 1/12
  • 跑分(Artificial Analysis):智能指数 36,与 Claude Haiku 5.5(max)持平,单任务成本 $0.14 vs $0.41;Coding Agent Index 46(Haiku 5.5 在 Claude Code 中为 37,GPT-6 Luna 在 Codex 中为 31),但 FrontierCode 2.0 27.2% 落后 Haiku 的 34.9%
  • 短板:AA-Omniscience 知识准确率仅 21.1%,主要因为它拒答 64% 的问题,幻觉率因此只有 17.4%;不开放权重,只能通过 Meta Model API 和 Muse Code 使用
阅读全文

Kimi K3.1 Pro 高速版上架 Amazon Bedrock:Global 定价 $4/$20 与月之暗面官方持平,Flex 档再打 5 折

AWS 于 2026-11-06 宣布 Moonshot AI 的 Kimi K3.1 Pro(Highspeed 高速版)上架 Amazon Bedrock,通过跨区域推理覆盖所有 Bedrock 区域,主打编码与文档处理类 Agent。官方模型卡显示 Global CRIS 每百万 Token 输入 $4、输出 $20、缓存读 $0.20,与 Kimi 官方高速版同价;US/印度区 +10%,Priority 档 1.75 倍、Flex 档 0.5 倍。

核心要点速览

  • 定价(AWS 官方模型卡):Global CRIS 输入 $4 / 输出 $20 / 缓存读 $0.20 / 缓存写 $5(每百万 Token)
  • US 与印度地理路由为 $4.40 / $22,比 Global 贵 10%
  • Priority 档按 1.75 倍计费,Flex 档 0.5 倍,即 Flex 约 $2 / $10,与 Kimi 官方标准版同价
  • 模型 ID moonshotai.kimi-k3.1,1M 上下文,支持显式 Prompt 缓存、工具调用、结构化输出与 Guardrails
  • 这是 Kimi K3 九月上架 Bedrock 之后,月之暗面旗舰第二次进入 AWS 托管目录
阅读全文
关联模型 / 智能体 / 厂商:

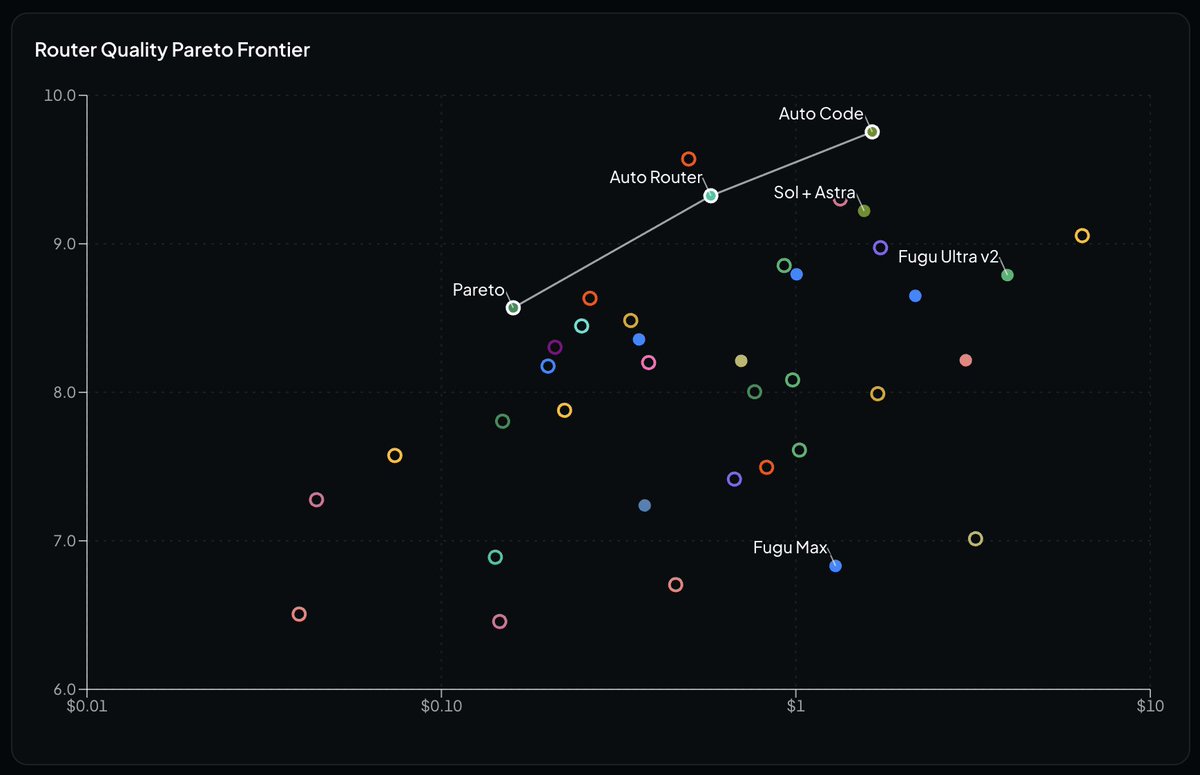
OpenRouter 发布新一代 Auto Router 与 Auto Code:编码路由官方口径接近 Opus 5.5、单任务成本约低 74%

OpenRouter 于 2026-11-06 上线重建后的 Auto Router(openrouter/auto)与面向编程 Agent 的 Auto Code(openrouter/auto-code)。官方称 Auto Code 在五项基准上与 Claude Opus 5.5 接近,单任务成本约低 74%;路由 p90 延迟约 0.65s(旧版约 1.96s)。按请求综合 11 项因素与实时价格、健康与缓存选模,无额外路由费。

OpenRouter 发布新一代 Auto Router 与 Auto Code:编码路由官方口径接近 Opus 5.5、单任务成本约低 74%

核心要点速览

  • 厂商口径:Auto Code 五项基准接近 Claude Opus 5.5,单任务成本约低 74%
  • 延迟:路由步骤 live 测试 p90 约 0.65s,相对旧版约 1.96s(约 3×)
  • 用法:model 设为 openrouter/auto 或 openrouter/auto-code;付所选模型标价,无额外路由费
  • 机制:综合 11 项请求特征 + 实时价/健康/缓存;约九成 agent 轮次不换模以保缓存
  • 兼容:仍支持 cost_tier、allowed_models、excluded_models;chatroom/API 可看路由理由
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Hugging Face 发布 Ultimate MoE Training Handbook:约 50–80 万 GPU 小时实验沉淀为 Megatron-LM 训练手册

2026-11-05,Hugging Face 发布免费「The Ultimate MoE Training Handbook」。Thomas Wolf(联合创始人)称约 80 万 GPU 小时、约 7 万字与 55 幅交互图;作者 Nouamane Tazi 另称约 50 万 GPU 小时。手册面向 Megatron-LM,覆盖路由、专家规模、通信与调试,入口为官方 Space。

Hugging Face 发布 Ultimate MoE Training Handbook:约 50–80 万 GPU 小时实验沉淀为 Megatron-LM 训练手册

核心要点速览

  • 官方:Hugging Face Space「The Ultimate MoE Training Handbook」(2026-11-05)
  • Thomas Wolf(HF 联合创始人)X 口径:约 80 万 GPU 小时、约 7 万字、55 幅交互图
  • 作者 Nouamane Tazi 另称约 50 万 GPU 小时;以 Space 正文为准,不统一编造单一数字
  • 覆盖 Megatron-LM:路由/专家规模/all-to-all/aux loss 与 loss-free bias/升采样与服务
  • 免费开源;适合小团队按 runbook 逐项对照日志落地
阅读全文
关联模型 / 智能体 / 厂商:
⚡ DeepSeek-V4 (Next-Gen MoE)⚡ Nemotron 3 Super⚡ Nemotron 3 Ultra🌐 Hugging Face🌐 NVIDIA

Fireworks 首届 Forge 大会发布一批新品:Ultra-fast 推理公测达 1500 tokens/秒,Background Mode 半价,Nexus Desktop 接入 Codex 与 Claude Desktop,Sovereign 私有部署预览

开源模型推理平台 Fireworks 11 月 3 日在首届 Forge 大会上发布一批新产品:基于 NVIDIA Blackwell 的 Ultra-fast 进入公测,在 DeepSeek V4.1 Flash 上最高 1500 tokens/秒,30 轮 Agent 任务从 1 分钟降到 8 秒;可等待任务的 Background Mode 半价;新增多日 Prompt 缓存和更高限流。Nexus Desktop 把开源模型路由带进 Codex app、Claude Desktop 和 OpenCode,Pro 每月 8 美元起;还有 No Eval、LoRA 无服务器推理、Fireworks Sovereign 私有部署等,并宣布 60+ 伙伴的 Frontier Ecosystem。

Fireworks 首届 Forge 大会发布一批新品:Ultra-fast 推理公测达 1500 tokens/秒,Background Mode 半价,Nexus Desktop 接入 Codex 与 Claude Desktop,Sovereign 私有部署预览

核心要点速览

  • Ultra-fast 公测:基于 NVIDIA Blackwell,在 DeepSeek V4.1 Flash 上最高 1500 tokens/秒;官方基准中 30 轮 Agent 任务耗时从 1 分钟降到 8 秒(Fireworks 官方博客)
  • 省钱选项:Background Mode 对可等待任务半价;多日 Prompt 缓存降低反复恢复上下文的成本;更高的 serverless 限流和 Elastic Burst 已正式可用
  • Nexus Desktop 上线:开源与闭源模型按个人路由,可在 Codex app、Claude Desktop、OpenCode 中使用;Pro 每月 8 美元起,Teams 每席每月 10 美元起
  • 训练侧:No Eval 私测,把生产 trace 转成任务评测;LoRA 无服务器推理公测,先支持 GLM 5.3 Flash,按 token 计费、空闲不收费;Muse Glimmer 30B 免费训练至 11 月 30 日
  • 企业侧:Fireworks Sovereign 私测,把推理引擎部署进客户自己的云或机房;官方称已在客户环境管理超过 2.5 万块 GPU;同时宣布 60+ 伙伴的 Frontier Ecosystem
阅读全文

Anthropic 开源 FlashProve:用 zkSNARK 证明回答确实出自承诺的模型,400B Llama 4 Maverick 单张 H100 约 110 token/秒

Anthropic Frontier Red Team 11 月 2 日发布研究文章并开源 FlashProve(Apache 2.0):模型提供方先对权重做隐藏承诺,之后为每次回答生成零知识证明,用户不需要权重、在普通 CPU 上就能验证回答确实来自该模型,可用来识别中转站偷换模型或 token 流被篡改。官方口径:Llama 4 Maverick(400B MoE,4-bit)上单张 H100 约 110 token/秒,每个 1,024 token 请求的证明约 19 MB,GPU 时间约为 vLLM 推理的 70–95 倍。这是不再维护的研究原型,上下文只支持 1,024 token、只覆盖整数化模型的贪心解码。Anthropic 工程师 Steve Weis 在 X 上转发了这次发布。

Anthropic 开源 FlashProve:用 zkSNARK 证明回答确实出自承诺的模型,400B Llama 4 Maverick 单张 H100 约 110 token/秒

核心要点速览

  • 官方口径:Llama 4 Maverick(400B MoE,4-bit)单张 H100 证明速度约 110 token/秒(24 请求一批的 prefill),每个 1,024 token 请求证明约 19 MB。
  • 代价不小:GPU 时间约为 vLLM 推理的 70–95 倍;仓库性能页显示服务端需约 270 GB 内存,一次权重承诺约 39 分钟。
  • 验证不需要 GPU:C++ 验证器单线程约 21 秒验完一个证明;另有可证明正确的 Lean 验证器,安全性定理在 Lean 4 中给出证明。
  • 对比此前开源方案:VerInf 在同一模型上约 0.02 token/秒;商业方案 Attestable 在 Gemma 4 31B 上 53–77 token/秒,但未开源。
  • 限制:v0.16.0 为不再维护的研究原型,上下文 1,024 token,只覆盖整数化模型的贪心解码,不隐藏模型架构。
阅读全文
关联模型 / 智能体 / 厂商:
A
Anthropic@AICoder·
👀126
🔥80

Claude Code 2.1.314 发布:新增禁止写出工作目录的权限开关,网关支持按 IdP 分组路由,VS Code 和桌面版也有了空闲压缩

Anthropic 于 10 月 30 日 01:06(UTC)在 GitHub 发布 Claude Code v2.1.314,官方 CHANGELOG 列出 119 条变更,超过一半是修复。新功能主要面向企业:permissions.blockWritesOutsideWorkingDirectories 让 Write、Edit、NotebookEdit 在任何权限模式下都拒绝写工作目录之外的路径;Claude apps 网关的上游可以按 IdP 分组限定使用者,Bedrock 上游可记录触发的 guardrail;空闲压缩扩展到 VS Code 和 Claude Desktop 的 Code 标签页。此外修复了管理员限制 effort 时会话反复报错、claude -p 启动失败却返回 0 等问题。

核心要点速览

  • 规模:v2.1.314 官方 CHANGELOG 共 119 条变更,超过一半为修复,发布于 10 月 30 日 01:06 UTC
  • 安全:新开关 permissions.blockWritesOutsideWorkingDirectories 在所有权限模式下阻止 Write/Edit/NotebookEdit 写到工作目录之外
  • 企业网关:上游可加 groups 列表,只有指定 IdP 组的开发者会被路由过去(故障切换时同样生效);Bedrock 上游新增 guardrail_trace
  • 体验:空闲压缩扩展到 VS Code 和 Claude Desktop Code 标签页,20 万 token 以上的闲置会话会先生成摘要
  • 修复:管理员限制 effort 时 Claude Code 会自动降档重试;claude -p 启动失败现在打印错误并以 1 退出
阅读全文
关联模型 / 智能体 / 厂商:

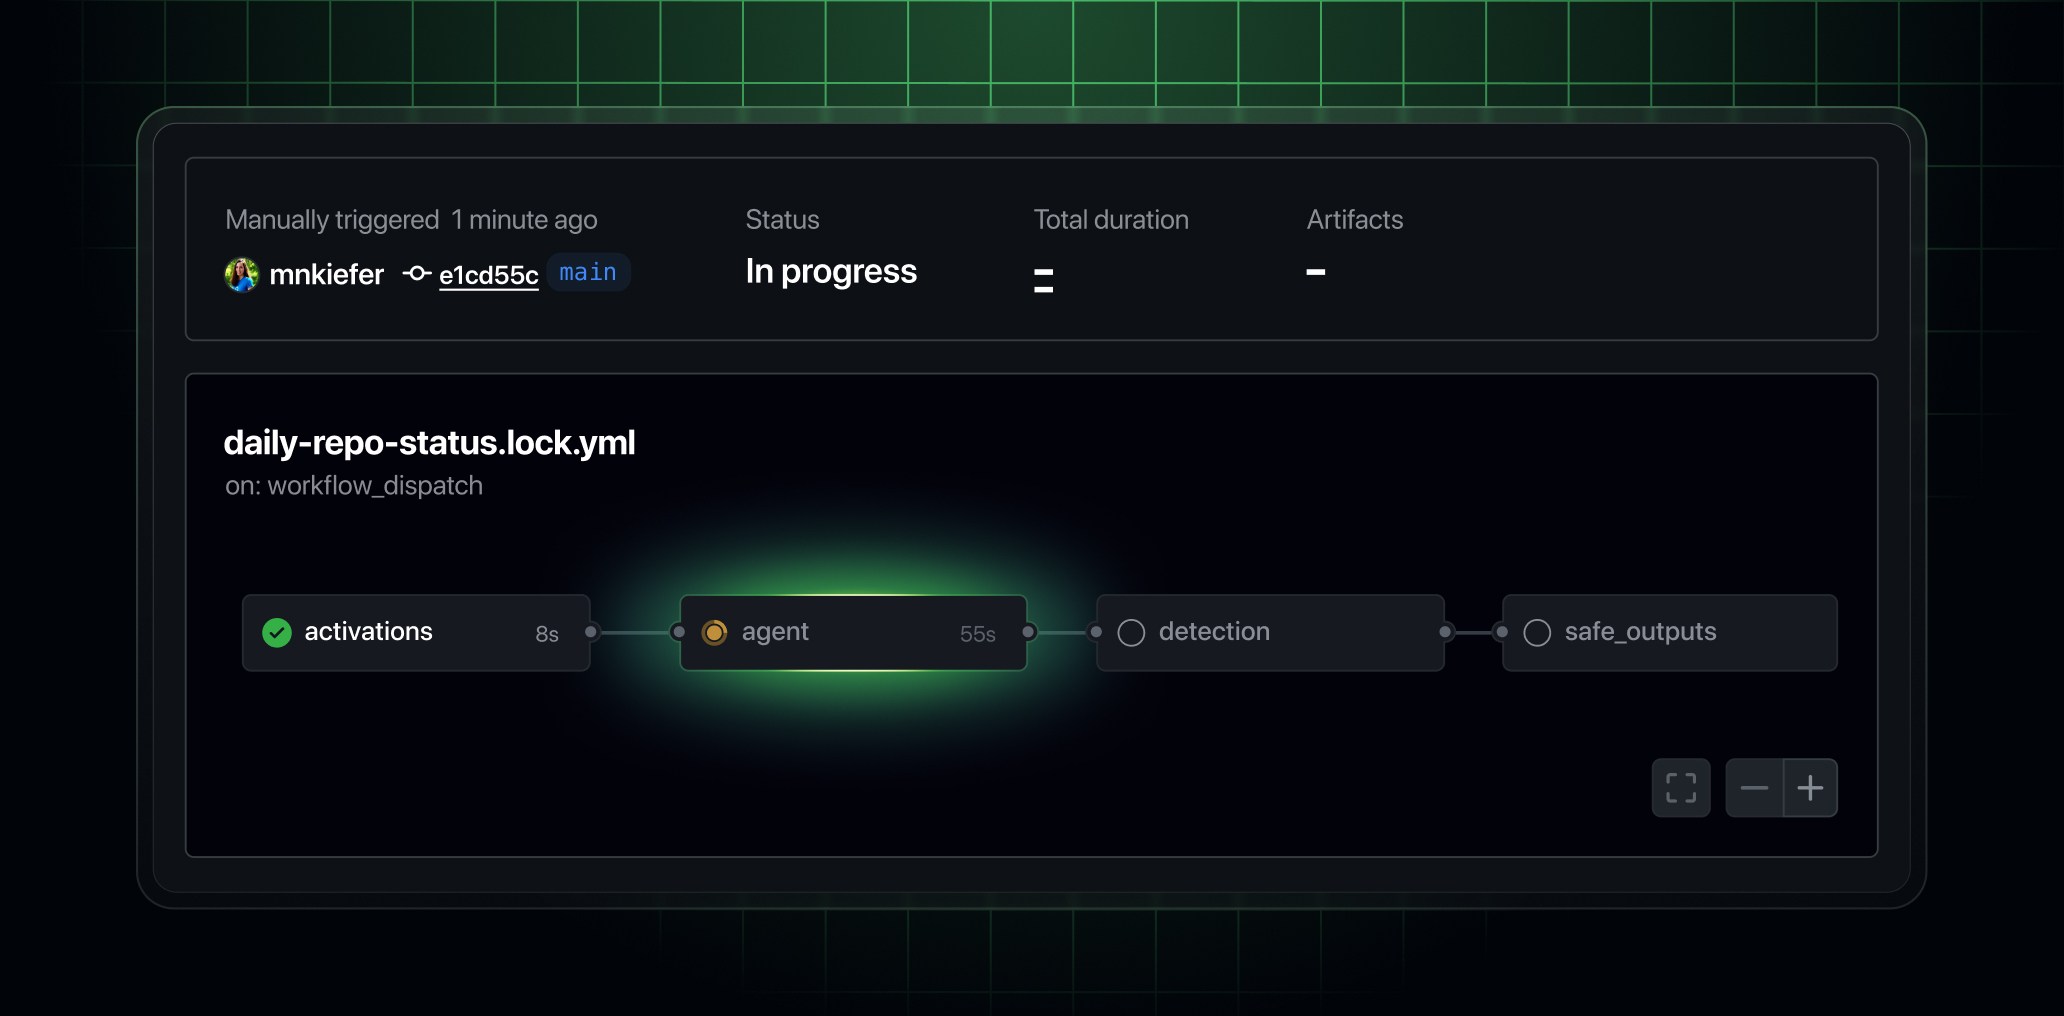
GitHub Agentic Workflows 正式 GA:用 Markdown 写自动化、编译成 Actions YAML,支持 Copilot 或自带编码 Agent,新增 ARC 自托管和 micro-VM 隔离

GitHub 于 10 月 28 日(Universe 2026)宣布 GitHub Next 的开源项目 GitHub Agentic Workflows 正式 GA,面向 GitHub Free、Team 和 Enterprise。开发者用自然语言 Markdown 描述 issue 分拣、CI 失败分析、文档更新、写测试等任务,gh aw 把它编译成标准 Actions YAML,由 Copilot 或自带的编码 Agent 执行。GA 新增 ARC 自托管 runner 和 Docker-in-Docker 支持、正式版 gh aw forecast 成本预估、按工作流选模型和模型路由,以及 Cloud Hypervisor / NVX micro-VM 隔离。

GitHub Agentic Workflows 正式 GA:用 Markdown 写自动化、编译成 Actions YAML,支持 Copilot 或自带编码 Agent,新增 ARC 自托管和 micro-VM 隔离

核心要点速览

  • 适用范围:github.com 上的 GitHub Free、Team 和 Enterprise 均可用;用默认的 Copilot CLI 引擎需要 Copilot 许可
  • 工作方式:Markdown 写需求,编译成标准 Actions YAML,复用已有 runner 组和策略;可用 Copilot 或自带编码 Agent
  • 安全默认值:只读权限、沙箱容器加 Agent Workflow Firewall、safe outputs 校验,以及应用变更前的威胁检测作业
  • GA 新增:ARC 自托管 runner 加 Docker-in-Docker、gh aw forecast 转正(含威胁检测额度和月度区间)、按工作流选模型提供方、模型路由、micro-VM 隔离和跨仓库 enclave
  • 客户案例(Accenture 口径):一位负责人每周省约 29 小时,团队 91% 的 commit 由 AI 编写,生产错误从每天约 11,000 个降到 1,000 以下
阅读全文

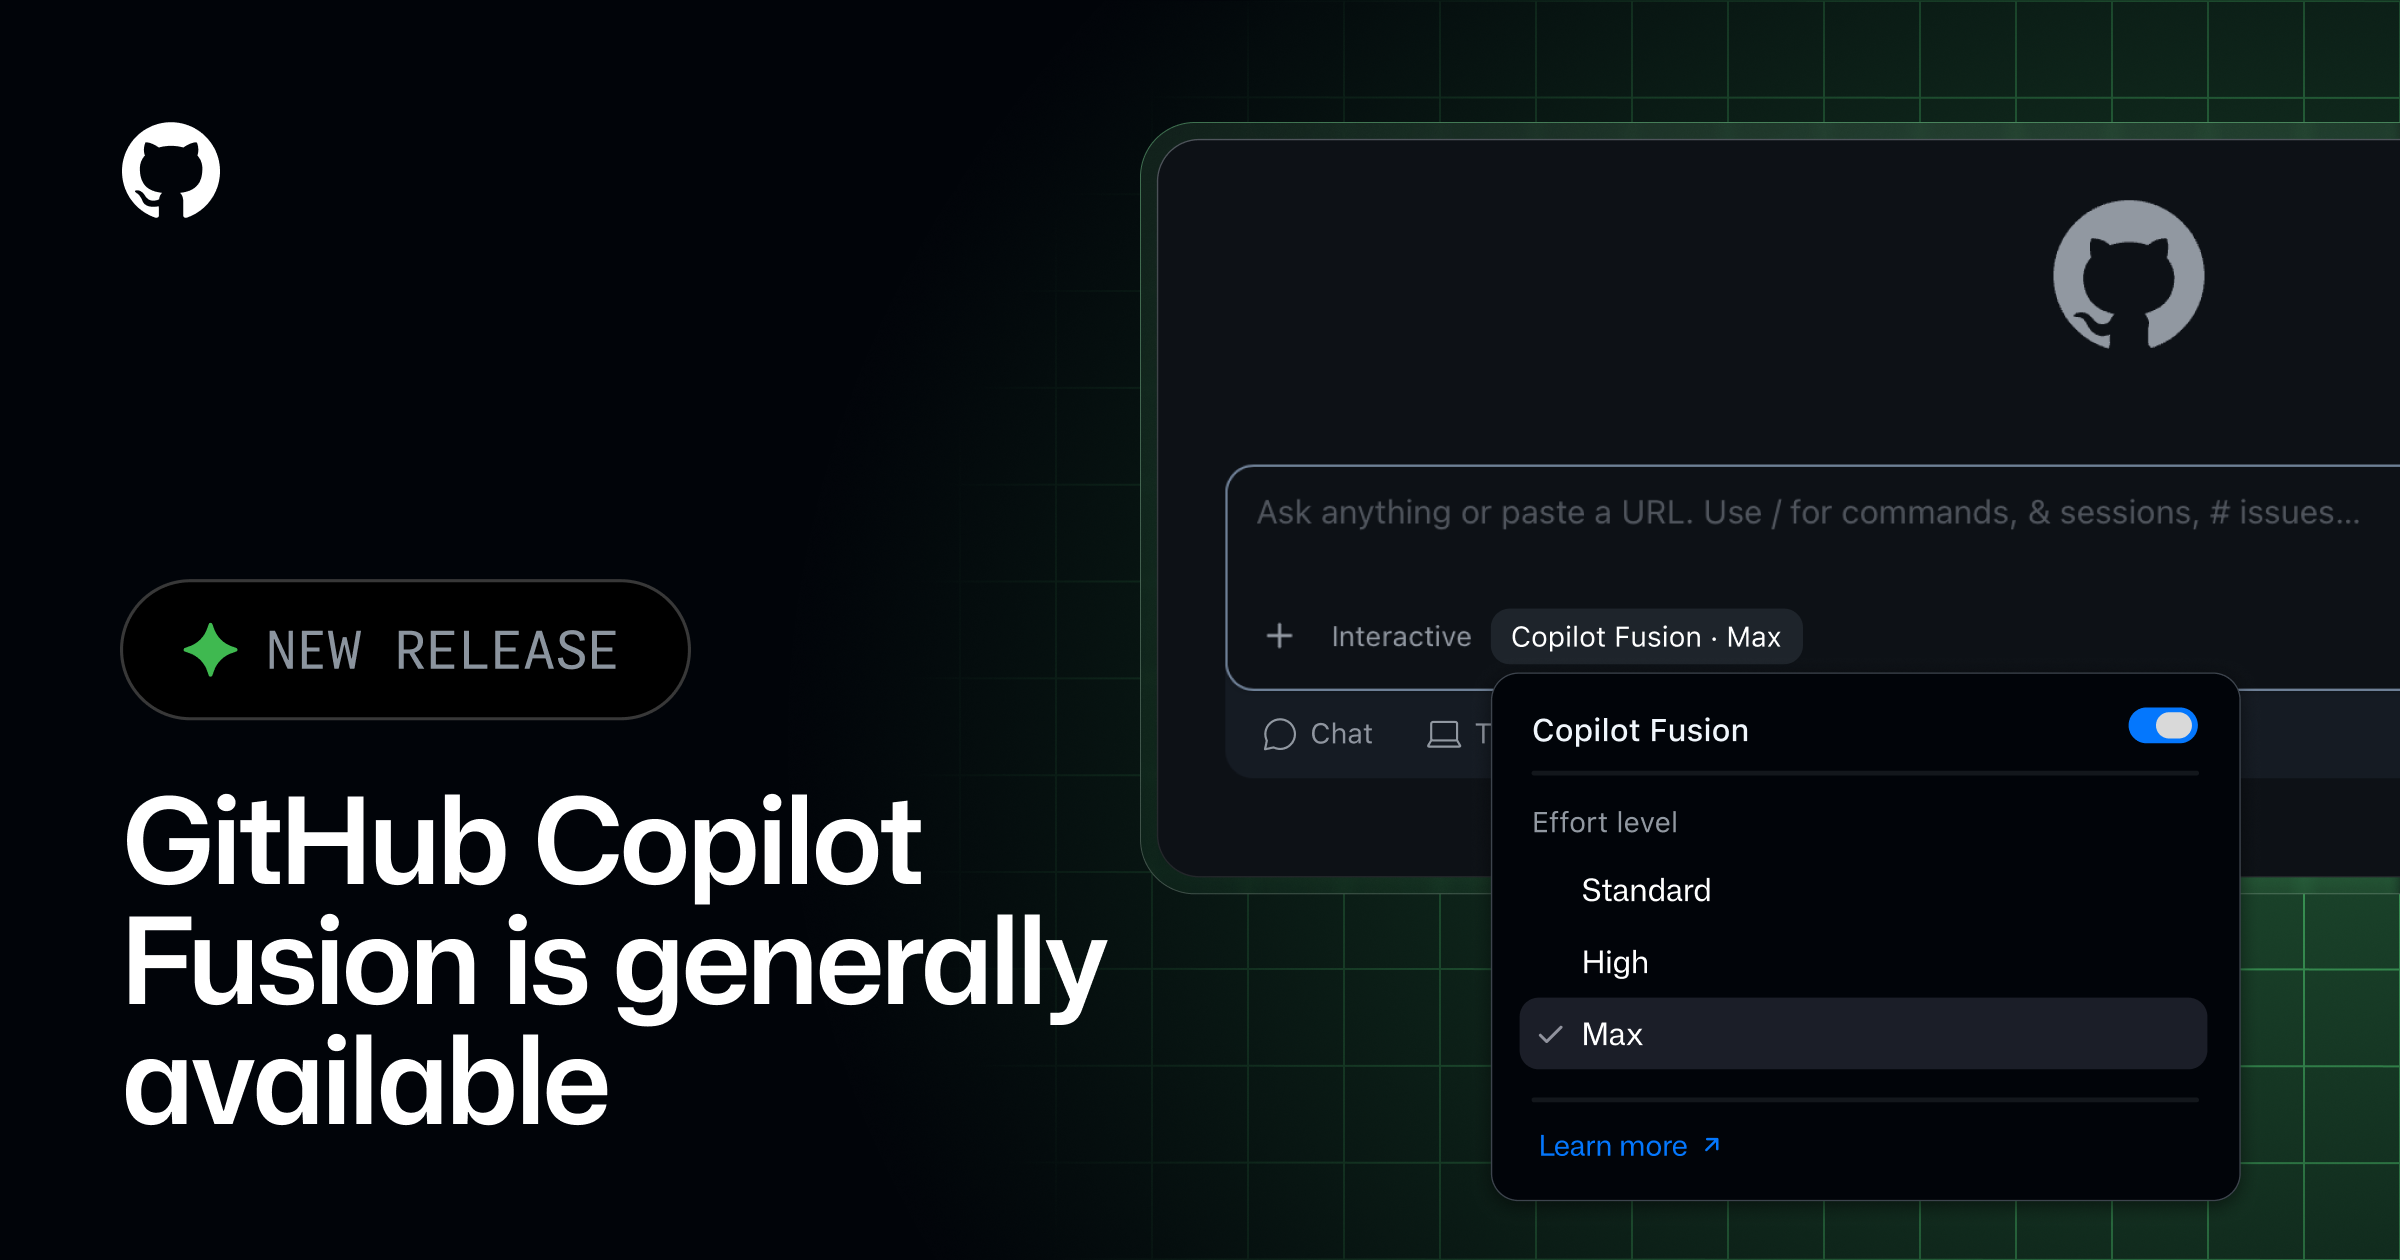
GitHub Universe 2026:Copilot Fusion 正式 GA,自动路由与编排多模型,Fusion Max 在 Artificial Analysis 编码智能体指数拿 60 分,成本约为 Claude Code + Opus 5.5 Max 的一半

GitHub 10 月 28 日在 Universe 2026 宣布 Copilot Fusion 正式可用(GA)。它把此前研究预览的 Project HydraFusion 多模型编排和 Copilot auto 模型选择合并:用户在模型选择器里选 Copilot Fusion 和努力档位(Standard / High / Max),由系统按任务决定用哪些模型、走 Single、Cascade 还是 Critique 流程。官方称 Fusion Max 在 Artificial Analysis 编码智能体指数得 60 分,比 Claude Code + Opus 5.5 Max 低 2 分,但每任务 API 成本约一半、token 约一半、耗时少约 40%。按所用模型标准价计费,付费用户到 11 月 30 日享 30% 折扣。

GitHub Universe 2026:Copilot Fusion 正式 GA,自动路由与编排多模型,Fusion Max 在 Artificial Analysis 编码智能体指数拿 60 分,成本约为 Claude Code + Opus 5.5 Max 的一半

核心要点速览

  • 跑分(Artificial Analysis 编码智能体指数 v2.0):Fusion Max 60 分,Claude Code + Opus 5.5 Max 62 分;每任务成本 5.59 美元对 11.42 美元,Devin Fusion 组合 62 分、8.00 美元
  • 分项:Terminal-Bench 4.0 得 71 分略领先;FrontierCode 51 分排第三(Claude Code 56、Devin Fusion 54);SWE-Atlas-QnA-AA 57 分偏弱
  • 效率:每任务约 720 万 token,约为 Claude Code + Opus 5.5 的一半,比 Devin Fusion 少 30%;GitHub 称耗时少约 40%
  • 模型池含 Claude Opus 5.5、Claude Sonnet 5.5、GPT-6 Astra、GPT-6 Sol 等;管理员可单独禁用某模型供 Fusion 使用,并把 Fusion 设为默认
  • 可用范围:所有 Copilot 套餐,VS Code、Copilot app、Copilot CLI 和 JetBrains;原 auto / HydraFusion / HydraFusion Max 设置自动迁移到对应档位
阅读全文
AD赞助内容

Baseten 开源两款决策模型 mammoth-1(27B)与 elephant-1(9B):不生成文本直接输出选项概率,Jev 决策榜第一

10 月 21 日,Baseten 旗下研究团队 Base Labs 发布开源决策模型 mammoth-1(27B)与 elephant-1(9B),基于 Qwen3.5 全量微调,不生成文本,一次前向传播即返回每个选项的概率,适合分流、分类、打分和路由。官方口径下 mammoth-1 以 71.24 分登顶 Jev Decision Index 0.4,elephant-1 在 Artificial Analysis Decision Index 上并列第一。权重已上 Hugging Face,Baseten API 免费开放至 10 月 27 日。

Baseten 开源两款决策模型 mammoth-1(27B)与 elephant-1(9B):不生成文本直接输出选项概率,Jev 决策榜第一

核心要点速览

  • 跑分(官方口径):mammoth-1 在 Jev Decision Index 0.4 得 71.24 分,208 个决策模型中排名第一;AA Decision Index 65.9
  • elephant-1(9B):Jev 62.6 分、9B 级第一;AA Decision Index 65.2,与 d1-ultra 并列第一
  • 训练:基于 Qwen3.5-27B / 9B 全量微调,621 万条决策样本,含弃答与安全数据
  • 机制:块状双向注意力 + 共享前缀缓存,一次前向返回多问题概率;官方称比推理模型最高快约 10 倍
  • 上手:Hugging Face 权重(MIT),Baseten API 免费至 10/27 23:59 PT,默认零数据保留
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Mammoth 1⚡ Elephant 1⚡ Qwen3.5-27B⚡ Qwen3.5-9B🌐 Baseten🌐 Base Labs

llm-d 1.0 发布:Red Hat、IBM、Google 主导的 Kubernetes 原生开源分布式推理栈进入生产可用,按厂商口径自托管 3,000 个编码 Agent 比商用 API 便宜 5–10 倍

10 月 20 日 PyTorch Conference 北美站上,CNCF 沙箱项目 llm-d 发布 1.0。它把 vLLM、SGLang 等推理引擎组织成一个统一的服务池,1.0 新增多租户优先级与公平调度(flow control)、路由高可用与零停机滚动升级(DisaggregatedSet)、v1 配置 API,以及面向 Agent 的会话感知路由和 Responses API 状态支持。项目由 Red Hat、IBM、Google Cloud、CoreWeave、NVIDIA 于 2025 年创立,现有 500 多名贡献者;JetBrains、DigitalOcean、Mistral 等已在生产中使用。

llm-d 1.0 发布:Red Hat、IBM、Google 主导的 Kubernetes 原生开源分布式推理栈进入生产可用,按厂商口径自托管 3,000 个编码 Agent 比商用 API 便宜 5–10 倍

核心要点速览

  • 规模(Red Hat 新闻稿,厂商口径):在 NVIDIA GPU 上部署约 7,530 亿参数的 GLM 5.2,峰值每分钟输出 660 万 token,同时服务最多 3,000 个编码 Agent 且零抢占,按云租用价算每 token 成本比同等商用 API 低 5–10 倍
  • 缓存复用:IBM 称在 Agent 编码负载中前缀感知路由拿到了 97% 的可复用缓存;IBM Research 量子纠错芯片项目前缀命中约 98%、综合成本约每百万 token 0.11 美元,比全闭源方案低 11.5 倍
  • Google Cloud 口径:Ironwood TPU 上的 Agent 编码负载,前缀感知路由加主机内存卸载让首 token 延迟中位数下降超 85%、吞吐提升 2.4 倍;Gemini 平台前缀缓存命中率从 35% 提到 70%
  • 1.0 新能力:flow control 多租户 QoS、路由热备高可用、DisaggregatedSet 统一管理 prefill/decode 滚动升级、v1 配置 API、Responses API 支持 previous_response_id
  • 生态:500+ 贡献者、25+ 家机构;JetBrains 的免费 Junie Lite、DigitalOcean Serverless Inference、Mistral 商用分级流量已在生产中使用;GitHub v1.0.0 发布说明坦言部分既定目标未完成
阅读全文

苏黎世联邦理工与港大破解 MoE 路由探索困境 MirrorMoE:自适应专家剪枝化解共享专家抑制效应,全尺度 PPL 显著下降

现代混合专家(MoE)普遍结合“细粒度专家切分”与“共享专家”设计,但二者在底层产生致命冲突:共享专家均质化了 Token 表征,抑制了路由探索,导致组合膨胀的专家空间无法被充分利用。苏黎世联邦理工学院(ETH Zurich)与香港大学团队发表 MirrorMoE(arXiv:2610.22353,GitHub: BingcongLi/MirrorMoE),通过 Token 自适应抑制冗余专家收缩探索空间,在从 100M 到 2.4B 全尺度上实现显著的 PPL 下降与下游基准全线涨点。

苏黎世联邦理工与港大破解 MoE 路由探索困境 MirrorMoE:自适应专家剪枝化解共享专家抑制效应,全尺度 PPL 显著下降

核心要点速览

  • 苏黎世联邦理工学院与香港大学团队发表 MirrorMoE(arXiv:2610.22353),揭示现代 MoE 中共享专家导致表征均质化、抑制细粒度路由探索的根本困境
  • 提出 Token 自适应专家抑制算法,在保持零额外计算与训练时间开销的前提下动态收缩探索空间
  • 在 100M 至 2.4B 参数全尺度上全面降低预训练困惑度(2.4B 模型 PPL 从 21.17 降至 20.50)
  • 在六大下游基准平均得分提升 1.64 个百分点,其中 BoolQ 准确率大幅提升 4.03 个百分点(58.53% vs 54.50%)
阅读全文
关联模型 / 智能体 / 厂商:

规则世界建模三大突破:OmniVerifier-C1 解耦分级验证器赋能迷宫/数独生成,美团 WorldCast 揭露开源仅 20.1 分代差,国大 RPO 扩散 RL 提速 4 倍

针对多模态生成模型向“严守物理与逻辑规则的世界模型”演进中的验证、评测与强化学习对齐难题,今日三项重磅研究给出系统答案:OmniVerifier-C1(arXiv:2610.22355,HF 32 赞)通过解耦强化学习(DAPO)将提示词拆解为子问题二元判断与全局连续打分,在 ViVerBench 上提至 0.684 并将 FLUX.1-dev 的 GenEval 推至 0.79;美团开源 320 例多步世界状态预测基准 WorldCast(arXiv:2610.20731,HF 30 赞),揭示 GPT-Image-2.5 System 达 72.8 分而最强开源模型仅 20.1 分;新加坡国立大学提出路由策略优化 RPO(arXiv:2610.22282),将注意力块路由作为随机探索动作,以仅 24.1 GPU 小时(较 Flow-GRPO 与 DanceGRPO 分别快 3.1 倍和 4.2 倍)大幅提升视频生成语义对齐。

规则世界建模三大突破:OmniVerifier-C1 解耦分级验证器赋能迷宫/数独生成,美团 WorldCast 揭露开源仅 20.1 分代差,国大 RPO 扩散 RL 提速 4 倍

核心要点速览

  • OmniVerifier-C1 采用解耦强化学习(DAPO)联合优化子问题二元判断与全局连续打分,在 ViVerBench 达 0.684 并将 FLUX.1-dev 的 GenEval 总分从 0.68 拉升至 0.79
  • 美团开源 320 例多步世界状态预测基准 WorldCast:评测 12 款模型发现 GPT-Image-2.5 System 斩获 72.8 分,Nano Banana Pro 为 42.8 分,而最强开源模型仅得 20.1 分
  • 新加坡国大提出路由策略优化(RPO):在注意力块路由内部进行双轨迹随机探索且推理期零改动恢复稠密注意力,在 Wan2.2-TI2V-5B 上仅需 24.1 GPU 小时(较 Flow-GRPO 与 DanceGRPO 分别快 3.1 倍和 4.2 倍)
阅读全文
关联模型 / 智能体 / 厂商:

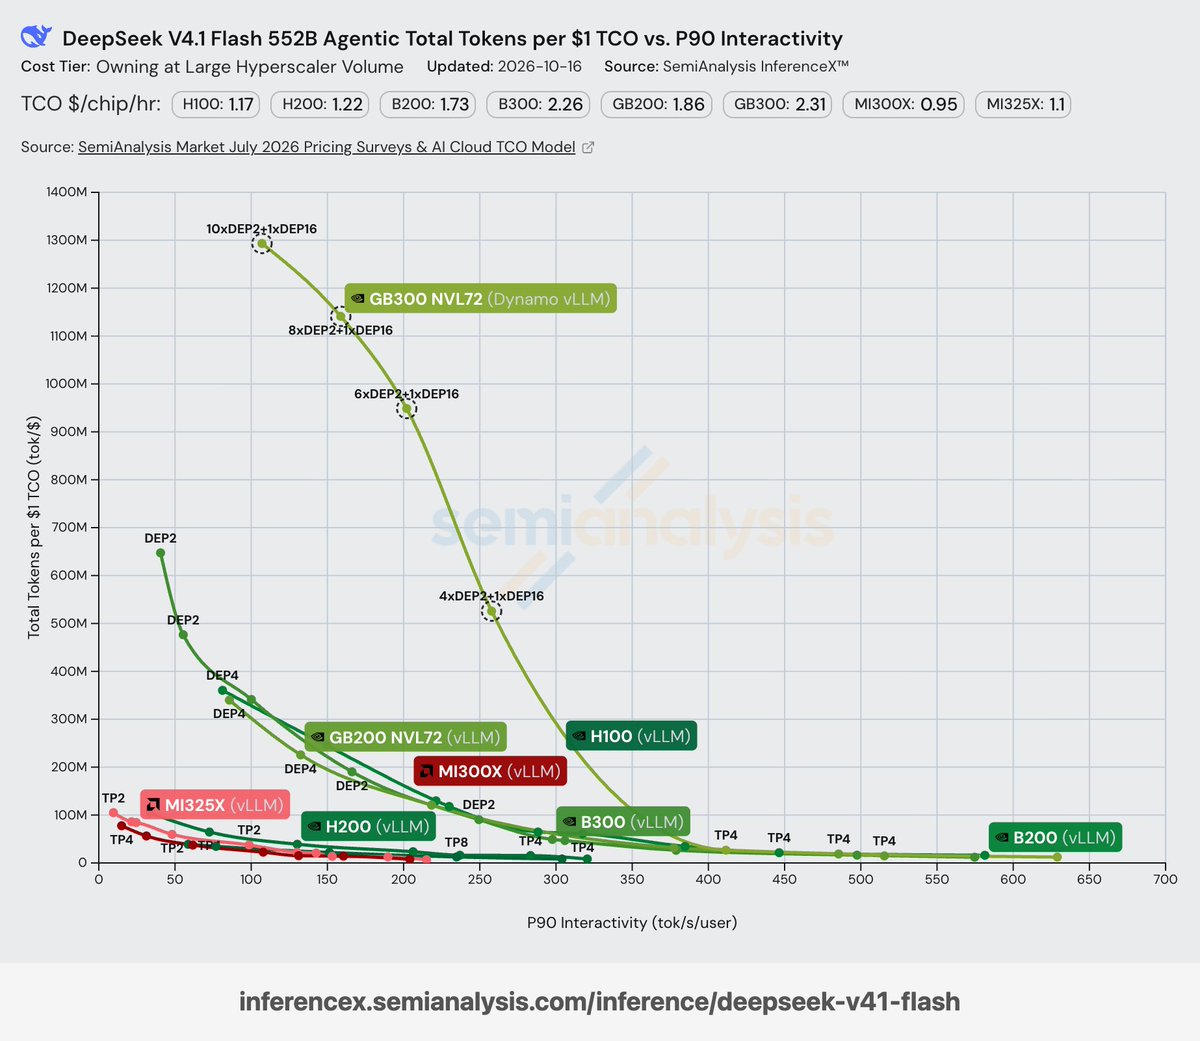
vLLM 与 OpenRouter 同步上线 DeepSeek-V4.1-Flash-1017 Day-0 极速推理:AgentX 单卡吞吐飙至 830K tok/s,每美元狂吞 13 亿 Token

紧随 DeepSeek-V4.1-Flash-1017 开源发布,vLLM 官宣 Day-0 深度适配,在 SemiAnalysis AgentX 评测中创下每美元 TCO 产出 13 亿 Token、单 GPU 吞吐高达 830K tok/s(保障单用户 100 tok/s 交互速率)的纪录,较初代提速 5 倍;OpenRouter 亦同步上线,第三方供应商最低仅需 $0.10/M 输入与 $0.50/M 输出。

vLLM 与 OpenRouter 同步上线 DeepSeek-V4.1-Flash-1017 Day-0 极速推理:AgentX 单卡吞吐飙至 830K tok/s,每美元狂吞 13 亿 Token

核心要点速览

  • vLLM 在 SemiAnalysis AgentX 基准上为 DeepSeek-V4.1-Flash-1017 实现单 GPU 830K tok/s 吞吐(保障单用户 100 tok/s 速率),每美元 TCO 产出高达 13 亿 Token,较初代提速 5 倍
  • 模型在 DeepSWE v1.1 上斩获 77.0%(超越 Claude Opus 5 的 74.0%),NL2Repo-Bench 达 68.2%,Apex Bench 达 72.1%,且输出更加精炼
  • OpenRouter 同步上线 deepseek/deepseek-v4.1-flash-1017,最低仅 $0.10/M 输入与 $0.50/M 输出;官方 API(deepseek-flash)维持 $0.15/$0.60 不变
阅读全文
关联模型 / 智能体 / 厂商: