AI 编程实时动态与要闻

LM Studio Bionic 1.1.10 接入 oMLX 引擎:Mac 本地模型可用内存加 SSD 两级 KV 缓存,并支持 MLX 投机解码

LM Studio 于 10 月 29 日 15:32(UTC)在 X 上宣布,用户现在可以在 LM Studio 里下载新的 oMLX 引擎,直接用于已下载的 MLX 模型;官方更新日志把它列为 Bionic 1.1.10 的新功能,同版本还加入 MLX 模型投机解码和应用内终端。oMLX 是韩国开发者 jundot 维护的 Apple Silicon 开源推理服务器(Apache 2.0,GitHub 约 2.3 万星),主打连续批处理和内存加 SSD 的两级 KV 缓存。官方未公布 LM Studio 内的速度对比。

LM Studio Bionic 1.1.10 接入 oMLX 引擎:Mac 本地模型可用内存加 SSD 两级 KV 缓存,并支持 MLX 投机解码

核心要点速览

  • LM Studio 官方宣布可在应用内下载 oMLX 引擎,直接使用已有 MLX 模型,原帖约 540 赞(原帖)
  • Bionic 1.1.10 更新日志(10 月 29 日)同时列出 MLX 投机解码、应用内终端公开可用和 llama.cpp 2.66.0 扩展包(更新日志)
  • oMLX 为 Apache 2.0 开源项目,GitHub 约 23,000 星,要求 macOS 15+ 与 Apple Silicon(M1 到 M5)(GitHub)
  • oMLX 的核心是两级 KV 缓存:热块放内存,溢出块以 safetensors 格式写入 SSD,前缀相同的请求甚至重启后也可从磁盘恢复
  • LM Studio 未公布该引擎与原 MLX 引擎的速度对比;发布后已有用户反馈「重启以应用更新」失败,官方正在排查
阅读全文

vLLM 官方实测追平 DeepInfer:GB200 上吞吐差距缩小至 6%,GB300 单卡达百万 Token/秒

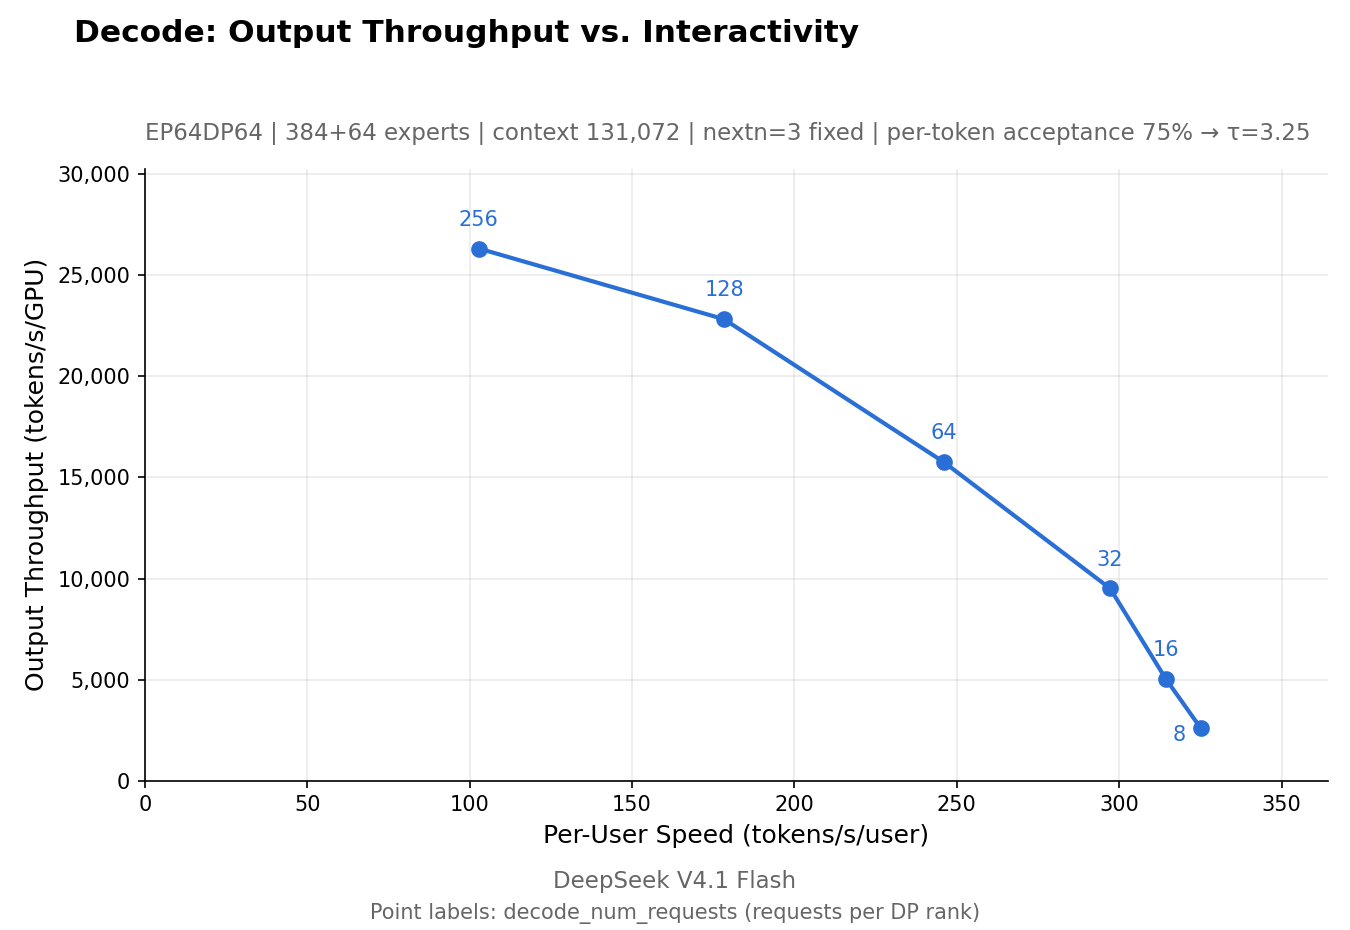
在 DeepSeek 宣布开源其生产级推理引擎 DeepInfer 数小时后,vLLM 官方项目团队正式公布了针对 DeepSeek-V4.1-Flash 的实测重磅性能对标数据。采用 DeepSeek 官方完全相同的测试拓扑(131K 超长上下文、nextn=3 投机采样),vLLM 在 NVIDIA GB200 NVL 架构上针对 Batch Size 8~256 的全并发区间,将与 DeepInfer 的端到端吞吐差距压缩至 6% 以内;在下一代 GB300 架构上,单 GPU 吞吐量突破 1,000,000 Token/秒,单用户峰值输出达 826 Token/秒,折合单 GPU 每小时营收达 38.96 美元。同时宣布 FastH3-Omni 与 Spark-X2.6-4B 首发支持。

vLLM 官方实测追平 DeepInfer:GB200 上吞吐差距缩小至 6%,GB300 单卡达百万 Token/秒

核心要点速览

  • vLLM 团队迅速公布实测对标数据,在 NVIDIA GB200 上运行 DeepSeek-V4.1-Flash 吞吐已追平至仅落后 DeepInfer 6%
  • 在下一代 NVIDIA GB300 硬件架构上,vLLM 实现单张 GPU 吞吐达 100 万 Token/秒,单用户峰值输出 826 Token/秒
  • 按 DeepSeek 线上非高峰期官方定价测算,单台 GPU 每小时可产生高达 38.96 美元的云端推理收益,经济效益惊人
  • 同步宣布对多模态视频大模型 FastH3-Omni 与拥有 100 万上下文的 4B 模型 Spark-X2.6-4B(Apache 2.0)提供 Day-0 首日原生支持
阅读全文
关联模型 / 智能体 / 厂商:

DeepSeek 正式开源 DeepInfer 推理引擎:全面支撑 V4.1-Flash 大规模生产服务,兼顾 NVIDIA SM100 与华为昇腾 950

DeepSeek 官方正式开源其生产级高性能推理引擎 DeepInfer(基于 Apache 2.0 协议发布)。DeepInfer 汲取了 vLLM、SGLang 与 TensorRT-LLM 架构精华,专为大规模部署 DeepSeek-V4.1-Flash 设计。引擎支持 NVIDIA SM100 架构与华为昇腾 Ascend 950 NPU,原生集成 FlashMLA、DeepGEMM、DeepEP 与 TileKernels。引入 DSpark 置信度投机采样(默认 5 个 Draft Token)、SWA 有界重放(140 Token 窗口)与 MoE 专家并行动态负载均衡。同时开源生产级分词与编解码组件 deepseek-recipe,构建从模型、算子到推理服务的全栈开源生态。

DeepSeek 正式开源 DeepInfer 推理引擎:全面支撑 V4.1-Flash 大规模生产服务,兼顾 NVIDIA SM100 与华为昇腾 950

核心要点速览

  • DeepSeek 官方正式开源 DeepInfer 推理引擎(Apache 2.0),完整公开支撑 DeepSeek-V4.1-Flash 线上高吞吐与低延迟调度的底层代码
  • 跨异构硬件深度调优,同时全面适配 NVIDIA SM100 GPU 与华为昇腾 Ascend 950 NPU,提供硬件级确定性输出保证
  • 深度融合 FlashMLA、DeepGEMM、DeepEP 与 TileKernels 原生算子,并搭载基于 DSpark 的 5-Token 置信度投机解码与 140-Token 滑动窗口重放
  • 同步开源生产级 token 编解码套件 deepseek-recipe,彻底消除开源社区本地部署与官方 API 之间的对齐鸿沟
阅读全文

DeepSeek 开源生产推理框架 DeepInfer:支撑 V4.1-Flash 线上服务,含投机解码、批次不变推理与结构化输出,同步开源 deepseek-recipe

DeepSeek 于 10 月 20 日(UTC)开源内部推理框架 DeepInfer(Apache 2.0),即支撑 DeepSeek-V4.1-Flash 大规模线上服务的推理栈。本次开源版本提供离线推理,支持 Attention DP/CP、MoE EP+EPLB 并行、DSpark 投机解码、SWA bounded replay、批次不变推理、确定性采样和结构化输出,硬件为 NVIDIA SM100 与华为昇腾 950。KV cache 系统、PD 分离和负载均衡未包含在内。同时开源的 deepseek-recipe(MIT)负责把 Chat Completions、Messages、Responses 等格式请求统一转换并编码,对齐官方 API 行为。

DeepSeek 开源生产推理框架 DeepInfer:支撑 V4.1-Flash 线上服务,含投机解码、批次不变推理与结构化输出,同步开源 deepseek-recipe

核心要点速览

  • DeepInfer 以 Apache 2.0 开源,官方称即支撑 DeepSeek-V4.1-Flash 线上服务的推理框架,目前只支持这一个模型
  • 硬件仅支持 NVIDIA SM100(Blackwell)GPU 和华为昇腾 950 NPU;官方性能曲线测于 4 卡 prefill、64 卡 decode
  • 开源版缺 KV cache 系统、VE/Prefill/Decode 分离和多副本负载均衡三块,离完整线上服务还有距离
  • 官方给出的 V4.1 参考成绩(Pass@1,厂商口径):AIME 2026 99.9%、GPQA Diamond 93.4%、HLE-Full 42.6%,用于校验部署是否配置正确
  • 同步开源 deepseek-recipe(MIT,Rust+Python 绑定),统一处理 Chat Completions/Messages/Responses 请求转换与 token 编解码
阅读全文
关联模型 / 智能体 / 厂商:
⚡ DeepSeek-V4.1-Flash-1017🌐 DeepSeek🌐 NVIDIA🌐 Huawei
AD赞助内容

香港大学提出混合线性注意力投机解码 ReaDy:复用循环状态作为动态上下文,B200 解码吞吐达 302 TPS

传统投机解码(Speculative Decoding)依赖目标模型的静态隐层特征,无法适应草稿模型随位置变化的动态上下文需求。香港大学团队发表 ReaDy(arXiv:2610.20503,HF 6 赞)。该框架首次为混合线性注意力模型(Hybrid Linear Attention,结合 Transformer 与 Mamba/RWKV 循环层)设计了以紧凑循环隐状态为动态上下文的投机草稿机制。在 NVIDIA B200 单卡上对 Qwen3.8-27B 展开评测,投机接受长度达 4.53,单卡解码吞吐飙升至 302.78 TPS,较标准自回归提速 2.4 倍。

香港大学提出混合线性注意力投机解码 ReaDy:复用循环状态作为动态上下文,B200 解码吞吐达 302 TPS

核心要点速览

  • 香港大学提出首个专为混合线性注意力(HLA)架构打造的投机解码方法 ReaDy(arXiv:2610.20503)
  • 创新性地复用 HLA 骨干中的紧凑循环隐状态作为动态上下文,解决传统草稿模型特征静态僵化的问题
  • 在单张 NVIDIA B200 上对 Qwen3.8-27B 展开实测,解码吞吐达到 302.78 TPS,较标准自回归提速 2.4 倍,在 DSpark 基础上再提升 7.97%
  • 仅需 Rank 8 超轻量读取器即可达成最佳性能,投机接受长度达到 4.53 个 Token
阅读全文
关联模型 / 智能体 / 厂商:

2.8 万亿参数 Kimi K3 单请求飙至 842 tok/s!NVIDIA 联合 vLLM 开源 1.2 万行 CuTe DSL 巨型融合内核,GB300 NVL72 交互吞吐暴涨 1.8 倍

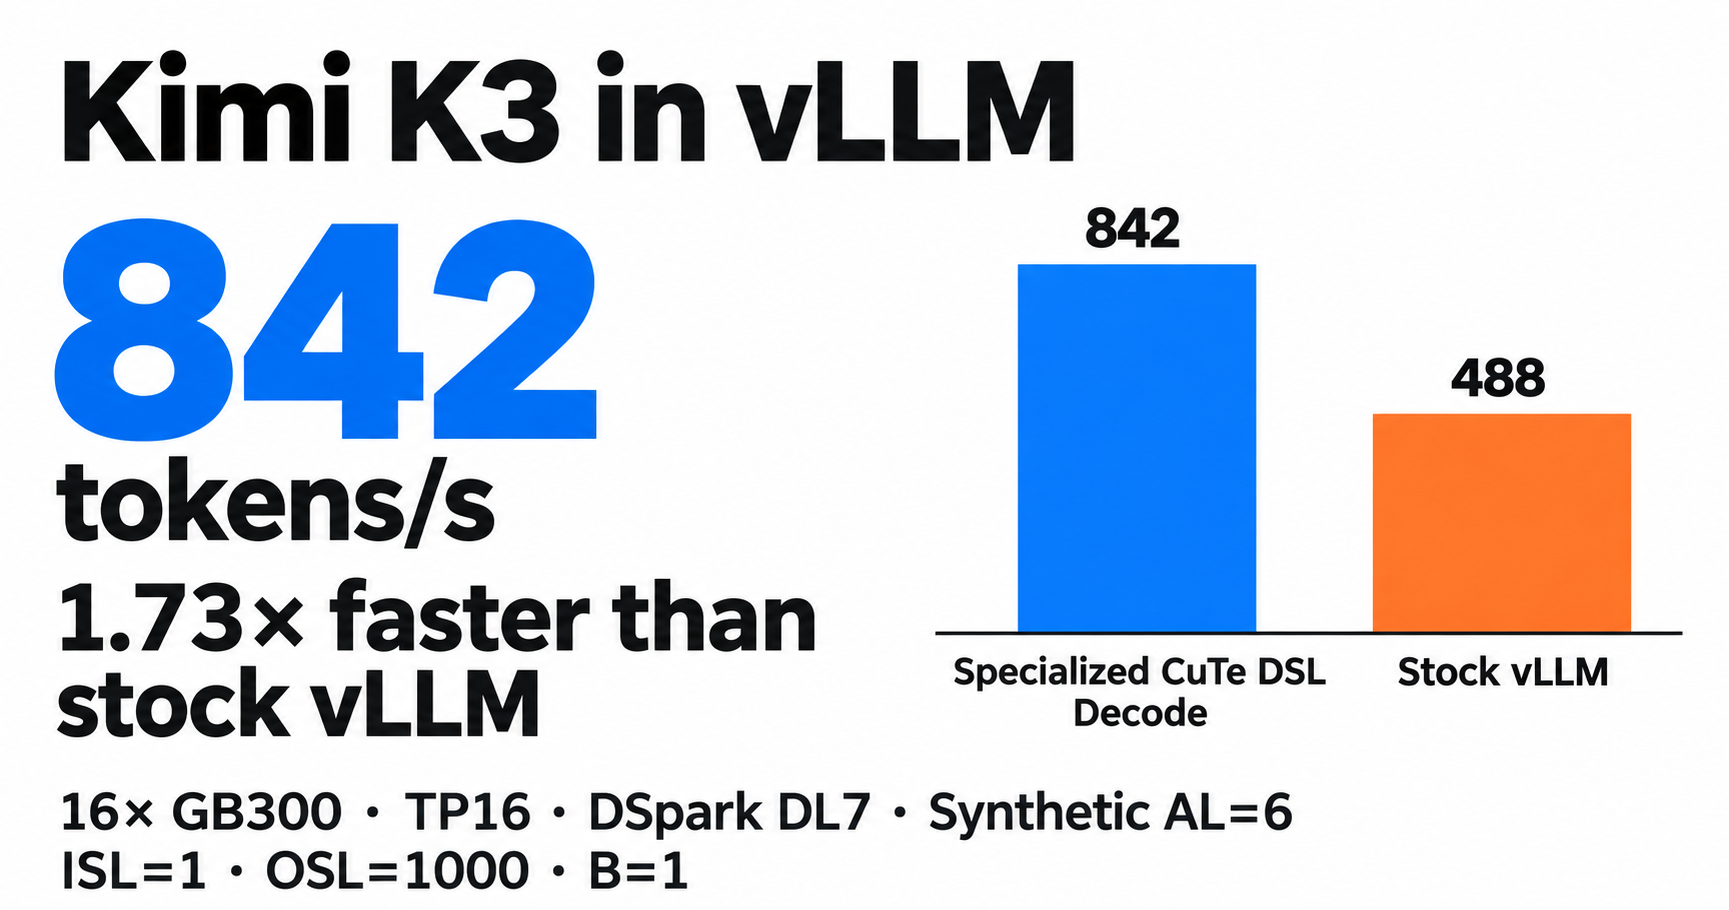
vLLM 联合 NVIDIA 正式发布面向月之暗面旗舰模型 Kimi K3(SemiAnalysis 披露达 2.8 万亿参数)的底层解码巨型内核(Megakernel):由 NVIDIA CentML 工程师采用 CuTe DSL 编写的 1.2 万行代码将注意力、MoE 路由与跨卡通信深度融合,将单层内核启动数从 23 个砍至 13 个、单层耗时从 130 µs 压至 69 µs。在 16 卡 NVIDIA GB300 NVL72 上配合 DSpark 投机解码实现 Batch=1 高达 842 tok/s 的极速输出(提速 1.73 倍),并在 SemiAnalysis AgentX 负载上实现最高 1.8 倍的 P90 单用户交互吞吐提升(突破 403.2~423 tok/s/user),下一步将适配 DeepSeek-V4.1-Flash 与 GLM-5.3。

2.8 万亿参数 Kimi K3 单请求飙至 842 tok/s!NVIDIA 联合 vLLM 开源 1.2 万行 CuTe DSL 巨型融合内核,GB300 NVL72 交互吞吐暴涨 1.8 倍

核心要点速览

  • NVIDIA CentML 联合 vLLM 为 2.8 万亿参数 Kimi K3 打造 1.2 万行 CuTe DSL 解码巨型内核,将单层内核数从 23 个减至 13 个、单层耗时从 130 µs 压至 69 µs
  • 在 16 卡 NVIDIA GB300 NVL72 上配合 DSpark 投机解码实现 Batch=1 高达 842 tok/s 输出(提速 1.73 倍),无投机 Batch=1 达 256.4 tok/s(提速 1.88 倍)
  • 在 SemiAnalysis AgentX 基准上将 P90 单用户交互吞吐提升至最高 403.2~423 tok/s/user(最高 1.8 倍提升),DeepSeek-V4.1-Flash(PR #61868)与 GLM-5.3 支持即将合入
阅读全文
关联模型 / 智能体 / 厂商:

vLLM 联手 NVIDIA 为 Kimi K3 定制 GB300 解码路径:batch 1 达 842 tok/s,无投机解码提速 1.3–1.9 倍

vLLM 官方博客(作者 NVIDIA 的 Benjamin Chislett)披露:借助编码 Agent 辅助开发,团队为 Kimi K3 在 NVIDIA GB300 上重写了一条 CuTe DSL 统一解码路径,把注意力、MoE 与 NVLink 通信融合,单层耗时从 130 微秒/23 个 kernel 降到 69 微秒/13 个。16 卡配合 DSpark 投机解码在 batch 1 达到 842 tok/s,是原版 vLLM 的 1.73 倍;相关 PR #61867 已于 10 月 16 日合入。

vLLM 联手 NVIDIA 为 Kimi K3 定制 GB300 解码路径:batch 1 达 842 tok/s,无投机解码提速 1.3–1.9 倍

核心要点速览

  • 16 卡 GB300 + DSpark(7 个草稿 token、合成接受长度 6)batch 1 解码 842 tok/s,原版 vLLM 为 488,提速 1.73 倍(官方口径)
  • 无投机解码时 TP16 提速 1.62–1.92 倍(batch 64 达 3,606 tok/s),TP8 提速 1.31–1.58 倍
  • 单层 kernel 从 23 个减到 13 个,耗时 130 微秒降至 69 微秒
  • AgentX 编码 Agent 负载下 P90 交互速度 403.2 对 223.7 tok/s/用户(1.8 倍),但对比基线为此前 8 卡结果
  • 同一套「快速通道」方法已扩展到 DeepSeek-V4.1-Flash(PR #61868 待合入),Muse Spark Open 早期结果超 950 tok/s/用户
阅读全文

NVIDIA 开源 Nemotron 3.5 Super VL:120B-A12B 多模态智能体模型、1M 上下文;同步放出 2-bit 24GB 本地版 Bolt 74B-A9B

NVIDIA 于 2026-10-15 发布开源多模态智能体模型 Nemotron 3.5 Super VL:120B 总参、每 token 激活 12B,Mamba-2/Transformer 混合 MoE + C-RADIO 视觉编码器,支持文本、图像、文档与视频输入,最长 1M 上下文,自带 MTP 与 LiLiCorr 投机解码。权重、数据集与训练配方以 OpenMDW-1.1 开放,已上 Hugging Face、OpenRouter、ModelScope 与 NIM。同日放出面向 RTX/DGX Spark 的 Bolt 74B-A9B 24GB(原生 2-bit 量化感知训练),4GB 的 Bolt E4B 将于 10 月 23 日跟进。

NVIDIA 开源 Nemotron 3.5 Super VL:120B-A12B 多模态智能体模型、1M 上下文;同步放出 2-bit 24GB 本地版 Bolt 74B-A9B

核心要点速览

  • 规模:Super VL 120B 总参 / 12B 激活,最长 1M 上下文;BF16 参考部署需 4×H100 或 2×GB200,另有 NVFP4 版(模型卡)
  • 编码与终端(官方口径):SWE-bench Verified 71.10、Terminal-Bench 2.1 66.70、LiveCodeBench v6 88.22;同表 Qwen3.5-122B-A10B 分别为 71.9 / 48.70 / 76.7,GLM-5.3-Flash 为 79.10 / 82.70 / 80.6
  • 智能体评测:Hermes Bench 63.44%(Nemotron 3 Ultra 56.33%),LangChain Evals 87.05%(Ultra 84.3%);NVIDIA 称单卡吞吐最高达同级开源模型 5 倍、Baseten 端点 600+ TPS(技术博客)
  • 本地版 Bolt 74B-A9B 24GB:原生 2-bit(IQ2+QAT)、256K 上下文,Terminal-Bench 2.1 50.98、BrowseComp 66.75,对照 Qwen3.6-35B-A3B 为 44.38 / 48.74;PinchBench 87.82 略低于 Qwen3.6 的 88.07(Bolt 模型卡)
  • 推理工程:LiLiCorr 投机解码在 DGX Spark 上最高提速 2.3 倍;Dynamo 方案在 16×B200、50 tok/s/用户下服务人数提升 8 倍、首 token 延迟降 85%
阅读全文
关联模型 / 智能体 / 厂商:
⚡ nemotron-3.5-super-vl⚡ nemotron-3.5-bolt-74b-a9b⚡ nemotron-3.5-bolt-e4b⚡ Nemotron 3 Ultra🤖 hermes-agent🤖 opencode🤖 OpenHands (All-Hands AI)🤖 Cline (VS Code Agent)🌐 Nvidia (NIM)
g
ggml-org@AICoder·
👀194
🔥84

llama.cpp v0.6.0 稳定版发布:正式纳入 GLM-5.3-Flash(320B)与 Qwen4Exp MTP 投机解码,新 llama_batch_ext API,Apple GPU 小批量矩阵乘最高约 3 倍

ggml-org 于 10 月 5 日发布 llama.cpp v0.6.0 稳定版(上一版 v0.5.0 为 9 月 23 日)。本版把 GLM-5.3-Flash(GLM5-Next,320B 图文混合 MoE)支持带进正式版,Qwen4Exp 加入 MTP 投机解码(DGX Spark 上解码约 1.5 倍),引入支持 token/embedding 混合批次的 llama_batch_ext 与 llama_process() 新 API,并为 Apple GPU 新增小批量 MMA 矩阵乘内核(投机/批量解码场景最高约 3 倍),ggml 升级到 v0.26.0。会话格式版本号同时升级,旧会话文件需注意兼容。

核心要点速览

  • 新模型:GLM-5.3-Flash(GLM5-Next,320B KDA/DSA 混合图文 MoE,#27773)、Clef 图文决策模型、Ling 3.0 VL、LFM2.5-Encoder
  • 提速:Qwen4Exp MTP 投机解码在 DGX Spark 上解码约 1.5 倍;Metal 小批量 MMA 矩阵乘最高约 3 倍(#29869)
  • API:新增 llama_batch_ext + llama_process(),单批次混合 token 与 embedding(#24669);server 已迁移
  • 兼容性:LLAMA_SESSION_VERSION 升至 11、LLAMA_STATE_SEQ_VERSION 升至 4,旧的会话/状态文件需重新生成
  • Server:/v1/models 返回输入输出模态;/v1/embeddings 接受图像/音频/视频类型输入;新增 /v1/systemone 决策模型接口
阅读全文
关联模型 / 智能体 / 厂商:
v
vLLMvllm-project·
👀141
🔥90

vLLM v0.31.0:717 提交上线 vllm preload 秒级重启,DeepSeek-V4.1-Flash 默认 FlashMLA,多项安全与破坏性变更

vLLM 于 10 月 5 日发布 v0.31.0(717 提交、307 位贡献者,其中 96 位新人)。新增 vllm preload 权重缓存守护进程让量化后权重跨引擎重启常驻显存,实验性 CRIU 快照可恢复已初始化引擎;DeepSeek-V4.1-Flash 在 SM100 上默认启用 FlashMLA mega attention + NVFP4 压缩 KV;Model Runner V2 支持草稿模型推测解码;安全上默认拒绝请求级多模态 kwargs,并修复 LoRA 名与 cache_salt 的前缀缓存碰撞。升级前需注意多项破坏性变更。

核心要点速览

  • 规模:717 次提交、307 位贡献者(96 位新人),见 Release 说明。
  • 秒级重启:vllm preload 让量化后权重跨重启常驻 GPU,已支持 DP、MTP 草稿模型与 /health 就绪探针;vllm snapshot create/restore 用 CRIU 恢复 TP1 引擎(实验)。
  • 安全默认收紧:请求级 mm_processor_kwargs / media_io_kwargs 默认拒绝,需显式 --trust-request-mm-kwargs;LoRA 路径纳入块哈希,防止前缀缓存串数据。
  • 破坏性变更:移除 tokenizer_mode="slow",quantization="fp8" 在线量化改为 fp8_per_tensor,--enforce-eager 还会关闭 JIT 预热。
  • 模型热路径:GLM-5.3-Flash 元数据操作快 1.6–4.8 倍、索引器省 3 GiB;KimiViT QK RoPE 融合最高 29 倍;Qwen3.8-Flash-Next 在 DGX Spark 上加载省约 25 秒。
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

编码智能体吞吐飙升 4.7 倍!KAIST 开源 AgSpec 检索推测解码:重构会话语料索引,全面超越 EAGLE-3

编码智能体在处理大型代码仓库与多轮排错时,会高频反复复述相似的代码片段、错误日志及前序修改尝试,这使得基于检索的推测解码(Retrieval-based Speculative Decoding, SD)具备巨大的加速潜力。然而,现有通用检索推测解码器在真实 Agent 流水线中严重水土不服:智能体输出格式(如带行号标注、Diff 补丁及转义代码块)与本地原始磁盘文件存在巨大表征鸿沟,且固定推测草稿长度无法自适应多智能体协作中的轮次漂移。韩国科学技术院(KAIST)团队推出了面向编码智能体定制的推测解码框架 AgSpec。该框架在会话级、工作区级与全局语料库中建立与智能体发射格式完全对齐的动态索引,并结合离线性能剖析与在线验证反馈动态调整推测草稿长度。在多智能体代码仓库级评测中,AgSpec 吞吐加速高达 4.76 倍,且在单卡低延迟场景下全面碾压 EAGLE-3。

编码智能体吞吐飙升 4.7 倍!KAIST 开源 AgSpec 检索推测解码:重构会话语料索引,全面超越 EAGLE-3

核心要点速览

  • 首创面向 Coding Agent 流水线的检索推测解码框架 AgSpec,彻底解决代码发射格式错位与草稿长度漂移痛点
  • 在长程多智能体代码仓库评测中,推理吞吐加速比在 BS=1 时达 4.37 倍,在 BS=16 时攀升至 4.76 倍
  • 在零额外模型显存占用的前提下,Token 接受率在大多数核心场景下全面击败主流模型草稿方案 EAGLE-3
阅读全文

Inferact 开源 TPU Megakernel:Kimi K3 在 16×TPU v7 上跑出 709 tok/s,低并发反超 GB200

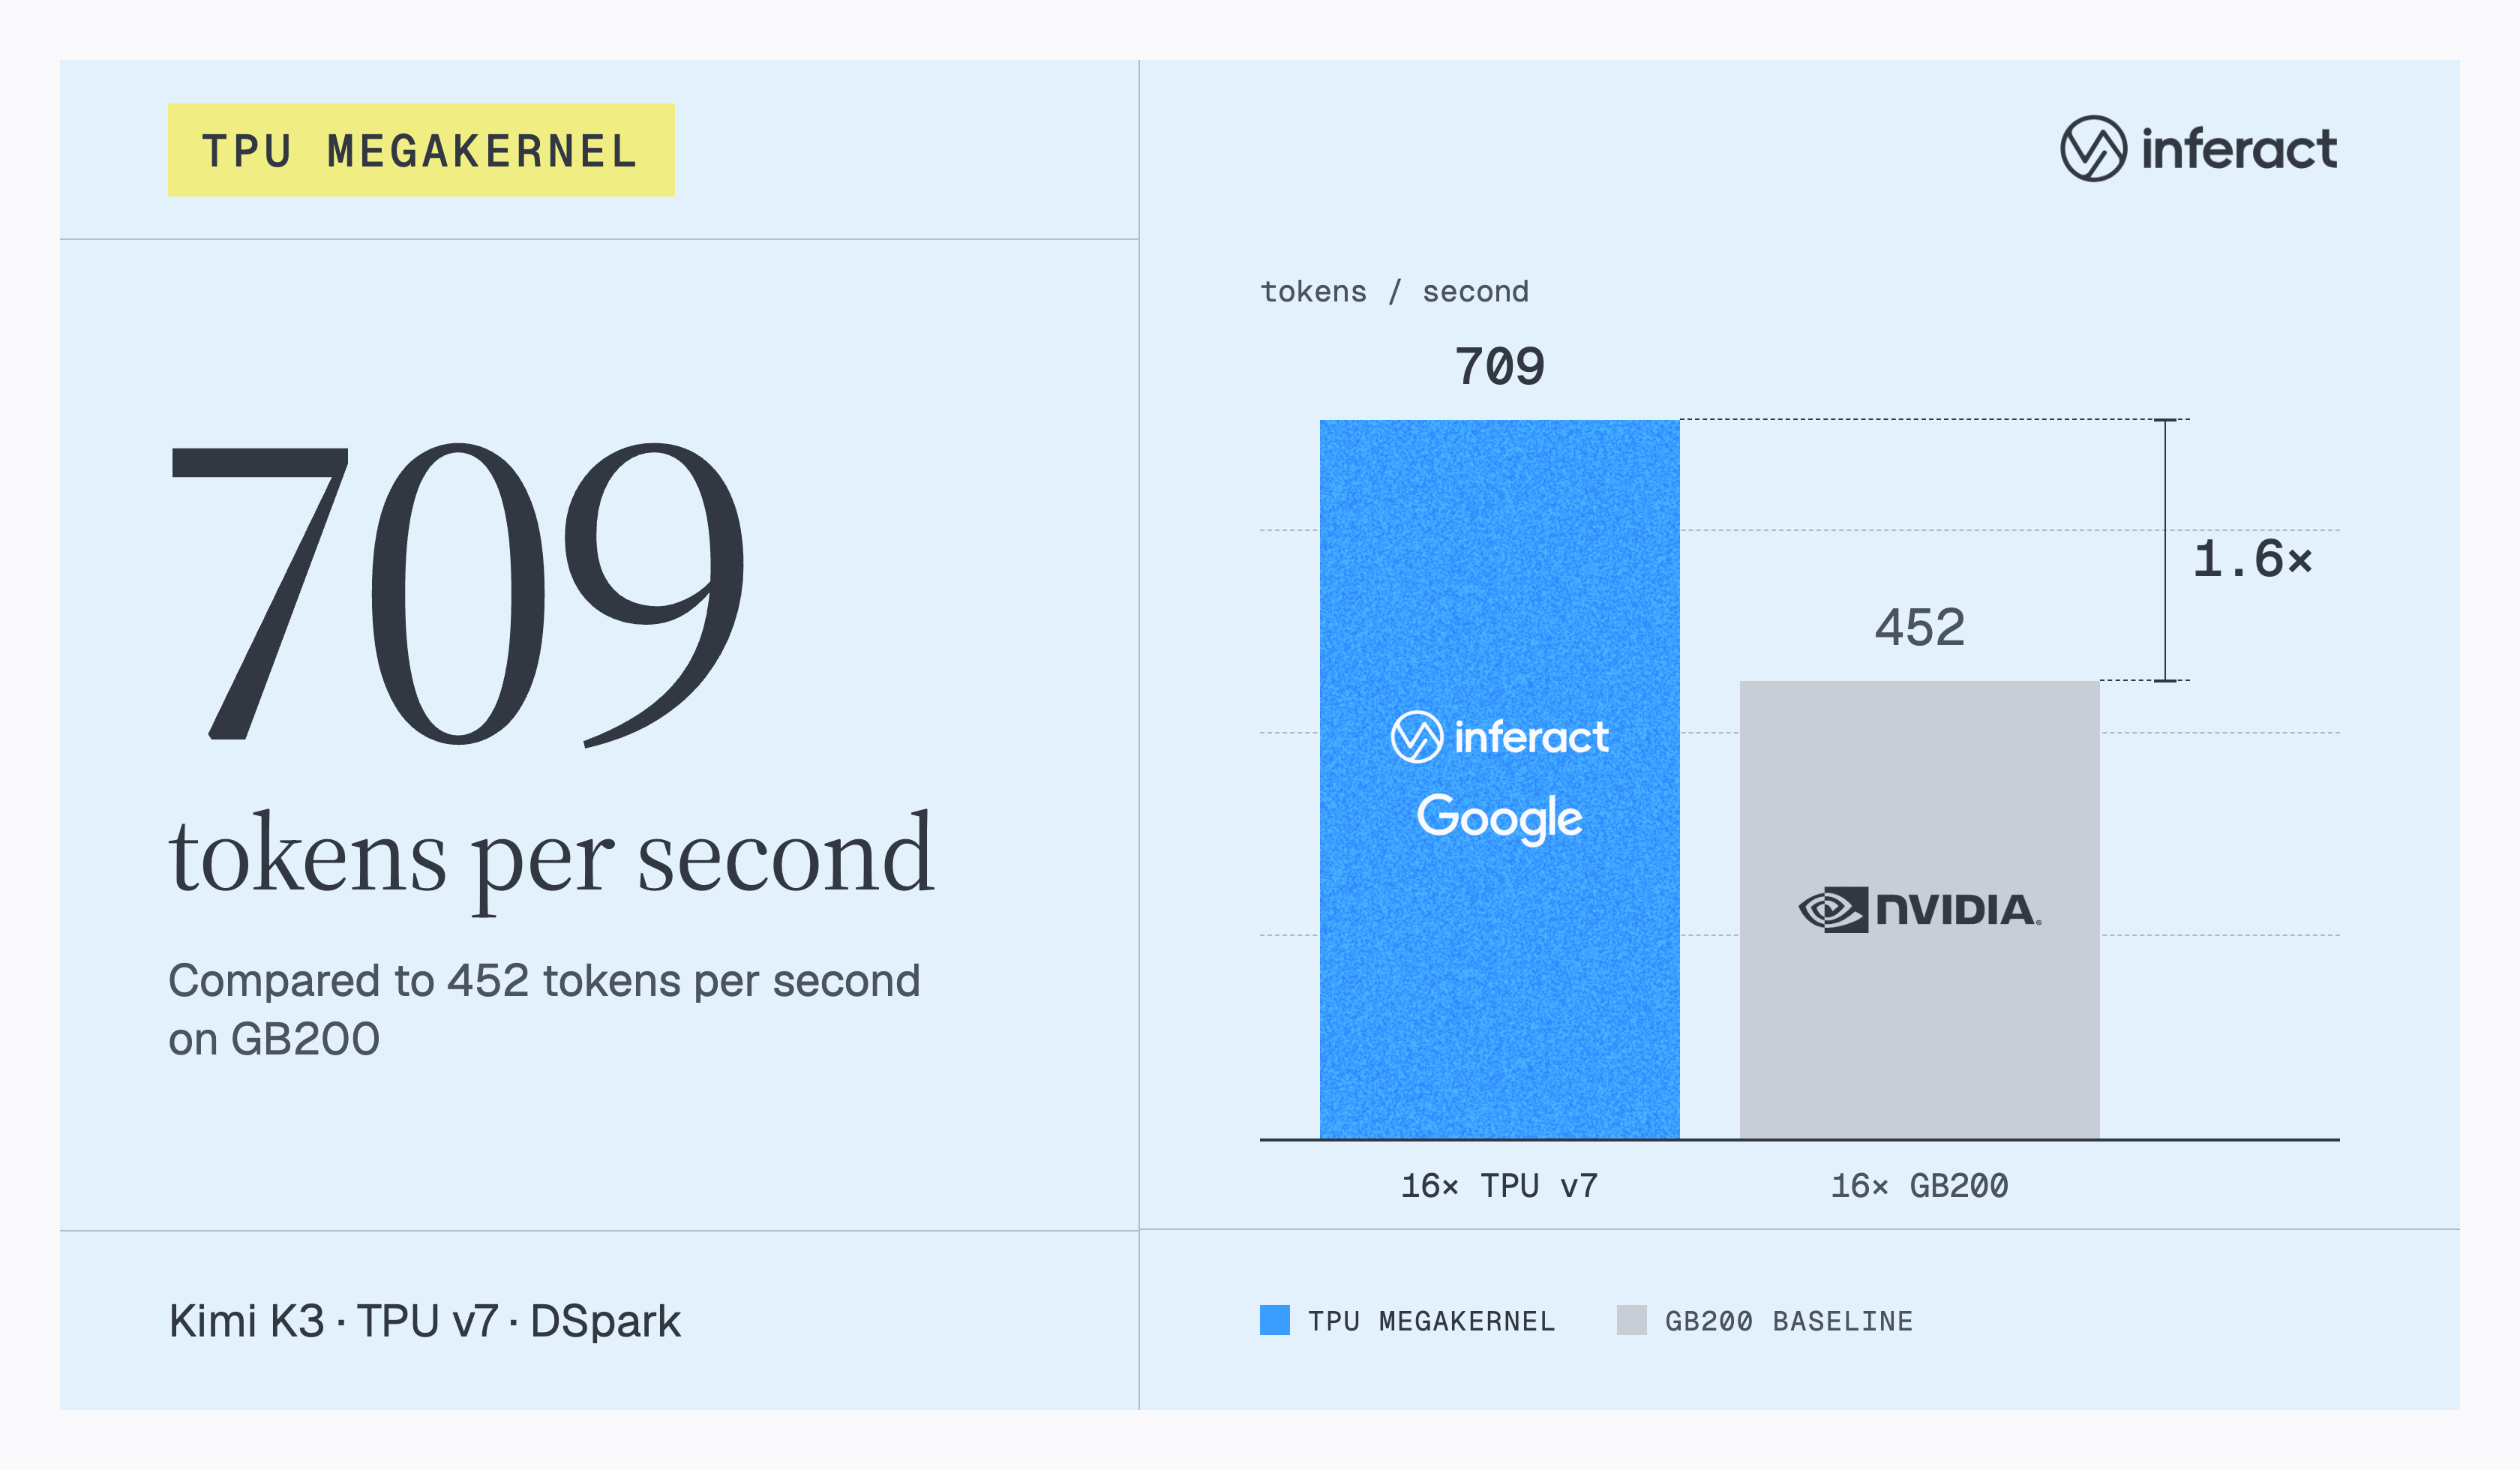
Inferact(vLLM 核心团队衍生公司)于 2026-09-23 发布并开源面向 TPU v7 的推理巨内核仓库 inferact/tpu-megakernels。官方博客显示,在 DSpark 推测解码(acceptance length=6)的低并发设定下,Kimi K3 在 16×TPU v7 Ironwood 上达到 709 tok/s,对照 16×GB200 基线 452 tok/s;关闭推测解码时,batch 1–8 约为 GB200 基线的 1.4–2×。整套 Kimi K3 的 92 层 MoE 解码被收敛进单一 Pallas 内核。

Inferact 开源 TPU Megakernel:Kimi K3 在 16×TPU v7 上跑出 709 tok/s,低并发反超 GB200

核心要点速览

  • 官方数字(Inferact 自测,非第三方复现):Kimi K3 + DSpark 在 16×TPU v7 上 709 tok/s,对照 16×GB200 452 tok/s(acceptance length=6)
  • 关闭推测解码时,batch 1–8 约为 GB200 基线的 1.4–2×;Qwen 3.8 27B 在 4×TPU v7 上报 1,515 tok/s vs 4×GB200 695 tok/s(含推测解码)
  • 架构要点:92 层 MoE 装进 单一 Pallas 巨核,跨层 weight prefetch,吃满 TPU 大容量 VMEM
  • 开源仓库:Inferact/tpu-megakernels(Apache-2.0),配套深度文:700 TPS on Kimi K3
阅读全文
关联模型 / 智能体 / 厂商:

vLLM 0.28.0 正式发布:Kimi-K3 全栈优化、DeepSeek-V4 稀疏 MLA 与投机解码首 Token 提速 65%

开源高性能推理引擎 vLLM 发布 0.28.0 大版本。汇聚 270 位开发者的 584 次代码提交,包含 Kimi-K3 全栈融合算子、DeepSeek-V4 稀疏 MLA 端到端支持、自适应投机解码预算(TTFT 提升达 65%)以及 Model Runner V2 分离架构。

核心要点速览

  • 投机解码成为一等优化利器:集成 DFlash2 与 DSpark 置信度调度,使端到端首 Token 延迟缩短 55%–65%;
  • 国产顶尖架构首日原生支持:深度适配 Kimi-K3 与 DeepSeek-V4 稀疏多头注意力机制(MLA);
  • 硬件后端全面开花:包含 NVIDIA SM12x FlashInfer XQA、AMD ROCm 融合内核及 Intel XPU 适配。
阅读全文
关联模型 / 智能体 / 厂商:

vLLM 0.28.0 正式发布:Kimi-K3 全栈优化、DeepSeek-V4 稀疏 MLA 与分层磁盘 KV 缓存

高并发推理引擎 vLLM 迎来 0.28.0 重磅更新,汇总 270 位开发者的 584 项提交。全面优化 Kimi-K3 与 DeepSeek-V4 稀疏 MLA(覆盖 Decode、MTP 与 DSpark 推测解码),Model Runner V2 支持 E/P/D 分离与权重卸载,KV Cache 新增磁盘分层存储。

核心要点速览

  • 引入自适应推测 Token 预算机制,将端到端首字延迟(TTFT)大幅降低 55–65%;
  • DeepSeek-V4 稀疏 MLA 实现全链路打通,Kimi-K3 共享专家分片技术使单卡节省约 17 GiB 显存;
  • KV Cache 引入内存-磁盘分层架构,默认批处理 Token 限制倍增至 16384,全面支持跨硬件平台(NVIDIA、AMD、Intel XPU、CPU)。
阅读全文
关联模型 / 智能体 / 厂商: